
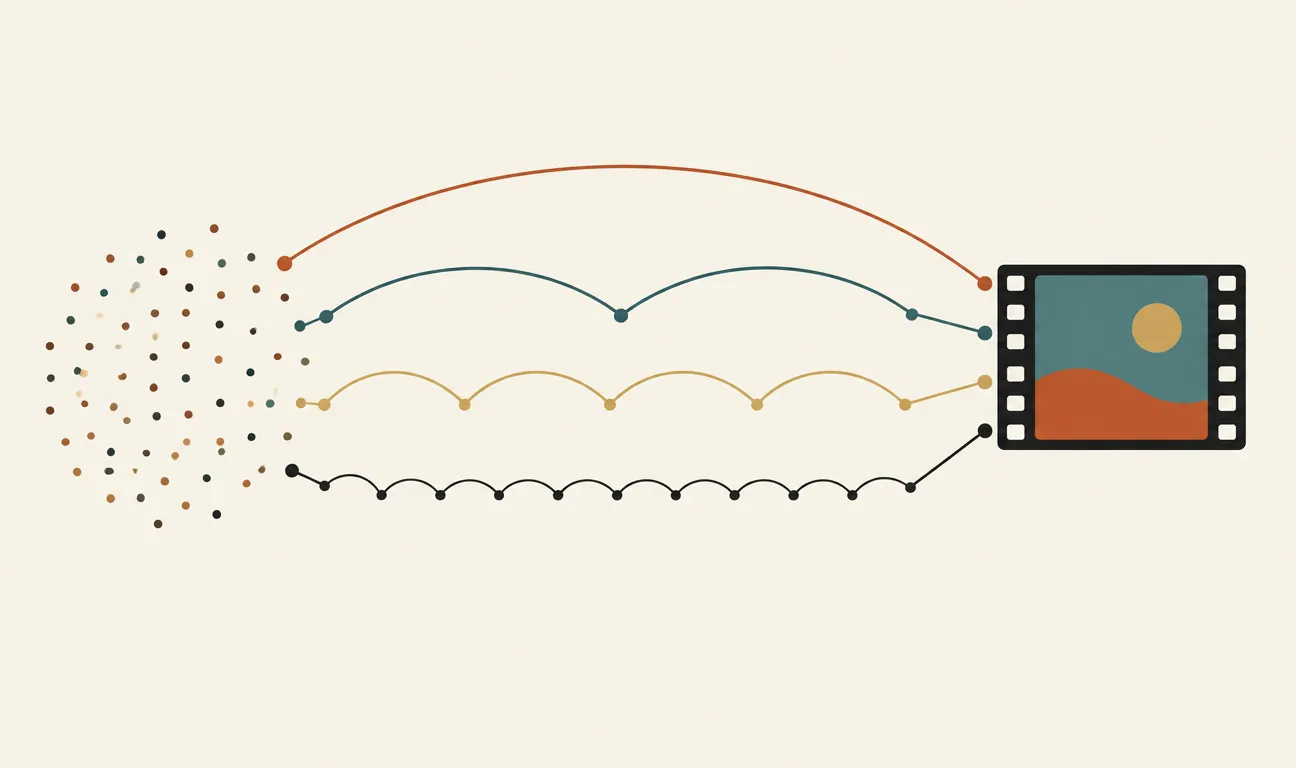
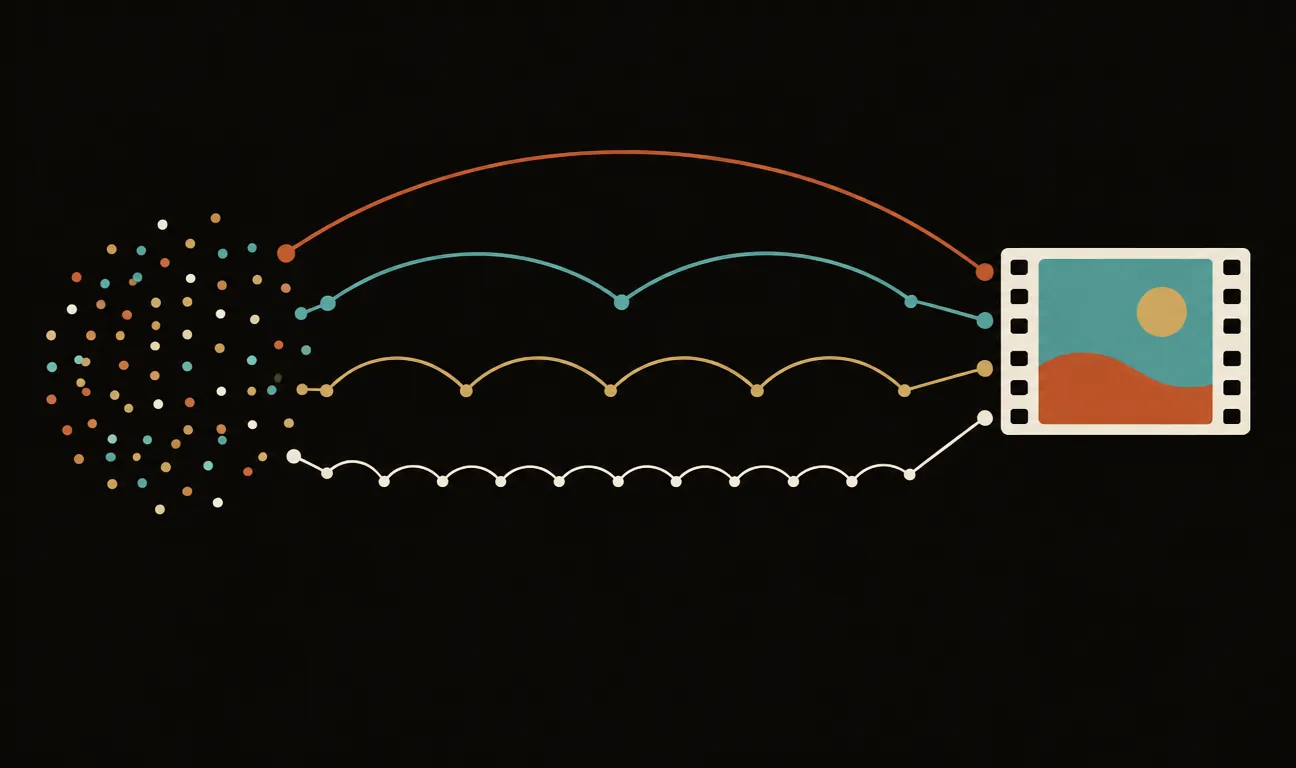
Due tassisti conoscono la stessa città in due modi diversi. Il primo sa una cosa sola: da qualunque punto, portarti in stazione. Se gli chiedi di fare tappa, lui a ogni tappa punta di nuovo alla stazione, poi qualcuno lo rimette per strada in un posto a caso a metà del percorso, e lui riparte da lì. Con due tappe se la cava; con venti, la corsa diventa un andirivieni. Il secondo tassista conosce invece ogni tratto: da piazza A a piazza B, da B a C. Se ha fretta taglia per le vie larghe, se ha tempo segue la strada vera curva per curva, e più tappe gli concedi, più il suo percorso somiglia a quello giusto.
È, trasportata nella generazione di video, la differenza su cui è costruito AnyFlow: Any-Step Video Diffusion Model with On-Policy Flow Map Distillation, uscito su arXiv il 13 maggio 2026 (2605.13724). Lo firmano Yuchao Gu, Guian Fang, Yuxin Jiang, Weijia Mao, Song Han, Han Cai e Mike Zheng Shou, fra NVIDIA, lo Show Lab della National University of Singapore e il MIT. Il codice è pubblico.
Il problema: più passi, video peggiori
Un modello di diffusione per il video genera partendo dal rumore e togliendolo un po’ alla volta: cinquanta passi, spesso raddoppiati dalla classifier-free guidance, che chiede due valutazioni della rete per passo. Per un modello da 14 miliardi di parametri e 81 fotogrammi è un costo che pesa, e da un paio d’anni la strada per abbatterlo è la distillazione: si addestra uno studente che fa in quattro passi quello che il maestro fa in cento valutazioni.
La maggior parte dei metodi recenti di distillazione video è costruita sui modelli di consistenza: rCM per i modelli bidirezionali, che generano tutto il clip insieme, e Self-Forcing per quelli causali, che lo generano a blocchi di fotogrammi, uno dopo l’altro. Imparano a saltare da qualunque livello di rumore direttamente al video pulito, e in pochi passi funzionano bene. Il guaio, mostrano gli autori, è che se a questi modelli si concedono più passi la qualità spesso non sale: scende. Lo si vede su VBench, il benchmark automatico che gli autori usano in tutto il paper.
| Modello distillato | Pochi passi | 32 passi |
|---|---|---|
| rCM, 1,3 miliardi, bidirezionale | 82,81 con 2 passi | 75,72 |
| Self-Forcing, causale | 83,40 con 4 passi | 82,24 |
Perché un modello di diffusione si può comprimere in pochi passi, che cosa impara un modello di consistenza e che cosa si perde nel farlo: la distillazione dei generatori è ricostruita nel libro, qui la si dà per nota.
La spiegazione che ne danno gli autori è quella del primo tassista. Un modello di consistenza, per fare più passi, a ogni passo proietta sul video finito e poi lo sporca di nuovo con rumore fresco per tornare a un livello intermedio. Quel rumore reintrodotto non sta sulla traiettoria che il modello originale avrebbe percorso, e ogni passo in più allontana un po’ di più il percorso dalla strada giusta. In pratica, chi usa questi modelli deve scegliere una volta per tutte: veloce oppure buono. Chi vuole un’anteprima rapida e poi la versione definitiva, il caso d’uso da cui il paper parte, finisce per tenersi due modelli.
Che cosa cambia AnyFlow: si distilla il tratto, non l’arrivo
La proposta è fare dello studente il secondo tassista. Invece di imparare il salto da un istante $t$ al video pulito, impara una mappa di flusso a due tempi: dal punto in cui si trova all’istante $t$ al punto in cui dovrebbe essere a un istante $r$ qualsiasi, più vicino al video.
$$f_\theta(z_t, t, r) \approx z_r, \qquad 1 \ge t > r \ge 0$$
Con $r = 0$ si ritrova il modello di consistenza; con $r$ attaccato a $t$ si ritrova il flow matching ordinario, la velocità istantanea. In mezzo c’è tutto il resto: salti lunghi quando si ha fretta, passi corti quando si ha tempo, sempre lungo la stessa traiettoria. Per l’addestramento gli autori partono da MeanFlow, che scrive la mappa come $f_\theta(z_t,t,r) = z_t – (t-r)\,u_\theta(z_t,r,t)$, con $u_\theta$ la velocità media sul tratto, e ne stimano la derivata con una differenza finita invece che con il prodotto jacobiano-vettore, costoso e poco compatibile con l’addestramento distribuito su più schede (FSDP).
Che cosa sia la traiettoria che collega rumore e dati, perché la si può scrivere come un’equazione differenziale e come il flow matching impara a percorrerla: il fondamento di tutto questo articolo sta nel capitolo del libro.
Convertire un modello già addestrato, Wan2.1, in una mappa di flusso ha richiesto qualche accorgimento. Il più istruttivo riguarda il secondo tempo $r$, che il modello originale non conosceva. La soluzione di un lavoro concorrente, TMD, aggiunge un nuovo embedding per $r$ con l’ultimo strato inizializzato a zero; nei loro esperimenti questo fa crescere la norma dell’embedding durante l’addestramento e produce video sovrasaturi. AnyFlow mescola invece i due tempi, $0{,}25 \cdot \mathrm{emb}(t) + 0{,}75 \cdot \mathrm{emb}'(r)$, con il nuovo embedding copiato da quello vecchio: all’inizio, quando $t = r$, il modello vede esattamente ciò che conosceva. La guida senza classificatore viene incorporata nel modello, così a inferenza non serve più la doppia valutazione per passo.
La seconda tappa: allenarsi sulle proprie corse
La mappa di flusso da sola non basta. In pochi passi resta l’errore di discretizzazione; nei modelli causali resta l’exposure bias, lo scarto fra i fotogrammi veri visti in addestramento e quelli, imperfetti, che il modello si ritrova a continuare quando genera da solo. La cura, ormai standard, è la distillazione on-policy: lo studente genera un video con i propri passi e un maestro giudica il risultato, con un obiettivo di distribution matching (DMD) che confronta la distribuzione dello studente con quella del maestro.
Il punto delicato è simulare le corse dello studente a costo ragionevole, per numeri di passi diversi. Qui entra la proprietà di composizione delle mappe di flusso: due tratti consecutivi valgono un tratto unico.
$$f_\theta(z_t, t, q) \approx f_\theta\big(f_\theta(z_t, t, r),\, r,\, q\big), \qquad t > r > q$$
Gli autori la usano al contrario, come scorciatoia. Per simulare un campionamento in $N$ passi non lo percorrono tutto: scelgono un tratto $t \to r$ lungo $T/N$, ci arrivano dal rumore con un solo salto, lo percorrono, e dal suo termine saltano al video finito con un altro salto. Tre valutazioni, qualunque sia $N$, e il gradiente attraversa tutta la catena. Variando $N$ durante l’addestramento, lo stesso modello impara a comportarsi bene con budget diversi; a inferenza basta un normale integratore di Euler con il numero di passi che si preferisce.
I numeri
Le curve del confronto principale fanno esattamente ciò che la teoria promette. Sulla versione bidirezionale da 1,3 miliardi, AnyFlow sale in modo monotono: 82,92 con 2 passi, 83,96 con 32. Il maestro non distillato, con pochi passi, crolla (62,65 con 2 passi) e risale a 83,41 solo con 32.
Sui modelli grandi, dove si gioca il confronto che conta, i margini sono più stretti. Il maestro è Wan2.1 da 14 miliardi. Nel causale la variante si chiama AnyFlow-FAR, perché è costruita sulla pipeline FAR, che tiene tre blocchi di contesto a piena risoluzione e comprime gli altri, per contenere costo e memoria. Un solo modello causale copre testo-a-video, immagine-a-video e video-a-video, quest’ultimo senza numeri.
| Modello | Passi | Punteggio |
|---|---|---|
| Bidirezionale, testo-a-video | ||
| AnyFlow | 4 | 84,04 |
| rCM | 4 | 83,73 |
| Wan2.1, il maestro, con guida | 50 | 83,74 |
| Causale, testo-a-video | ||
| AnyFlow-FAR | 4 | 84,05 |
| AnyFlow-FAR | 32 | 84,41 |
| Krea-Realtime-14B | 4 | 83,25 |
| Immagine-a-video | ||
| AnyFlow-FAR | 4 | 87,87 |
| Wan2.1-I2V-14B | 50 raddoppiati | 87,71 |
L’ablazione, sul modello da 1,3 miliardi, separa i due ingredienti. La mappa di flusso da sola batte già il flow matching in pochi passi: 81,75 contro 74,64 sul bidirezionale con 4 passi, il secondo con la guida. Aggiungerle la distillazione on-policy con la simulazione classica per consistenza alza il risultato con 4 passi a 83,55, persino un soffio sopra la versione finale; ma sul bidirezionale con 32 passi lo fa scendere a 82,96. La combinazione proposta tiene entrambi gli estremi: 83,48 con 4 passi, 83,96 con 32.
C’è poi il costo dell’addestramento, che gli autori misurano sul modello da 1,3 miliardi, su un nodo con otto H100. Con pochi passi la loro simulazione costa di più di quella per consistenza, perché il gradiente attraversa tutta la catena; con molti passi le scorciatoie ribaltano i conti.
| Passi | Causale | Bidirezionale |
|---|---|---|
| 4 | +15,7% | +22,5% |
| 16 | −43,4% | −47,0% |
L’addestramento è contenuto per un modello video: LoRA di rango 256, 6.000 iterazioni nella prima fase (4.000 per il modello da 14 miliardi) e 800 nella seconda, su 256.000 coppie testo-video sintetiche generate dallo stesso Wan2.1 da 14 miliardi.
I limiti
Il primo lo dichiarano gli autori: la mappa di flusso si addestra su dati esterni al modello di partenza, sintetici ma pur sempre diversi, e questo introduce un lieve spostamento di distribuzione, con texture più lisce. Lo si curerebbe con i dati originali di pre-addestramento, a cui per Wan gli autori non hanno accesso.
Gli altri li deve aggiungere il lettore. Tutti i numeri sono VBench, una metrica automatica, e senza uno studio con valutatori umani; i confronti qualitativi (concorrenti sfocati, con sfarfallii o movimenti poco realistici) sono giudizi degli autori su clip scelti da loro. Molti concorrenti sono stati rivalutati dagli autori stessi con un protocollo unificato, il che rende i confronti più omogenei ma li mette tutti nelle stesse mani. Sui modelli da 14 miliardi i vantaggi in pochi passi sono piccoli: tre decimi di punto sul bidirezionale, meno di due in immagine-a-video, otto nel causale contro Krea; e il paper non riporta ripetizioni né intervalli di confidenza che dicano quanto di quello scarto sia rumore. E i passi sono una misura indiretta: il paper conta le valutazioni della rete, non i secondi per clip su una scheda reale. Infine, la promessa di poter continuare ad addestrare il modello distillato su domini nuovi (videogiochi, robotica, guida autonoma) è mostrata con esempi visivi, non misurata.
Perché conta adesso
La generazione video sta passando dal «guarda che cosa sa fare» al lavoro quotidiano, e il lavoro quotidiano ha due ritmi: provare in fretta e consegnare con cura. Fin qui la distillazione costringeva a scegliere il ritmo al momento dell’addestramento. AnyFlow sposta la scelta a chi usa il modello, con una manopola sola. Il salto di qualità, sui modelli grandi, è modesto; ciò che cambia è la forma della curva. Un modello che non peggiora quando gli si dà più tempo toglie una trappola a chi lo usa: più calcolo torna a voler dire, come nel maestro, un video migliore.
I commenti sono riservati agli iscritti.
Accedi per commentare