
Chiedete a qualcuno di descrivervi un volto al telefono. Non vi elencherà i pixel: vi dirà «occhi scuri, naso pronunciato, sorride». In tre indizi ha compresso un’immagine da milioni di valori, e voi, dall’altra parte, siete in grado di ricostruirvene una versione mentale piuttosto fedele. Questo scambio — comprimere in pochi tratti essenziali, poi ricostruire — è esattamente quello che fa un autoencoder. E il punto interessante non è la ricostruzione: è quello che la rete è costretta a imparare per riuscirci.
La strozzatura come compito, la clessidra che coincide con la PCA e perché comprimere non basta: nel libro.
Leggi «Comprimere e ricostruire, e perché non basta» nel libro →
Un compito apparentemente assurdo
Un autoencoder è una rete neurale addestrata a fare una cosa che sembra priva di senso: restituire in output il proprio input. Le si dà un’immagine, deve produrre la stessa immagine. La funzione di perdita misura la differenza tra originale e ricostruzione — tipicamente l’errore quadratico medio sui pixel — e l’addestramento la minimizza.
Se la rete potesse copiare l’input, il compito sarebbe banale e non si imparerebbe nulla. Il trucco sta nell’impedirglielo: tra l’ingresso e l’uscita c’è una strettoia, il bottleneck, uno strato con molte meno dimensioni dei dati originali. Un’immagine di 784 pixel (il classico 28×28 di MNIST) può essere costretta a passare per un vettore di 32 numeri. La rete deve decidere quali 32 numeri riassumono meglio l’immagine, perché da quelli — e solo da quelli — dovrà ricostruire tutto.
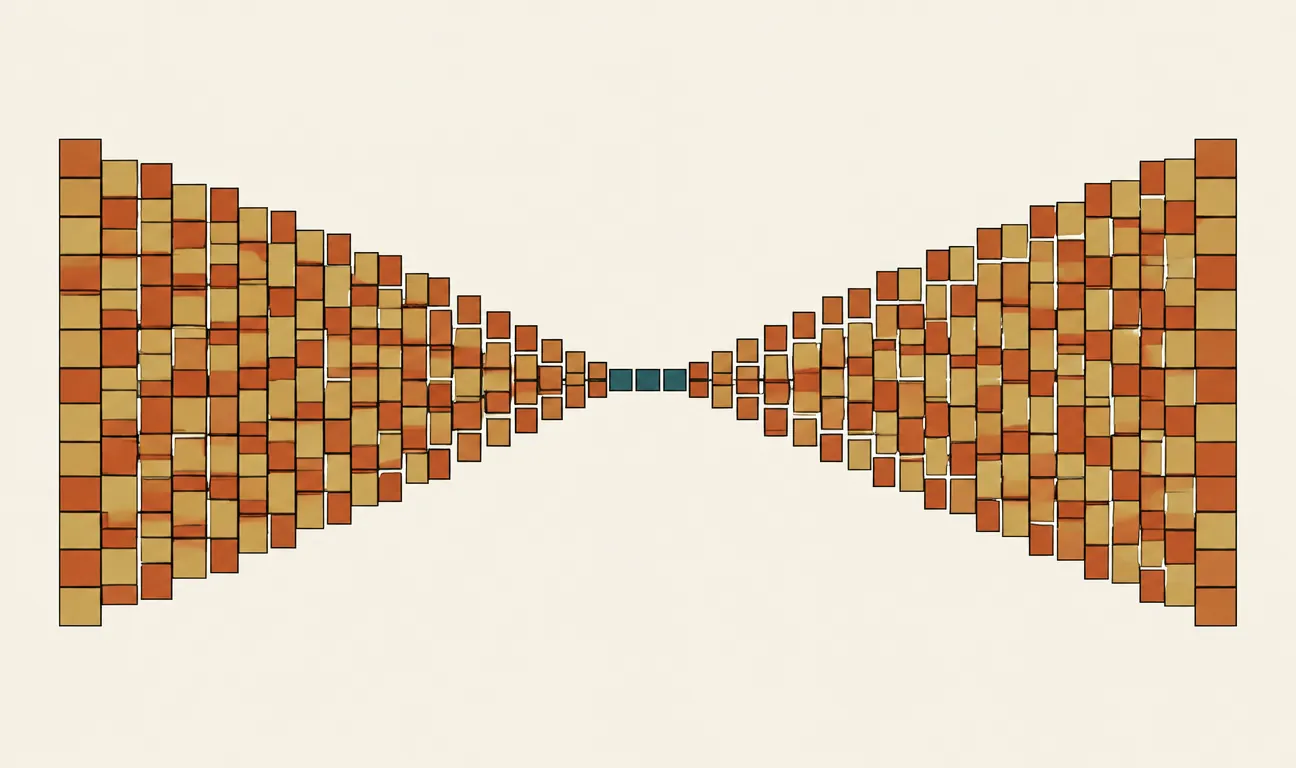
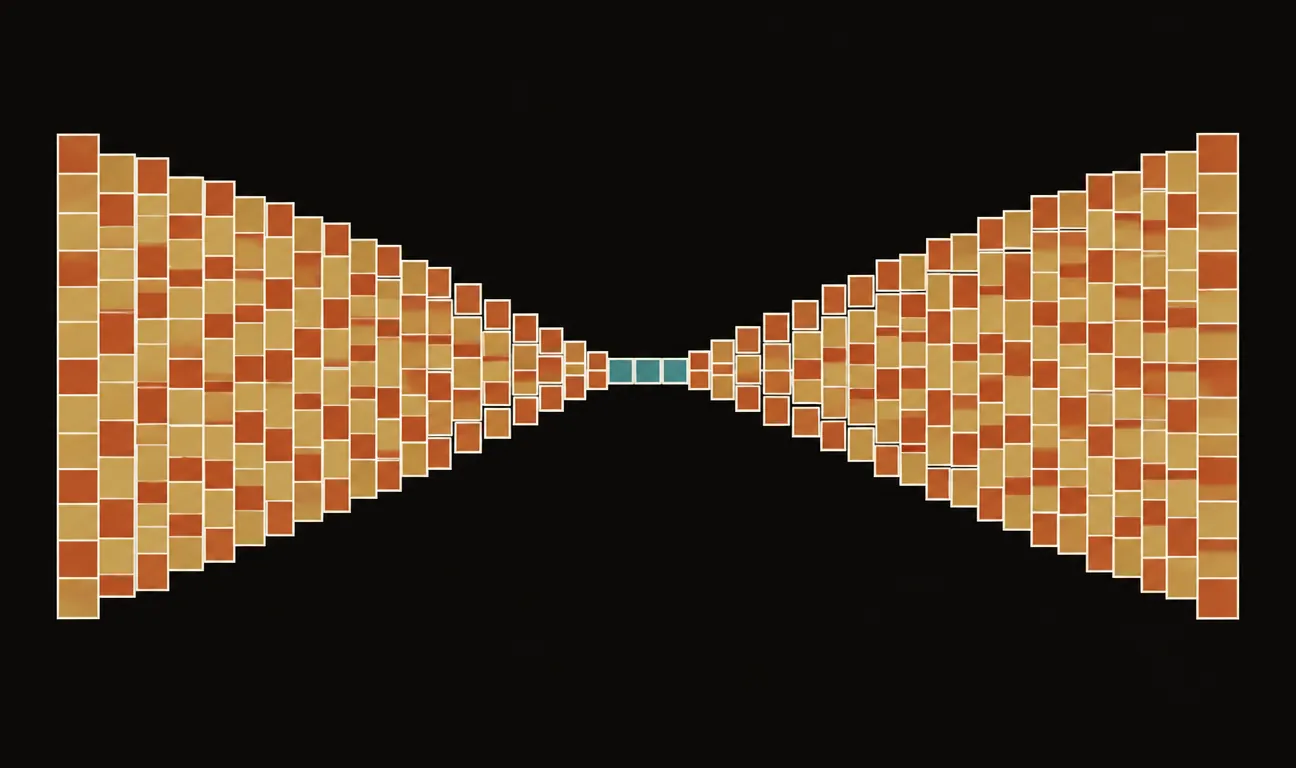
L’architettura ha quindi due metà. L’encoder comprime: strato dopo strato, riduce le dimensioni fino al bottleneck. Il decoder fa il percorso inverso: dal vettore compresso risale fino alle dimensioni originali. Disegnata, la rete ha la forma di una clessidra.
La clessidra dell’autoencoder: l’encoder (teal) comprime l’input nello spazio latente z (ocra), il decoder (terracotta) ricostruisce. L’addestramento minimizza la distanza tra originale e ricostruzione.
Lo spazio latente è il vero prodotto
Dopo l’addestramento, il decoder si può anche buttare via. Il valore sta nel vettore al centro della clessidra: la rappresentazione latente. Per ricostruire bene migliaia di cifre scritte a mano con soli 32 numeri, la rete non può memorizzare pixel: deve scoprire regolarità. Che i tratti sono continui, che uno zero è un anello, che un sette ha un’asta obliqua. In altre parole, deve costruirsi una nozione implicita di struttura dei dati.
La compressione non è il fine: è la pressione selettiva. Come un riassunto da dieci righe, che riesce solo a chi ha capito il testo.
Questo è il motivo per cui gli autoencoder sono un capitolo fondativo del representation learning: sono uno dei modi più diretti per imparare rappresentazioni utili senza etichette. Nessuno dice alla rete cos’è uno zero o un sette. L’unica supervisione è il dato stesso — per questo si parla di apprendimento auto-supervisionato ante litteram.
Non è (solo) compressione: il confronto con ZIP
Viene naturale il paragone con un algoritmo di compressione classico, ma il confronto illumina proprio le differenze. ZIP è generico e senza perdita: comprime qualsiasi file e lo restituisce identico al bit. Un autoencoder è specializzato e con perdita: comprime bene solo dati simili a quelli su cui è stato addestrato, e la ricostruzione è un’approssimazione.
È la differenza tra uno stenografo e un esperto d’arte. Lo stenografo trascrive qualsiasi discorso, parola per parola. L’esperto d’arte, davanti a un quadro del suo periodo, lo descrive in poche frasi dense («un caravaggismo tardo, luce da sinistra, composizione a diagonale») — ma davanti a una radiografia non saprebbe che dire. La specializzazione è il prezzo, e insieme la fonte, della qualità della sintesi.
Questa proprietà ha un rovescio utilissimo: se l’autoencoder ricostruisce male un input, quell’input probabilmente non assomiglia ai dati di addestramento. L’errore di ricostruzione diventa un rilevatore di anomalie: transazioni fraudolente in mezzo a quelle legittime, vibrazioni anomale in un macchinario, pacchetti sospetti nel traffico di rete. È una delle applicazioni industriali più solide e longeve di questa architettura.
Le varianti che contano
L’idea base ha generato una famiglia numerosa. Tre membri meritano una menzione.
- Il denoising autoencoder riceve in input una versione corrotta del dato (pixel spenti, rumore aggiunto) e deve ricostruire l’originale pulito. Non potendo più limitarsi a copiare, è costretto a imparare la struttura che permette di «indovinare» le parti mancanti. Se la variante base è uno studente che ricopia gli appunti, il denoising è uno studente che li ricostruisce da fotocopie macchiate: deve capire il contenuto.
- Lo sparse autoencoder non restringe le dimensioni ma penalizza le attivazioni: il bottleneck può anche essere largo, purché per ogni input si accendano pochi neuroni. Curiosamente, questa variante è tornata al centro della scena nella ricerca sull’interpretabilità dei grandi modelli linguistici, dove viene usata per scomporre le attivazioni interne in feature leggibili.
- Il variational autoencoder (VAE) trasforma lo spazio latente da archivio a spazio generativo: invece di un punto, l’encoder produce una distribuzione da cui campionare. È il ponte tra compressione e generazione, e merita un articolo a sé.
L’eredità concettuale
Gli autoencoder puri non sono più al centro della scena generativa — modelli di diffusione e Transformer hanno preso quel posto. Ma il loro DNA è ovunque. I modelli di diffusione più usati per generare immagini operano in uno spazio latente costruito, appunto, da un autoencoder: comprimere prima di generare rende il calcolo trattabile. E il principio pedagogico — impara riempiendo i buchi di dati resi incompleti — è la stessa logica con cui vengono pre-addestrati i modelli linguistici mascherati come BERT.
C’è anche una lettura più filosofica, che in ricerca si prende sul serio: comprimere bene richiede capire. Una sintesi efficace di un fenomeno è possibile solo se se ne colgono le regolarità profonde. In questo senso l’autoencoder è la versione più nuda di un’ipotesi che attraversa tutto il machine learning contemporaneo: l’intelligenza, o almeno una sua parte, è compressione riuscita.
Perché vi riguarda
Se lavorate con dati ad alta dimensionalità — immagini, log, segnali, embedding — l’autoencoder è uno strumento pratico da tenere in cassetta: riduzione di dimensionalità non lineare più potente della PCA, rilevamento di anomalie senza bisogno di esempi etichettati di frode o guasto, pre-training quando le etichette scarseggiano. E se vi interessa capire dove va l’AI, la clessidra è una lente utile: molte delle architetture di cui si parla oggi, dai VAE dentro i generatori di immagini agli sparse autoencoder usati per aprire la scatola nera degli LLM, sono variazioni su questo tema. Comprimere per capire, appunto.
I commenti sono riservati agli iscritti.
Accedi per commentare