
Sergey Ioffe e Christian Szegedy, allora ricercatori di Google, misero online nel febbraio 2015 un articolo con una promessa insolitamente misurabile: la loro tecnica permetteva di raggiungere la stessa accuratezza di prima usando circa quattordici volte meno passi di addestramento. Non un’accuratezza migliore, badiamo — lo stesso traguardo, ma raggiunto molto prima e con molta meno pazienza. In un campo dove far convergere una rete profonda era ancora mezza scienza e mezza superstizione, un numero del genere valeva più di mille parole. La tecnica si chiama Batch Normalization, ed è finita dentro praticamente ogni rete addestrata nel decennio successivo.
Segnale che svanisce o esplode, inizializzazione, batch normalization, dropout e gli ottimizzatori: il capitolo è nel libro.
Il problema: un bersaglio che si sposta
Per capire cosa risolve, immaginiamo una rete profonda come una catena di montaggio lunga decine di stazioni. Ogni strato riceve i «pezzi» lavorati dallo strato precedente, ci fa la sua trasformazione e passa il risultato al successivo. Durante l’addestramento, però, ogni strato cambia continuamente: i suoi pesi vengono aggiornati a ogni passo. E qui nasce il guaio. Se lo strato numero 5 modifica il suo comportamento, i numeri che arrivano allo strato 6 cambiano di scala e di posizione — non solo una volta, ma di continuo, per tutto l’addestramento.
Ogni strato, in altre parole, deve imparare il proprio compito mentre il terreno sotto i suoi piedi si muove. È come insegnare a un tiratore a centrare un bersaglio che qualcuno sposta a ogni tiro: anche quando la mira è giusta, il colpo va storto perché il bersaglio non è più dove era un attimo prima. Ioffe e Szegedy diedero a questo fenomeno un nome che sarebbe diventato famoso: internal covariate shift, lo spostamento interno delle distribuzioni. La loro tesi: se le attivazioni che ogni strato riceve cambiassero di meno, tutta la catena imparerebbe più in fretta.
La ricetta: azzerare e riscalare, batch per batch
La soluzione è tanto pragmatica quanto diretta. Prima che le attivazioni passino allo strato successivo, si inserisce una stazione di controllo qualità che le rimette in ordine. Per ogni mini-batch di esempi — il gruppetto di dati su cui si calcola un passo di addestramento — si misurano la media e la varianza delle attivazioni, poi le si standardizza: si sottrae la media e si divide per la deviazione standard. Il risultato è un flusso di numeri centrato attorno allo zero e con una dispersione unitaria, sempre, a prescindere da cosa combinino gli strati a monte. Lo strato successivo riceve così input su una scala familiare, invece di dover rincorrere un bersaglio mobile.
C’è però un rischio: obbligare ogni strato a lavorare sempre con media zero e varianza uno è una camicia di forza. E se alla rete servisse davvero, in un certo punto, una distribuzione spostata o più larga? Qui sta la finezza del paper. Dopo la standardizzazione, Batch Normalization applica due parametri imparabili per ogni canale: uno di scala (γ, gamma) e uno di traslazione (β, beta). La rete può usarli per ri-allargare e ri-spostare le attivazioni a piacere — persino per annullare completamente la normalizzazione, se questo è ciò che le conviene. La standardizzazione non è un vincolo imposto dall’alto: è un azzeramento che la rete è libera di correggere dove ha senso.
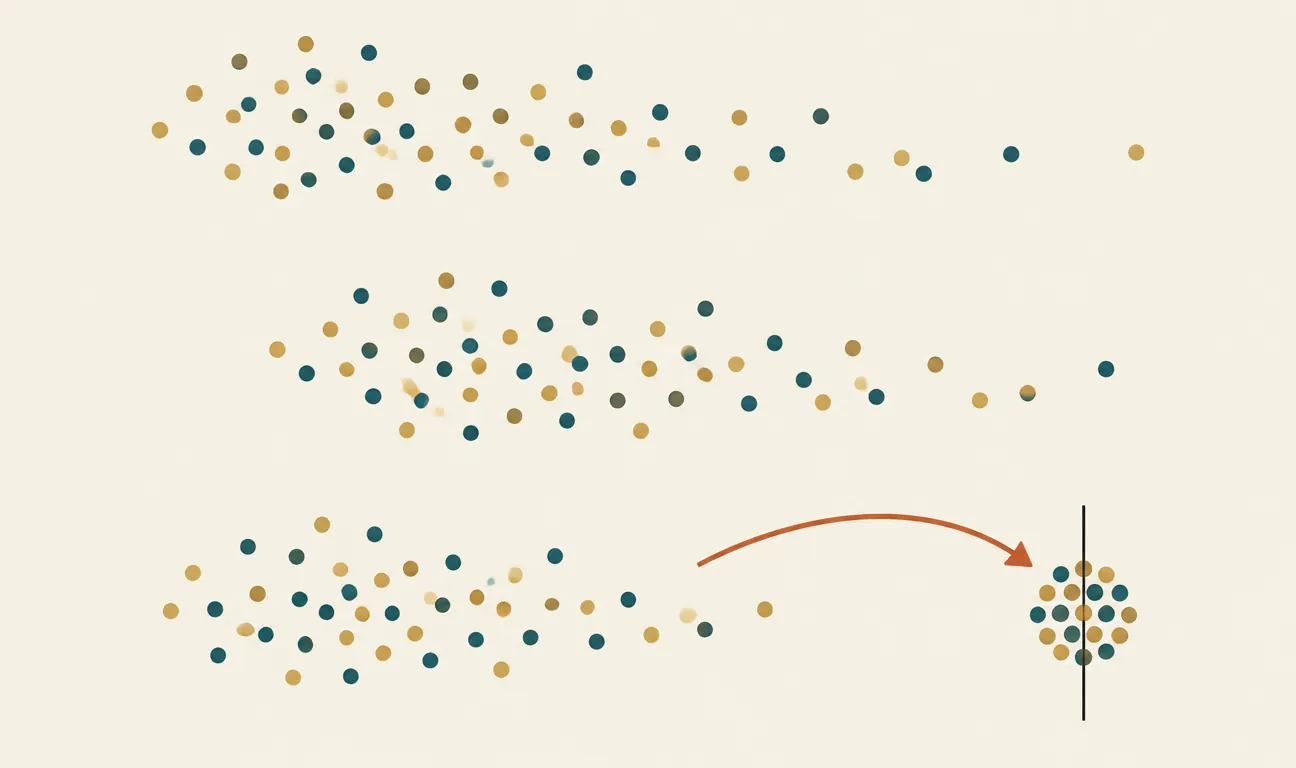
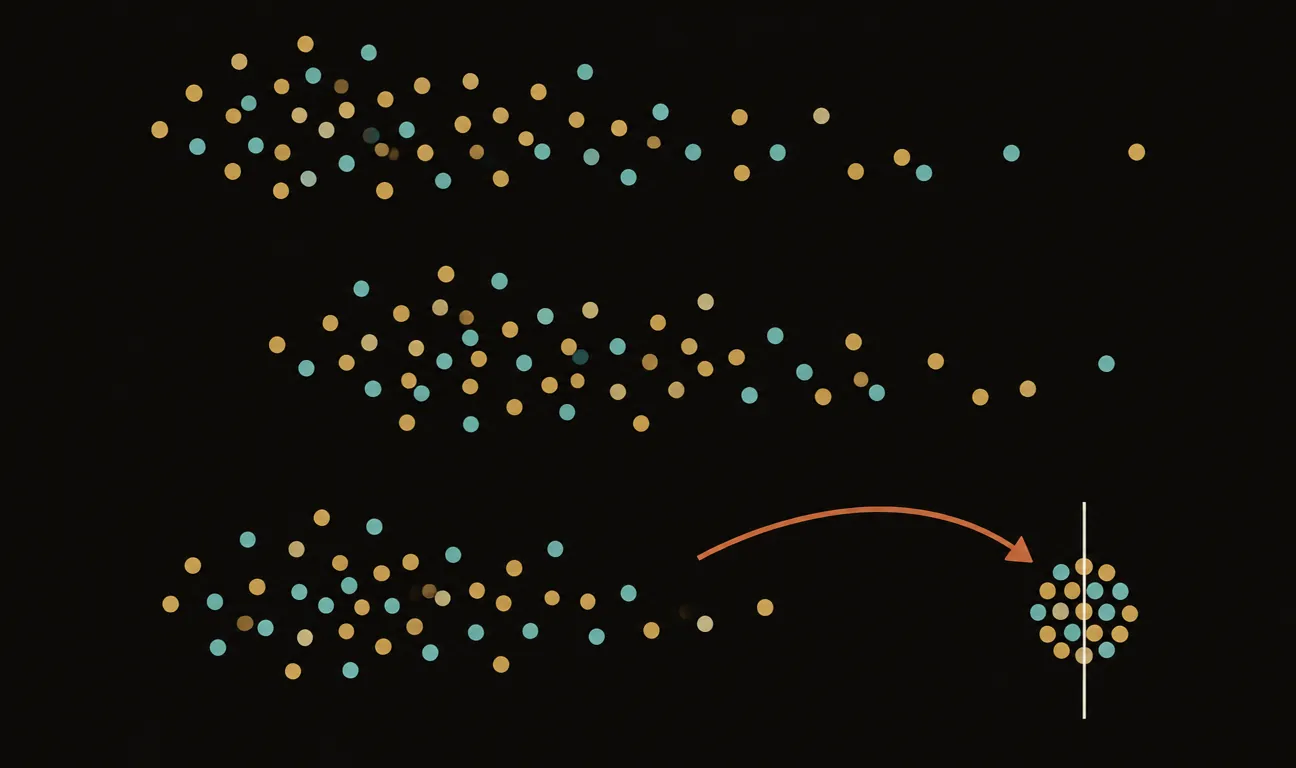
A sinistra, prima di Batch Normalization, le attivazioni arrivano a ogni strato con media e larghezza che cambiano di continuo (curve grigie). La normalizzazione le riporta tutte centrate sullo zero con dispersione unitaria (curva teal); i parametri imparabili γ e β possono poi riscalarle e rispostarle dove alla rete conviene davvero (curva terracotta).
I vantaggi collaterali che nessuno si aspettava
Il paper non si limita a rivendicare un addestramento più rapido. Batch Normalization porta con sé una serie di effetti secondari graditi. Il primo è che si possono usare learning rate molto più alti: con le attivazioni tenute a bada, i passi grandi non fanno più esplodere l’addestramento come prima. Il secondo è che la rete diventa meno sensibile a come vengono inizializzati i pesi — un altro punto in cui, fino ad allora, si procedeva per tentativi. Il terzo, quasi un regalo, è un lieve effetto di regolarizzazione: poiché media e varianza vengono calcolate su un mini-batch casuale, ogni esempio viene normalizzato con statistiche leggermente diverse a seconda dei compagni con cui capita nel batch. Questo rumore controllato agisce come una piccola vaccinazione contro l’overfitting, tanto che gli autori riducono l’uso del dropout.
C’è un dettaglio operativo importante. Durante l’addestramento la normalizzazione usa le statistiche del batch corrente, ma al momento dell’uso reale — quando classifichi una singola immagine, non un gruppo — un «batch» non c’è. La soluzione è tenere durante l’addestramento una media mobile di medie e varianze, e usare quelle a regime. È il motivo per cui una rete con Batch Normalization si comporta in modo sottilmente diverso in addestramento e in produzione: un tranello classico per chi dimentica di mettere il modello in modalità di valutazione.
La spiegazione ufficiale era probabilmente sbagliata
Qui la storia diventa istruttiva, e va raccontata per intero. Batch Normalization funziona: su questo non ci sono dubbi, e la sua adozione universale lo dimostra. Ma la ragione proposta nel paper — la riduzione dell’internal covariate shift — si è rivelata probabilmente non essere quella giusta. Nel 2018 un gruppo del MIT (Shibani Santurkar, Dimitris Tsipras, Andrew Ilyas e Aleksander Mądry, in How Does Batch Normalization Help Optimization?) mostrò con esperimenti mirati che si poteva persino aumentare di proposito lo spostamento delle distribuzioni dopo la normalizzazione e la rete continuava ad addestrarsi bene. La loro spiegazione alternativa: Batch Normalization rende la superficie della funzione di costo più liscia, meno accidentata, e quindi più facile da percorrere per la discesa del gradiente.
Batch Normalization è un caso raro e onesto in cui la comunità ha adottato uno strumento perché funzionava, salvo scoprire anni dopo che il motivo per cui pensava funzionasse era sbagliato.
È una lezione che vale oltre il singolo metodo. In una disciplina giovane come il deep learning, capita spesso che la pratica corra davanti alla teoria: si trova qualcosa che funziona, gli si appiccica una storia plausibile, e solo dopo — a volte molto dopo — si verifica se quella storia regge. Non è un difetto da nascondere, è il modo in cui il campo procede davvero.
Perché ti riguarda
Se addestri modelli, Batch Normalization è probabilmente già dentro le architetture di visione che usi, e conoscerne i due tranelli — la dipendenza dal batch e la differenza tra addestramento e uso reale — ti risparmia bug difficili da diagnosticare. Ma la ricaduta più ampia è un’altra. Il principio «normalizza le attivazioni dentro la rete» ha generato una famiglia intera: Layer Normalization, che non dipende dal mini-batch, è oggi il mattone che sta dentro ogni Transformer, e quindi dentro ogni grande modello linguistico che scrivi o interroghi. Quando leggi che un modello usa «normalizzazione» tra i suoi strati, stai leggendo la discendenza diretta di quel paper del 2015 — l’idea che una rete profonda impara meglio se, a ogni stazione, qualcuno rimette i pezzi su una scala prevedibile.
Il paper
Sergey Ioffe, Christian Szegedy, Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift, presentato a ICML 2015. Disponibile su arXiv: arxiv.org/abs/1502.03167. La revisione critica sul perché funzioni davvero è Shibani Santurkar, Dimitris Tsipras, Andrew Ilyas, Aleksander Mądry, How Does Batch Normalization Help Optimization?, NeurIPS 2018: arxiv.org/abs/1805.11604.
I commenti sono riservati agli iscritti.
Accedi per commentare