
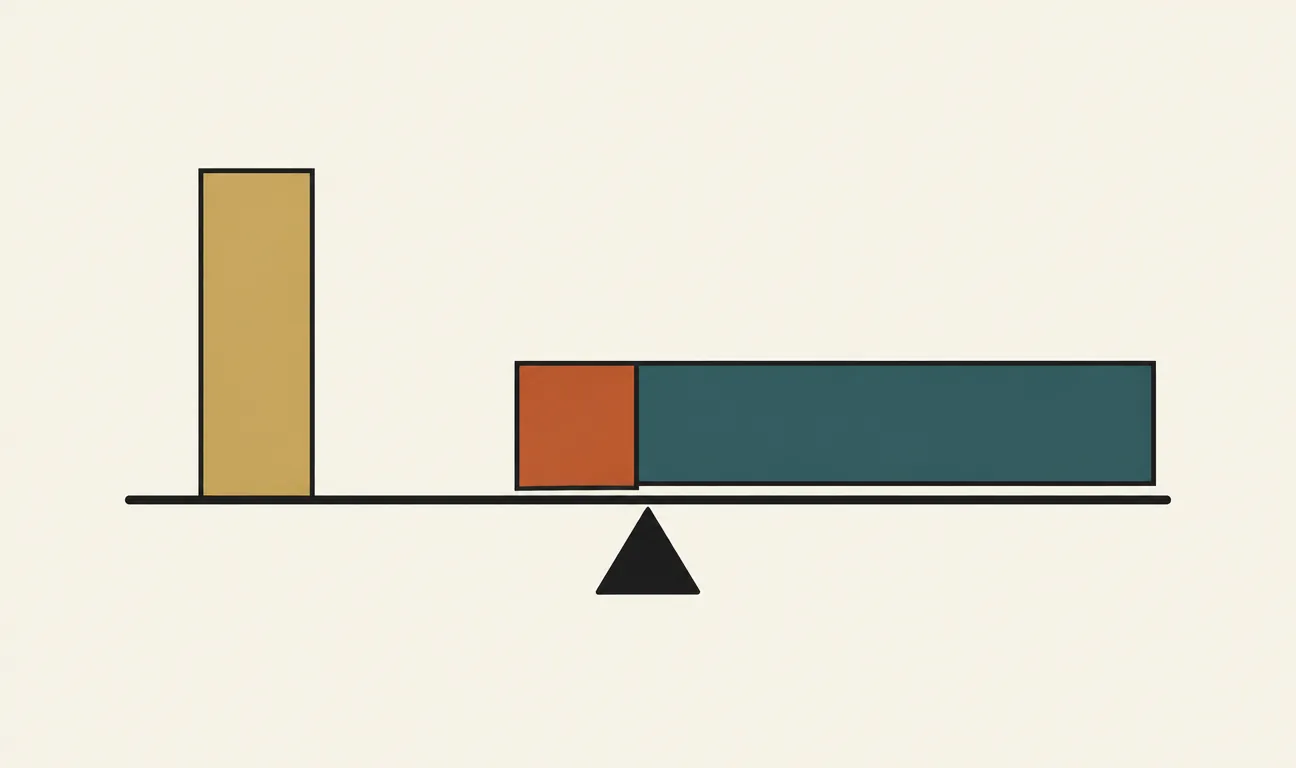
Nel 2022 un gruppo di ricercatori di DeepMind addestrò un modello linguistico quattro volte più piccolo di quello che l’anno prima avevano presentato come il loro fiore all’occhiello, e questo modellino batté il fratello maggiore su quasi ogni prova. Il grande si chiamava Gopher e aveva 280 miliardi di parametri; il piccolo si chiamava Chinchilla e ne aveva 70. A parità di potenza di calcolo spesa per addestrarli, il piccolo vinceva. Non di poco, e non su un test isolato: su una lunga batteria di compiti diversi.
Il pretraining su scala web, le leggi di scala, e l’arte di scegliere la parola dopo — temperatura, top-p, KV cache — stanno nel libro.
La cosa suona controintuitiva perché per un paio d’anni il messaggio dominante era stato l’opposto: più grande è meglio. Il paper che racconta questo ribaltamento — Training Compute-Optimal Large Language Models, di Jordan Hoffmann e colleghi — non aggiunge un trucco architetturale né un nuovo tipo di rete. Cambia soltanto come si spende un budget fisso. E proprio per questo è uno dei lavori più influenti del decennio.
La domanda sbagliata: «quanto grande?»
Addestrare un modello linguistico ha due leve principali. La prima è quanti parametri gli si danno, cioè quanto è grande la sua «capacità». La seconda è quanti token di testo gli si fa leggere durante l’addestramento, cioè quanta esperienza accumula. Entrambe costano calcolo, e in prima approssimazione il costo totale cresce come il prodotto delle due: parametri per token. Fissato un budget — poniamo, un certo numero di acceleratori per un certo numero di settimane — la domanda è come dividerlo tra le due leve.
Le leggi di scala allora più citate (Kaplan e colleghi, 2020) avevano suggerito una risposta netta: metti quasi tutto nella dimensione del modello, e cresci i dati molto più lentamente. Il risultato pratico fu una corsa ai parametri. GPT-3 arrivò a 175 miliardi, Gopher a 280, Megatron-Turing NLG a 530. I dataset di addestramento, intanto, restavano più o meno fermi intorno ai 300 miliardi di token.
Pensatela come la costruzione di una biblioteca con un budget fisso. Puoi tirare su un edificio enorme — tanti parametri, tanta capacità — e riempirlo di pochi libri, oppure costruire un edificio più modesto e riempirlo fino al soffitto. Per un paio d’anni si sono costruiti soprattutto palazzi mezzi vuoti.
La ricetta: scalare in parti uguali
Hoffmann e colleghi rifecero i conti da capo, con più cura. Addestrarono più di 400 modelli, da 70 milioni a oltre 16 miliardi di parametri, su quantità di dati che andavano da 5 a 500 miliardi di token, e osservarono dove cadeva il minimo della perdita per ogni budget di calcolo. Tre metodi di analisi indipendenti arrivarono alla stessa conclusione, il che dà fiducia nel risultato.
La conclusione è che, per usare al meglio un budget fisso, la dimensione del modello e il numero di token vanno cresciuti in parti uguali. Raddoppi i parametri? Allora devi raddoppiare anche i dati. Tradotto in una regola pratica facile da ricordare: circa 20 token di addestramento per ogni parametro del modello. Un modello da 70 miliardi di parametri «vuole» quindi intorno a 1,4 trilioni di token per essere allenato a dovere.
Non è che i modelli giganti fossero troppo grandi. Erano affamati: cervelli enormi nutriti con troppo pochi dati.
Lo stesso costo di addestramento, allocato in due modi opposti. Gopher spende quasi tutto in capacità e poco in dati; Chinchilla capovolge il rapporto — quattro volte meno parametri, circa quattro volte più testo — e ne esce un modello migliore.
Chinchilla contro Gopher
Per dimostrarlo non bastava la teoria. Gli autori presero il budget di calcolo esatto usato per Gopher (280 miliardi di parametri, 300 miliardi di token) e lo rispesero secondo la nuova ricetta: 70 miliardi di parametri, ma 1,4 trilioni di token, cioè circa quattro volte più testo. Stesso costo, allocazione diversa. Il risultato è Chinchilla.
Su MMLU — un test di conoscenza a scelta multipla che copre decine di materie, dalla storia alla medicina — Chinchilla raggiunse un’accuratezza media del 67,5%, oltre sette punti percentuali meglio di Gopher. E non solo Gopher: Chinchilla superò anche GPT-3 (175 miliardi), Jurassic-1 (178) e Megatron-Turing NLG (530), tutti modelli molto più grandi di lui, su un’ampia gamma di compiti. Il punto non è che Chinchilla fosse un capolavoro di ingegneria: è che i modelli di frontiera dell’epoca erano stati, nelle parole degli autori, «significativamente sotto-allenati». Avevano speso quasi tutto in capacità e troppo poco in esperienza.
Perché «sotto-allenati» cambia l’economia
Un modello più piccolo che rende quanto uno grande non è solo una curiosità accademica. Ha un vantaggio che si paga tutti i giorni: costa meno da usare. Addestrare un modello lo si fa una volta; farlo girare — rispondere a milioni di richieste — lo si fa per sempre, e il costo di ogni risposta cresce con il numero di parametri. Un modello da 70 miliardi che eguaglia uno da 280 consuma, a ogni interrogazione, circa un quarto della memoria e del calcolo. Meno costo di inferenza, meno hardware, risposte più veloci.
È la differenza tra assumere un genio dalla memoria corta e un professionista competente che ha studiato molto. A parità di risultato sul lavoro, il secondo costa meno da tenere in ufficio ogni giorno. Dopo Chinchilla il baricentro del campo si spostò: la corsa ai parametri rallentò e cominciò la corsa ai dati. Raccogliere, pulire e filtrare trilioni di token di buon testo diventò il nuovo collo di bottiglia, e diversi modelli aperti degli anni successivi nacquero dichiaratamente da questa lezione — relativamente pochi parametri, moltissimi token, così da girare bene anche su hardware modesto.
Vale la pena aggiungere una nota di onestà. La regola dei venti token per parametro è ottimale per il costo di addestramento, non per quello d’uso. Se prevedi di far girare un modello miliardi di volte, può convenire «strafogarlo» di dati ben oltre l’ottimo teorico: allenarlo più a lungo del necessario costa di più una volta, ma rende ogni risposta più economica per sempre. Diversi modelli recenti fanno esattamente questo. E la stima precisa dei coefficienti è stata poi rimessa in discussione da tentativi di replica indipendenti, che ne hanno raffinato i dettagli senza rovesciarne la sostanza. Chinchilla ha aperto la discussione, non l’ha chiusa.
Perché riguarda voi
Anche se non addestrerete mai un modello da 70 miliardi di parametri, la lezione di Chinchilla è un buon antidoto a un riflesso diffuso: pensare che «più grande» sia sempre «meglio». Quando leggete che un nuovo modello ha un certo numero di miliardi di parametri, quel numero da solo non vi dice quasi nulla sulla sua qualità: conta almeno altrettanto quanto testo ha letto. Due modelli con lo stesso numero di parametri possono essere lontanissimi per capacità, a seconda di come è stato speso il budget.
C’è anche una lezione di metodo che va oltre l’AI. Un intero settore aveva ottimizzato con convinzione la variabile sbagliata per un paio d’anni, non per sciatteria ma perché un’analisi precedente, presa per definitiva, indicava quella strada. È bastato rifare i conti con più cura per spostare miliardi di investimenti. Conviene ricordarlo la prossima volta che una «legge» del settore suona troppo comoda per essere messa in discussione.
Il paper
Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch e altri (22 autori, DeepMind), Training Compute-Optimal Large Language Models, 2022. Presentato a NeurIPS 2022, disponibile su arXiv: arxiv.org/abs/2203.15556.
I commenti sono riservati agli iscritti.
Accedi per commentare