
Febbraio 2020: un modello di credit scoring, in produzione da tre anni, macina predizioni con la solita affidabilità. Marzo 2020: le stesse predizioni diventano carta straccia. Il codice non è cambiato di una riga, i server rispondono in millisecondi, i test passano tutti. È cambiato il mondo: lockdown, redditi congelati, consumi stravolti. Il modello continua a ragionare su un’economia che non esiste più.
Che cosa si misura su un modello vivo, come si rileva il drift e come gli si risponde: nel libro.
Questo è il caso estremo e teatrale. Il caso normale è molto più subdolo: nessuna pandemia, nessun evento sui giornali, solo un lento scivolamento. Il modello che a gennaio azzeccava il 94% delle predizioni a dicembre ne azzecca l’89%, e nessuno se n’è accorto perché nessuno stava guardando la metrica giusta. Questo fenomeno ha un nome: drift.
Il modello è una fotografia, il mondo è un film
Quando addestriamo un modello, gli mostriamo un campione di dati raccolti in un certo periodo. Il modello impara le regolarità di quel campione: le relazioni tra input e output valide in quel momento. È come stampare una mappa stradale: il giorno della stampa è perfetta, poi la città continua a costruire rotonde e chiudere strade, e la mappa — identica a se stessa — diventa ogni mese un po’ più sbagliata.
Il punto cruciale è che non si rompe niente. Il modello non lancia eccezioni, non va in errore, non rallenta. Serve predizioni con la stessa sicurezza del primo giorno. Semplicemente, quelle predizioni descrivono un mondo che si è spostato altrove.
Due modi diversi di invecchiare
Sotto l’etichetta «drift» convivono due fenomeni distinti, ed è utile separarli perché si diagnosticano in modi diversi.
Il data drift (o covariate shift) riguarda gli input: la distribuzione dei dati che arrivano in produzione si allontana da quella dei dati di addestramento. Un e-commerce addestra un modello di raccomandazione sui clienti del 2023, poi apre a un nuovo mercato e metà del traffico arriva da utenti con abitudini diverse. La relazione tra caratteristiche e comportamento magari è ancora valida, ma il modello riceve input che ha visto raramente durante l’addestramento — e lì è meno affidabile, come un medico esperto di pazienti anziani che si ritrova in un reparto pediatrico.
Il concept drift è più insidioso: cambia la relazione stessa tra input e output. Gli input possono sembrare identici, ma il loro significato è mutato. Nel 2019 «acquisto notturno da un nuovo dispositivo» era un buon segnale di frode; con il boom degli acquisti da divano, lo stesso pattern è diventato normalità. La mappa non è solo invecchiata: qualcuno ha cambiato il codice della strada.
Il drift non è un bug e non è un incidente. È la condizione fisiologica di qualsiasi modello in produzione: la domanda non è se accadrà, ma quanto in fretta.
Perché nessuno se ne accorge
La ragione per cui il drift resta invisibile è quasi banale: il monitoraggio standard guarda le cose sbagliate. CPU, memoria, latenza, tasso di errori HTTP — tutte metriche di infrastruttura, tutte perfettamente verdi mentre il modello sbaglia. È come giudicare un ristorante dalla velocità con cui escono i piatti: il servizio può essere impeccabile e il cibo immangiabile.
C’è poi un secondo ostacolo, più strutturale: spesso la verità arriva in ritardo. Per sapere se il modello di credit scoring ha sbagliato, bisogna aspettare mesi e vedere chi effettivamente non ripaga. Per sapere se il modello di churn ha ragione, bisogna aspettare che i clienti se ne vadano. Il segnale di qualità — la ground truth — è disponibile solo con settimane o mesi di distanza dalla predizione. Nel frattempo il modello continua a decidere.
Misurare lo spostamento senza aspettare la verità
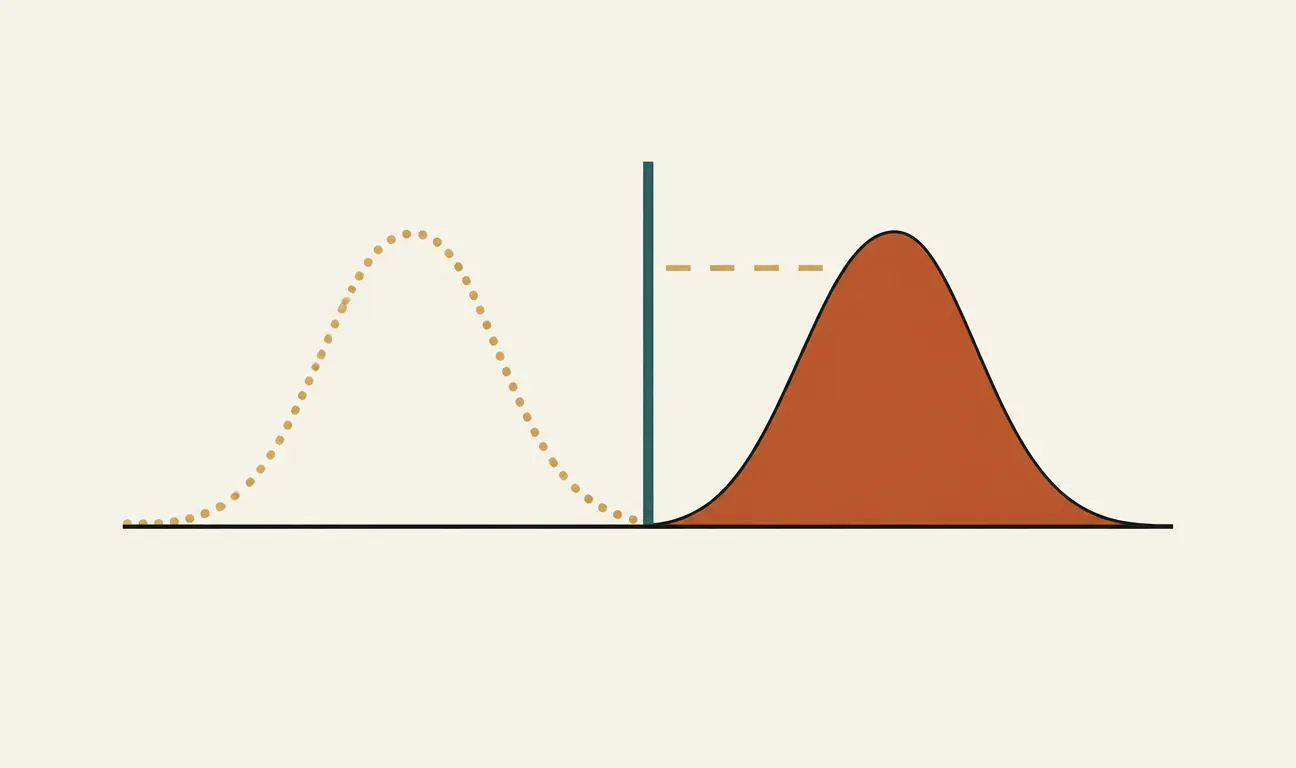
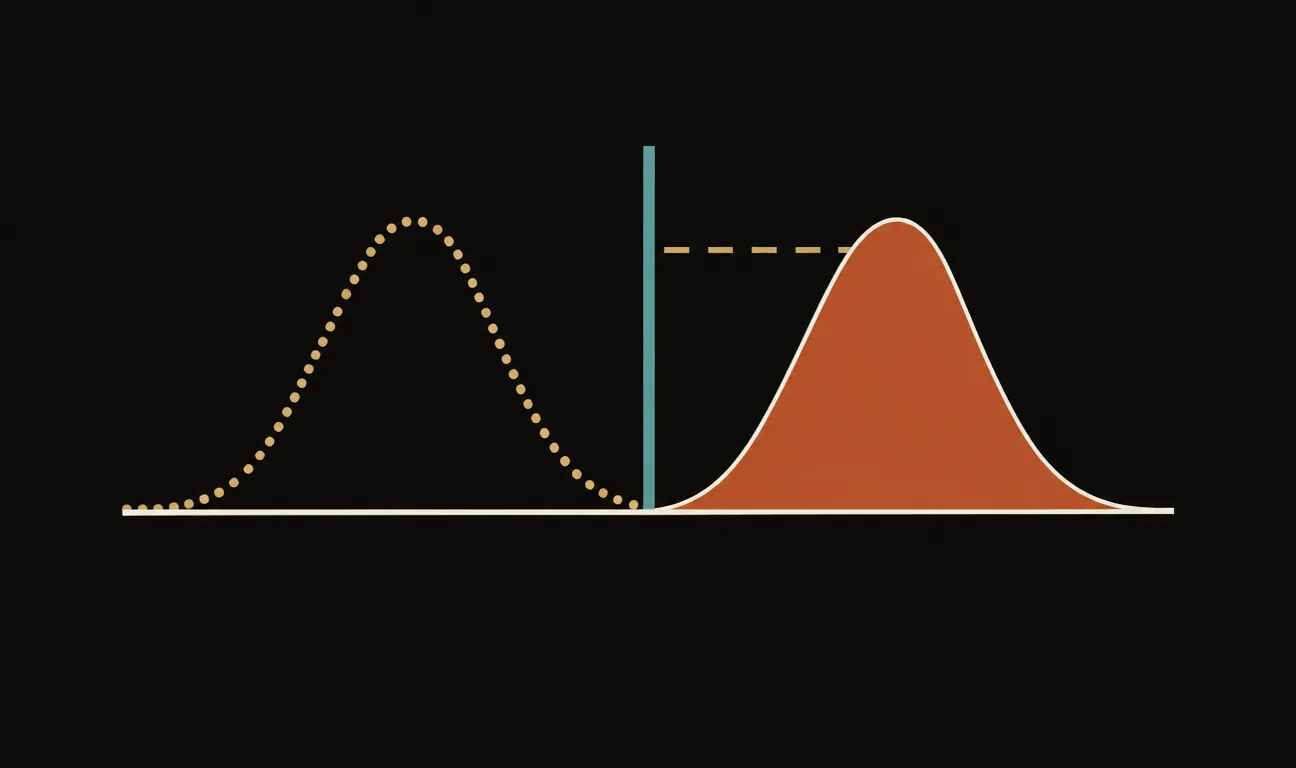
La buona notizia: non serve la ground truth per accorgersi che qualcosa si sta muovendo. Si può monitorare direttamente la forma dei dati in ingresso, confrontando la distribuzione di ogni feature in produzione con quella vista in addestramento.
La distribuzione di una feature in produzione (terracotta) si allontana progressivamente da quella vista in addestramento (teal). Il modello continua a funzionare, ma ragiona su un mondo che non c’è più.
Gli strumenti classici per quantificare questa distanza sono statistici e ben rodati. Il Population Stability Index (PSI) divide i valori in intervalli e misura quanto le proporzioni sono cambiate tra i due periodi: nella prassi bancaria, un PSI sopra 0,2 è considerato un segnale d’allarme. Il test di Kolmogorov-Smirnov confronta le due distribuzioni cumulative e dice quanto è plausibile che provengano dalla stessa popolazione. Per dati ad alta dimensionalità — embedding, immagini — si confrontano le distribuzioni delle rappresentazioni interne o si addestra un classificatore a distinguere «dati vecchi» da «dati nuovi»: se ci riesce facilmente, il drift c’è.
Accanto agli input conviene monitorare anche gli output: se un modello di frode segnalava il 2% delle transazioni e ora ne segnala l’8%, qualcosa è cambiato — nel mondo o nel modello. Sono metriche proxy: non dicono se il modello sbaglia, ma dicono quando vale la pena indagare.
Conviverci: retraining, trigger e umiltà
Contro il drift non esiste vaccino, esiste manutenzione. Le strategie principali sono tre, in ordine crescente di raffinatezza.
La prima è il retraining periodico: si riaddestra il modello a cadenza fissa — ogni mese, ogni trimestre — su dati recenti. Semplice, prevedibile, spesso sprecone: se il mondo non è cambiato si paga un riaddestramento inutile, se è cambiato in fretta si arriva tardi.
La seconda è il retraining a trigger: le metriche di drift fanno da campanello, e il riaddestramento parte solo quando il PSI o il test statistico superano una soglia. È l’equivalente del tagliando «a chilometraggio» invece che «a calendario»: si interviene quando serve.
La terza è strutturale: progettare la pipeline sapendo che il modello verrà sostituito molte volte. Dati versionati, feature ricostruibili, valutazione automatica del candidato nuovo contro il campione recente, deploy graduale con confronto in ombra (shadow deployment) prima dello switch. In questo mondo il retraining non è un’emergenza ma un’operazione di routine, come il backup.
Vale anche per gli LLM, con una torsione in più: chi usa modelli via API non controlla il retraining, ma subisce comunque il drift dal lato dei dati — le domande degli utenti cambiano, i documenti indicizzati nel RAG invecchiano, il gergo si evolve. E quando il fornitore aggiorna il modello, è la mappa stessa a cambiare sotto i piedi: senza un set di valutazione proprio, eseguito a ogni cambio di versione, non si ha modo di accorgersene.
Perché ti riguarda
Se hai un modello in produzione — o stai per mettercelo — il drift è la voce di costo che nessuno mette a budget. Il progetto tipico finanzia lo sviluppo e considera il deploy un traguardo; in realtà è il chilometro zero. Un modello senza monitoraggio delle distribuzioni è un contratto firmato senza data di scadenza: continuerà a decidere, con sicurezza immutata, anche quando avrà smesso di avere ragione. La domanda da fare al prossimo demo giorno non è «quanto è accurato?», ma «come ve ne accorgerete, quando smetterà di esserlo?»
I commenti sono riservati agli iscritti.
Accedi per commentare