
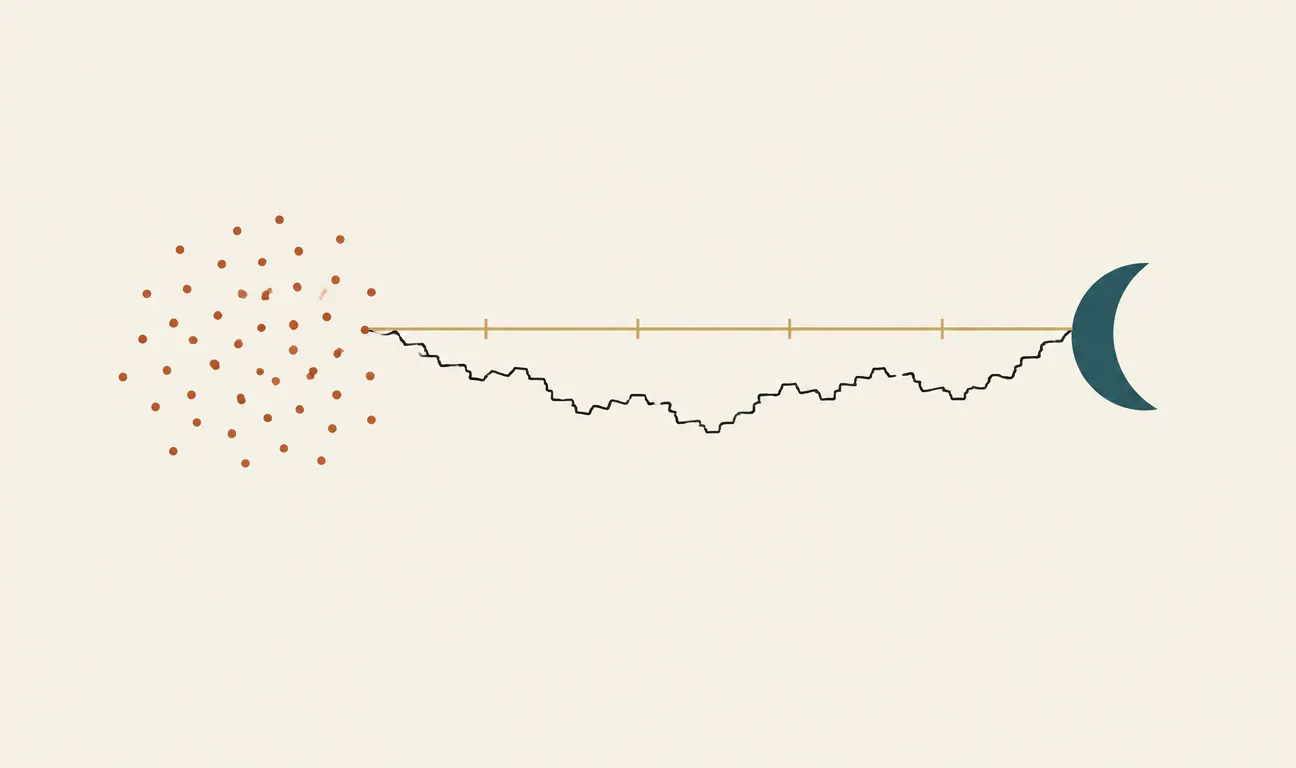
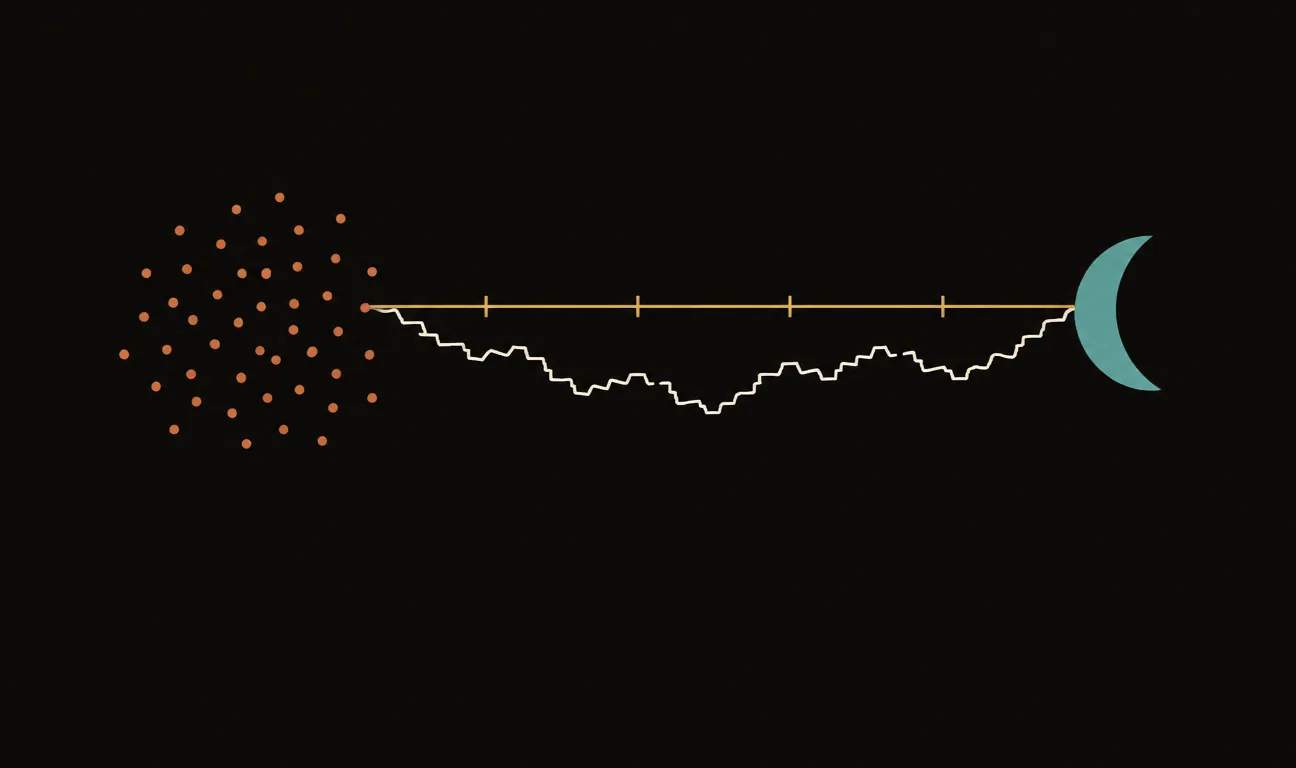
Immaginate di dover andare da casa vostra al centro della città. La diffusione, la tecnica che per anni ha dominato la generazione di immagini, è come un ubriaco che torna a casa: fa un passo a caso, si corregge, ne fa un altro, e alla fine — dopo cinquanta o cento passetti incerti — arriva più o meno a destinazione. Il flow matching, proposto in un paper del 2022 firmato da un gruppo di ricercatori di Meta AI guidati da Yaron Lipman, chiede una cosa apparentemente ovvia: e se al modello insegnassimo direttamente la direzione dritta verso casa, così da poterci arrivare in pochi passi lunghi invece che in cento passetti?
Il problema che tutti i generatori condividono
Alla base di ogni modello generativo c’è lo stesso compito: trasformare qualcosa di semplice — una manciata di numeri casuali, il «rumore» — in qualcosa di complesso e strutturato, un’immagine, un video, una molecola. Il modo di pensarci più elegante è geometrico: da una parte c’è una nuvola di rumore, una distribuzione informe; dall’altra c’è la distribuzione dei dati veri, il continente delle immagini plausibili. Generare significa trasportare un punto dalla prima nuvola al secondo continente.
La domanda è: lungo quale percorso? La diffusione risponde con un percorso fissato in anticipo, definito da un processo fisico di «sporcamento» progressivo dell’immagine con rumore; il modello impara a invertirlo, a rimuovere il rumore un pochino alla volta. Funziona benissimo, ma quel percorso è tortuoso, e per seguirlo con fedeltà servono molti passi. Ogni passo è una chiamata al modello, cioè tempo e denaro.
L’idea: descrivere il flusso, non il rumore
Il flow matching cambia il punto di vista. Invece di partire da un processo di rumore e imparare a invertirlo, parte dalla domanda geometrica pura: come dovrebbe muoversi ogni punto, istante per istante, per fluire dal rumore ai dati? Questo «come muoversi» è un campo di velocità: per ogni posizione e ogni istante, una freccia che dice in quale direzione e a che velocità spostarsi. Se conoscessi quel campo di frecce, generare sarebbe banale: metti un punto nel rumore e lo lasci scorrere lungo le frecce fino ad arrivare tra i dati.
L’analogia è quella di una corrente in un fiume. La diffusione è come stimare, punto per punto, quanta sabbia togliere per scavare il letto; il flow matching descrive direttamente la corrente e ci mette dentro la barca. Il problema tecnico che aveva bloccato quest’idea per anni era che calcolare quel campo di velocità «vero» sembrava richiedere di simulare l’intero trasporto — costosissimo. Il contributo centrale del paper è aggirare l’ostacolo.
Il trucco: guardare un dato alla volta
Ecco la mossa che rende il tutto praticabile, e che il paper chiama conditional flow matching. Descrivere il flusso che porta a tutta la distribuzione dei dati contemporaneamente è impossibile in forma chiusa. Ma descrivere il flusso verso un singolo punto-dato è facilissimo: prendo un’immagine di addestramento, prendo un punto di rumore, e traccio tra i due il percorso più semplice possibile — una linea retta. La velocità lungo quella retta la conosco esattamente: è la freccia che punta dal rumore all’immagine.
Non serve conoscere la corrente dell’intero oceano: basta insegnare al modello, milioni di volte, come si va in linea retta da un granello di rumore a una singola immagine vera. La media di tutte quelle rette fa emergere la corrente giusta.
Il risultato matematico, elegante e non ovvio, è che addestrare il modello a indovinare queste velocità «condizionate» — semplici, esplicite, calcolabili — produce esattamente lo stesso campo di velocità che avremmo ottenuto affrontando il problema globale impossibile. Il modello non vede mai l’oceano intero, ma allenandosi su una marea di piccole rette impara la corrente complessiva. E l’addestramento è simulation-free: a ogni passo non c’è nessuna simulazione da fare, solo prevedere una freccia e correggere l’errore. Semplice come un problema di regressione.
La diffusione segue una traiettoria tortuosa e ha bisogno di molti passi per restarle fedele; il flow matching addestrato su percorsi rettilinei tende a traiettorie quasi dritte, che si percorrono in pochi passi — cioè con poche chiamate al modello.
Perché le rette contano davvero
C’è un dettaglio che trasforma un’idea pulita in un guadagno concreto. Il paper mostra che scegliendo bene i percorsi condizionati — in particolare percorsi ispirati al trasporto ottimale, che nel caso più semplice sono proprio linee rette a velocità costante — le traiettorie complessive del flusso restano quasi dritte. E una traiettoria dritta si può percorrere con pochi passi lunghi senza perdere precisione, perché non ci sono curve strette da negoziare. È qui che la diffusione paga il suo prezzo: il suo percorso curvo obbliga a passetti piccoli, altrimenti si «esce di strada» e l’immagine si degrada.
Meno passi significa generazione più veloce e più economica a parità di qualità. Non è un dettaglio da laboratorio: quando un modello deve generare centinaia di fotogrammi di un video, o servire milioni di richieste, tagliare i passi di campionamento da cinquanta a una manciata è la differenza tra fattibile e proibitivo. Vale la pena aggiungere un’onestà: flow matching e diffusione non sono nemici, sono parenti stretti. La diffusione si può riformulare come un caso particolare di questa cornice più generale; il flow matching non la butta via, la generalizza e ne offre una versione con percorsi migliori.
Dove è finito, tre anni dopo
La prova che l’idea abbia retto sta in dove è finita. Il flow matching, nelle sue varianti (spesso etichettate come rectified flow o interpolanti stocastici, sviluppate in parallelo da altri gruppi), è diventato il modo di addestrare tra i più diffusi nei modelli generativi di frontiera: lo si ritrova sotto il cofano di generatori di immagini di ultima generazione e di modelli testo-video come Movie Gen. In pochi anni è passato da elegante alternativa teorica a impostazione di default per chi costruisce da zero un nuovo generatore.
Se ti riguarda? Se generi immagini o video, la velocità che ottieni oggi rispetto a due anni fa è in buona parte merito di questa riformulazione. Ma la lezione è più ampia e vale anche fuori dalla generazione visiva: molti progressi nell’AI non arrivano da modelli più grandi, ma dal riformulare un problema in una geometria in cui la soluzione naturale è più semplice. Il flow matching non ha inventato nuove immagini: ha raddrizzato la strada per arrivarci, e questo è bastato a cambiare la ricetta di un intero settore.
Per approfondire
Il paper: Yaron Lipman, Ricky T. Q. Chen, Heli Ben-Hamu, Maximilian Nickel, Matt Le, Flow Matching for Generative Modeling, 2022, presentato a ICLR 2023 — arxiv.org/abs/2210.02747. Per il filone parallelo del rectified flow si veda il lavoro di Xingchao Liu e colleghi (Flow Straight and Fast, 2022); per una trattazione unificata, la Flow Matching Guide and Code pubblicata successivamente dallo stesso gruppo.
I commenti sono riservati agli iscritti.
Accedi per commentare