
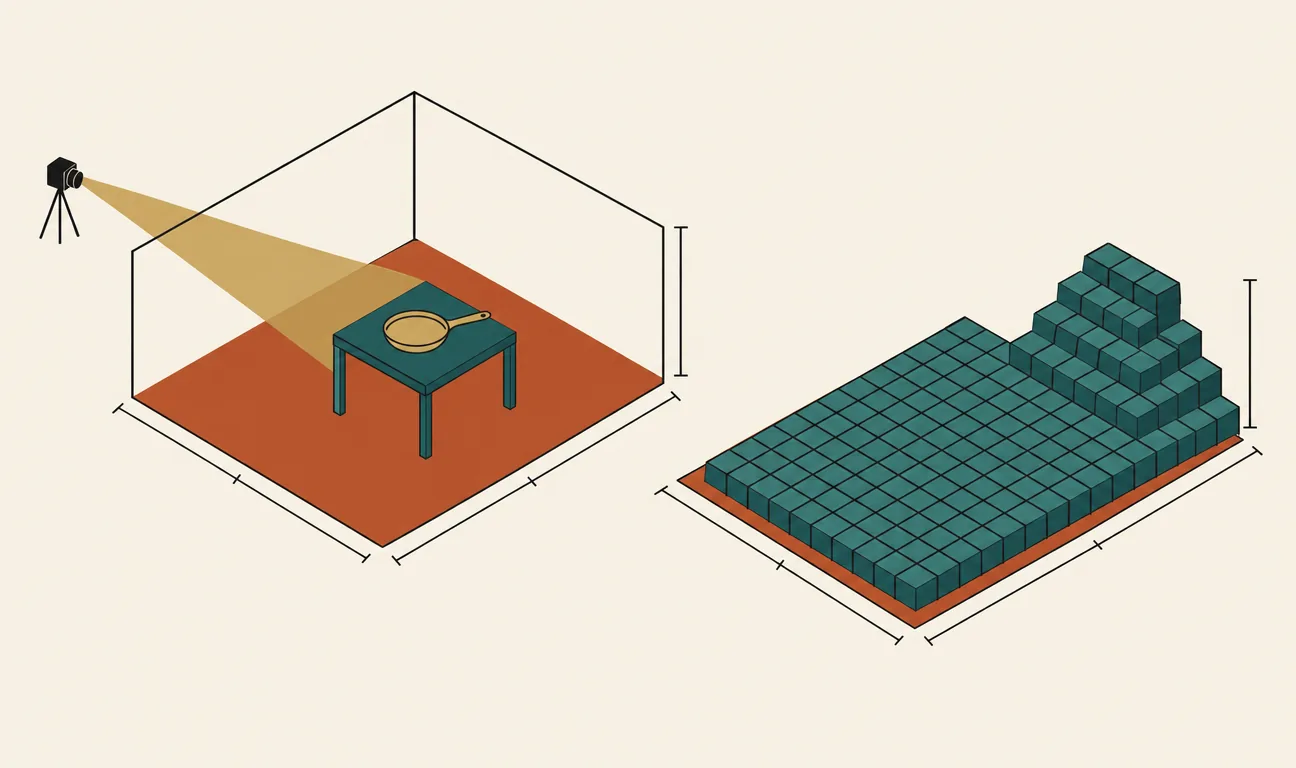
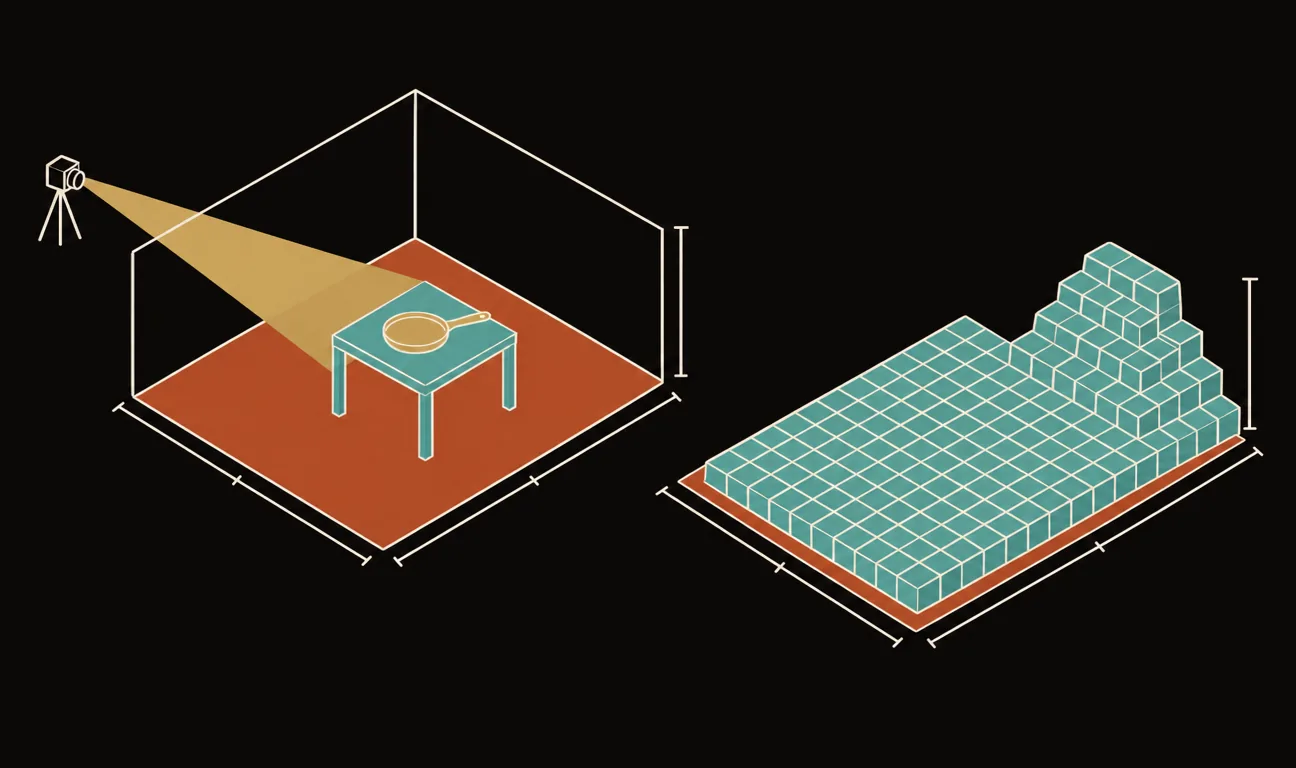
Chi ricostruisce un incidente stradale da un video girato col telefono ha un lavoro ingrato. Non sa a che distanza stava chi filmava, né quanto è larga la carreggiata, né se l’auto in fondo è una berlina o una utilitaria vista da vicino. Deve indovinare tutto dall’immagine, e ogni stima sbagliata si porta dietro le altre. Un regista che gira su un set ha il problema opposto: la piantina ce l’ha prima di cominciare, sa dove sta la macchina da presa, quanto è alto il tavolo, dove finisce il muro.
È questo cambio di punto di partenza la proposta di GRAIL: Generating Humanoid Loco-Manipulation from 3D Assets and Video Priors, depositato su arXiv il 3 giugno 2026 (2606.05160), con il codice ufficiale segnalato su Papers with Code. Lo firmano venti autori di NVIDIA e dell’Università della California a Los Angeles, con quattro primi autori a pari merito (Tianyi Xie, Haotian Zhang, Jinhyung Park, Zi Wang) e Zhengyi Luo, Umar Iqbal e Ye Yuan come responsabili del progetto. L’obiettivo è pratico: produrre dati di addestramento per robot umanoidi senza costruire scene fisiche e senza pilotare il robot a mano.
Il collo di bottiglia dei dati
Un umanoide che cammina fino a un tavolo e prende una mela coordina equilibrio, contatto e appoggio dei piedi. Per imparare ha bisogno di dimostrazioni: sequenze in cui qualcuno, o qualcosa, fa il gesto in un modo che il robot possa davvero eseguire. Le fonti classiche sono due, e nessuna delle due scala. La teleoperazione richiede una persona che guida il robot per ogni nuovo oggetto o terreno; il motion capture richiede attori con i marcatori addosso e una scena da allestire ogni volta.
La terza strada, ricostruire i movimenti dai video che si trovano in rete, offre varietà enorme ma è il caso dell’incidente filmato col telefono: da una sola inquadratura bisogna dedurre posizione della camera, scala metrica, forma dell’oggetto, corporatura della persona, punti di contatto. Qualche lavoro recente, come DAViD o ZeroHSI, usa già i modelli generativi video come fonte di interazioni, ma lascia quelle stesse grandezze da indovinare dopo. GRAIL le fissa prima.
Qui si dà per noto come un modello genera un video a partire da un’immagine e da un testo. L’architettura che sta sotto a molti generatori video di oggi è spiegata nel libro.
Prima il set, poi le riprese
Si parte da un oggetto 3D, un asset: una padella, una scatola di tè, un divano. La scena intorno viene da Infinigen, un generatore procedurale di ambienti, in due modelli: una stanza vuota per gli oggetti da terra e una stanza arredata con un tavolo per quelli da appoggiare. Quale delle due usare lo decide un modello linguistico con la visione, in base a come si usa di solito l’oggetto. Accanto viene messo un personaggio umano la cui corporatura è già stata adattata alle proporzioni del robot bersaglio, un Unitree G1. Una simulazione di corpi rigidi lascia assestare l’oggetto in una posizione stabile, e Blender rende il primo fotogramma con parametri della camera noti.
Da lì entra il modello video. Un modello linguistico scrive la descrizione dell’interazione guardando il fotogramma; il fotogramma e la descrizione vanno a Kling 2.5 Turbo Pro, il generatore commerciale di Kuaishou, che produce clip da 5 o 10 secondi a 24 fotogrammi al secondo, a camera fissa. La camera ferma è la condizione perché le misure del set restino valide nel video.
Il passaggio decisivo è la ricostruzione. La posa del corpo arriva da GENMO, ma la forma del corpo non viene stimata: resta quella del personaggio già adattato al robot. Le mani vengono da WiLoR. L’oggetto è tracciato con FoundationPose, che ha bisogno di geometria, texture e parametri della camera, tutte cose che qui esistono per costruzione, e che parte dalla posa nota del primo fotogramma. La profondità stimata da MoGe-2 viene allineata alla profondità vera dello sfondo, che si conosce perché la stanza l’ha disegnata la pipeline: così diventa metrica. Poi un’ottimizzazione congiunta su tutti i fotogrammi corregge insieme persona e oggetto, perché ricostruiti separatamente tendono a compenetrarsi o a toccarsi a distanza. La funzione da minimizzare è una somma pesata:
$$L = \lambda_{\text{kp}} L_{\text{kp}} + \lambda_{\text{proj}} L_{\text{proj}} + \lambda_{\text{depth}} L_{\text{depth}} + \lambda_{\text{cont}} L_{\text{cont}} + \lambda_{\text{reg}} L_{\text{reg}}$$
dove i termini tengono allineati al video i punti chiave di corpo e mani, la proiezione dell’oggetto a quella tracciata, le superfici alle nuvole di punti ricavate dalla profondità, e la mano all’oggetto nei fotogrammi in cui un modello linguistico ha detto che c’è contatto; l’ultimo termine sopprime piedi che scivolano e scatti. Una sequenza di 5 secondi costa circa 14 minuti su una A100, di cui 8 per l’ottimizzazione. Quelle in cui il tracciamento dell’oggetto perde la presa, confrontato con le maschere di SAM2, vengono scartate.
Dal movimento umano al robot
Il movimento ricostruito viene trasferito allo scheletro del G1 con GMR, un metodo di retargeting; avere già un personaggio con le proporzioni del robot riduce le mani che mancano l’oggetto e i piedi che non toccano il gradino. Ma una traiettoria di giunti non è ancora un’azione eseguibile: serve un controllore che, in simulazione fisica, la segua senza cadere.
Qui GRAIL si appoggia a SONIC, un controllore di tutto il corpo già preaddestrato, firmato da un gruppo che in parte coincide con questi autori, e lo specializza in due modi. Per la manipolazione il controllore resta congelato e gli si affianca un piccolo adattatore $\pi_\varphi$ che guarda lo stato del robot e quello dell’oggetto, e restituisce una correzione alla rappresentazione latente del controllore più un comando apri-chiudi per ciascuna mano:
$$(\Delta z_t, a^{\text{hand}}_t) = \pi_\varphi(s_t, o_t), \qquad a^{\text{body}}_t = \mathcal{G}(z_t + \lambda\, \Delta z_t)$$
con $\lambda = 0{,}1$ e una penalità che tiene piccola la correzione: il comportamento resta vicino a quello del controllore di partenza, che sa già camminare. Per scale, cordoli e sedie, invece, il controllore viene rifinito insieme a un codificatore di una mappa delle altezze di 11×11 punti attorno al robot. In entrambi i casi non si addestra un controllore per sequenza ma uno per famiglia di compiti: una corsa di circa 30 ore su 64 GPU L40, con PPO in Isaac Lab, copre da 2.000 a 4.000 movimenti. Gli autori ne ricavano 0,5-0,9 minuti per movimento, ma con 64 GPU al lavoro: in tempo-GPU, conto nostro, fra mezz’ora e un’ora.
PPO e le politiche per azioni continue, che stanno dietro a questa parte, sono spiegati nel libro.
Con 1.000 oggetti presi da quattro raccolte di asset e 1.000 terreni generati proceduralmente, il risultato è un insieme di oltre 20.000 sequenze in quattro categorie: raccogliere oggetti, manipolazione con tutto il corpo (spingere un carrello, spostare una scatola camminando), sedersi, attraversare terreni.
I numeri
Qualità delle interazioni. Su 20 oggetti comuni, GRAIL è confrontato con due metodi addestrati (CHOIS e HOIDiff) e con DAViD, che come GRAIL usa un modello video ma senza scena nota; per equità anche DAViD usa Kling. La prova più severa è far rieseguire ogni sequenza a un umanoide simulato e contare quanti fotogrammi restano entro la soglia di errore.
| Metodo | Fotogrammi |
|---|---|
| GRAIL | 88,9% |
| DAViD, modello video senza scena nota | 24,0% |
| HOIDiff | 15,8% |
| CHOIS | 10,5% |
La compenetrazione fra corpo e oggetto scende allo 0,90% dei vertici del corpo, contro l’1,46-3,74% degli altri. Non vince tutto: sulla fluidità del movimento umano DAViD fa meglio. In uno studio con 30 partecipanti, GRAIL è scelto come il più adatto all’uso dell’oggetto il 74,7% delle volte e come il più plausibile fisicamente il 70,9%, con un tetto teorico del 75% dato dal modo in cui venivano sorteggiati i confronti.
Controllo. Su 124 movimenti con 43 oggetti, il controllore per la manipolazione riesce nell’81,4% dei casi, contro il 48,5% di HDMI e il 49,2% di ResMimic, con meno della metà dell’errore di posizione sull’oggetto. Il confronto va letto con la nota che gli stessi autori mettono: i due concorrenti non muovono le dita e addestrano una politica per compito. L’ablazione è istruttiva: SONIC senza adattatore imita il corpo meglio di tutti ma riesce solo nel 39,7% dei casi. Imitare bene il gesto non basta a prendere la cosa.
Robot vero. Le politiche finali hanno come unica vista una camera RGB sulla testa, più i sensori interni del robot, e sono addestrate solo su dati GRAIL; sotto, però, c’è SONIC, preaddestrato su altri dati di movimento. Sul G1 fisico salgono le scale nel 90% dei casi. Nella raccolta, con 200 sequenze per oggetto su cinque oggetti e dieci prove ciascuno, il successo medio è dell’84%: 100% per il cubo e la scatola di tè, 60% per la mela. Su cinque oggetti mai visti scende all’80%, con un rullo levapelucchi fermo al 50%.
Quello che il paper non dice
Gli autori dichiarano i limiti principali: la pipeline presuppone asset 3D e una scena pronta per il simulatore, e un modello video che esegua davvero l’interazione richiesta; la ricostruzione peggiora con occlusioni forti, movimenti rapidi e oggetti che cambiano aspetto fra un fotogramma e l’altro; e se la famiglia di movimenti cambia molto, i controllori vanno riaddestrati. Ammettono anche che il filtro scarta «una frazione non trascurabile» delle sequenze, senza dire quanta. Per chi deve stimare il costo reale di ventimila sequenze, è il numero che manca.
Altre cose si notano leggendo. Il cuore generativo è un servizio commerciale chiuso, Kling, interrogato via API, e anche i modelli linguistici usati per scrivere le descrizioni e dedurre i contatti sono di OpenAI: la pipeline è «tutta digitale», ma non tutta riproducibile in casa. Le prove nel mondo reale sono poche: dieci tentativi per oggetto, e per le scale il paper riporta la percentuale senza il numero di prove. L’inferenza non gira a bordo: il robot manda immagini e stato a un computer desktop con una RTX 5090, che rimanda le azioni a 10 Hz. E il confronto sulla qualità delle interazioni usa un umanoide simulato fatto di capsule con la forma del corpo umano, non il G1.
Perché conta adesso
Per gli umanoidi, scrive il paper, il collo di bottiglia comune sono i dati, e quelli di manipolazione costano ore di persone che guidano robot. GRAIL non è il primo a usare video generati come fonte; la differenza, rispetto ai lavori che cita, è che usa il modello video solo per quello in cui è bravo, cioè immaginare come si muove una persona che prende una padella, e gli toglie tutto il resto. Scala, camera, geometria e corporatura non si chiedono al video; si decidono prima e si riusano dopo. Gli autori concludono con prudenza che dati così possono affiancare teleoperazione e motion capture. Resta da vedere se l’idea regge su compiti meno ordinati di una mela da raccogliere.
I commenti sono riservati agli iscritti.
Accedi per commentare