
Chi ha montato un mobile sa che il pezzo più utile del pacco non è il mobile: è il fatto che arrivi smontato. Un’anta si sostituisce, un cassetto si apre, una gamba si accorcia. Se lo stesso mobile arrivasse fuso in un blocco solo, per farci qualunque cosa bisognerebbe prima segarlo, e la sega non sa dove finisce il cassetto e comincia il fianco.
È la condizione dei generatori 3D che partono da un’immagine, e il problema affrontato da KaiNinja: Extending Native 3D Generators to the Part Level, uscito su arXiv il 14 settembre 2026 (2609.15659). Lo firmano dodici autori di Alaya Lab, Università di Tokyo, UC Merced e Institute of Science Tokyo: primo autore Ruihan Yu, responsabile del progetto Zhixiang Wang, autore di riferimento con Kaipeng Zhang. Codice e pagina di progetto sono pubblici.
Una mesh bellissima, e tutta d’un pezzo
Modelli come TRELLIS.2 o Hunyuan3D producono da una sola foto una geometria ad alta fedeltà, con coordinate UV, materiali e aspetto fisico delle superfici. Ma restituiscono l’oggetto come una mesh unica, mentre ritexturizzare un componente, animarlo, simularlo o riusarlo richiede parti separate.
Le soluzioni esistenti prendono due strade. La prima genera l’oggetto intero e poi lo taglia: un segmentatore 3D come P3-SAM individua le parti e un secondo modello, X-Part, le rigenera tutte insieme seguendo quei confini. È la sega del mobile: se la segmentazione sbaglia i confini nessuno li corregge, e la catena è lenta. La seconda strada mette la struttura in parti dentro la generazione, ma di solito con un aiuto esterno: OmniPart parte da maschere 2D dell’immagine trasformate in scatole di ingombro, AutoPartGen genera un pezzo alla volta, con un passaggio della rete per ciascuno.
Gli autori vogliono una cosa più semplice: prendere il generatore già addestrato che considerano lo stato dell’arte, TRELLIS.2, e fargli produrre le parti direttamente, in un solo passaggio, senza maschere, senza segmentatori, senza un numero massimo di pezzi.
Qui si dà per noto come un modello generativo trasformi rumore in un campione, passo dopo passo, con un transformer che fa da denoiser: flow matching e Diffusion Transformer sono costruiti nel libro.
Un voxel, un foglio solo
TRELLIS.2 non memorizza la forma come un campo continuo ma in una griglia sparsa di voxel che chiama O-Voxel. Ogni voxel attivo contiene un solo vertice e poche informazioni sugli spigoli attraversati dalla superficie: custodisce, in pratica, un piccolo lembo di superficie. È ciò che gli permette superfici aperte e materiali. Ma ha una conseguenza precisa: un voxel può contenere un solo foglio di superficie.
Dove due parti si toccano, le loro facce sono quasi parallele e quasi coincidenti. Cadono negli stessi voxel, e la voxelizzazione ne tiene una e butta l’altra. È un limite di capacità, non di risoluzione: raffinare la griglia non basta, e gli autori non si aspettano che un’architettura costruita sopra recuperi superfici che l’input non ha mai contenuto. Per questo l’estensione comincia dalla rappresentazione.
Due scatole, e nessun pezzo ne tocca un altro
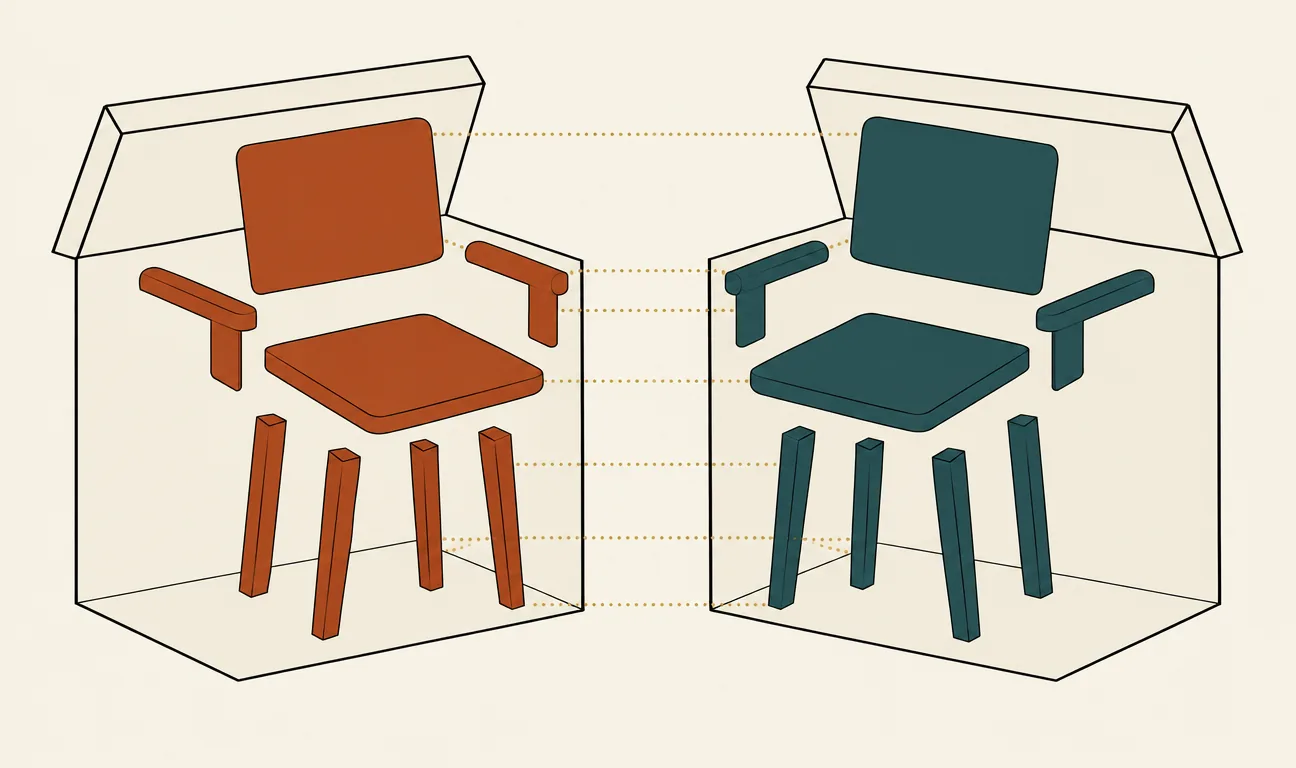
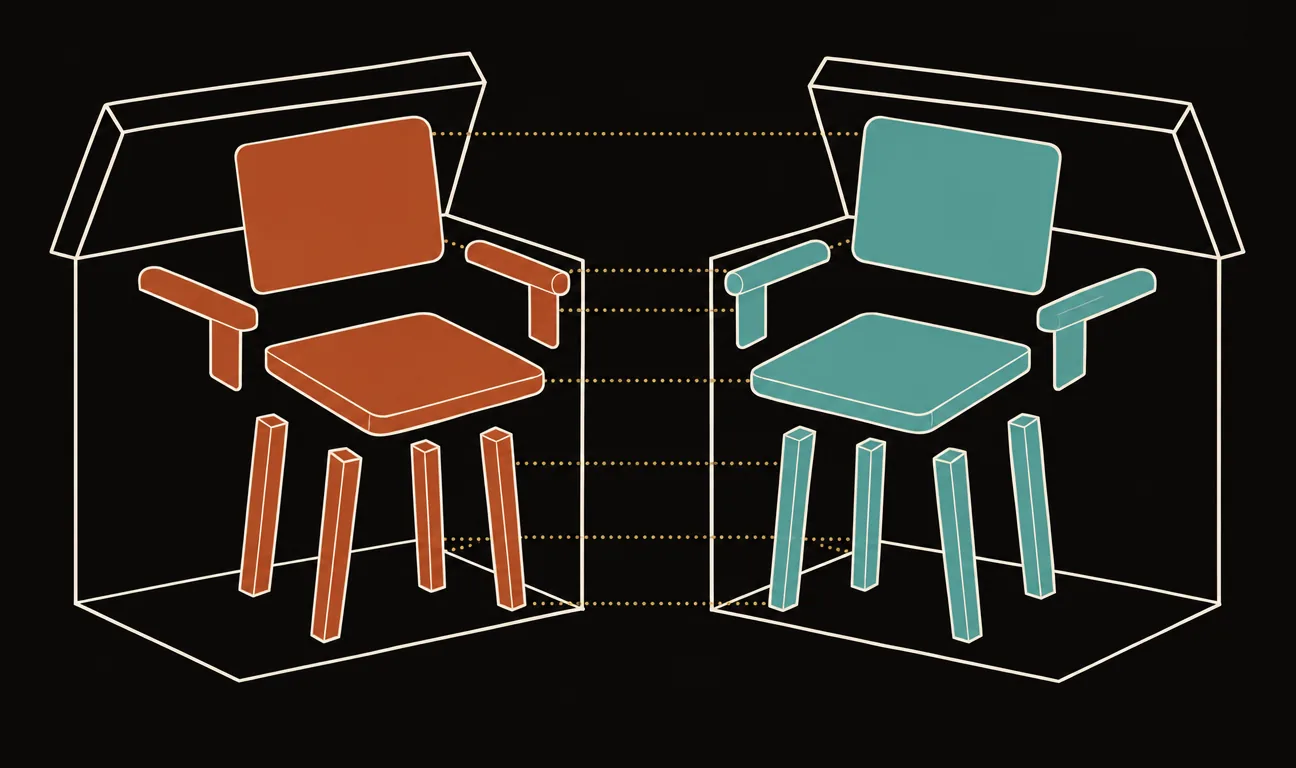
La soluzione viene da un lavoro precedente, PartPacker. Si costruisce il grafo dei contatti: ogni parte è un nodo, due nodi sono collegati se le parti si toccano (in KaiNinja, se almeno un voxel contiene facce di entrambe). Poi si colora il grafo con due colori in modo che nodi vicini abbiano colori diversi. Tutte le parti di un colore vanno nel volume A, quelle dell’altro nel volume B. È come riporre un puzzle in due scatole badando che nessuna tessera finisca accanto a una vicina: in ciascuna scatola ogni pezzo si prende da solo.
I vantaggi sono tre. Dentro un volume le parti non si toccano per costruzione, quindi le si separa con un’operazione banale, le componenti connesse: il modello non deve mai prevedere quanti pezzi ci sono. Qualunque numero di parti sta in due volumi fissi, quindi la rete gira una volta sola. E le facce a contatto finiscono in voxel diversi, quindi non collassano più.
Il grafo però non è sempre colorabile con due colori: basta un ciclo di lunghezza dispari, tre pezzi che si toccano a vicenda. In quel caso si fondono, una alla volta, le coppie a contatto più stretto finché il grafo diventa bipartito. È un’euristica, e il paper lo dice. In appendice gli autori aggiungono che nessun numero fisso di volumi basta nel caso peggiore: nello spazio qualunque numero di regioni può toccarsi a due a due, e il teorema dei quattro colori, suggerito da PartPacker, non si applica.
Ereditare senza rompere
Resta da insegnare tutto questo a un modello che ha visto solo oggetti interi. TRELLIS.2 genera in due tappe, entrambe con un flusso rettificato: la prima decide dove c’è superficie, su una griglia grossolana; la seconda decide com’è la superficie in ogni voxel occupato. KaiNinja tratta le due tappe in modo diverso.
Nella prima tappa, dove si decide davvero quali parti esistono e in quale volume stanno, ogni volume ha la sua copia completa del transformer pre-addestrato. L’addestramento procede per gradi: prima ogni copia si adatta al proprio volume, che è una distribuzione mai vista (mezzo oggetto con le facce di contatto scoperte); poi le due copie vengono unite da cinque blocchi di attenzione che guardano i token di entrambi i volumi, inizializzati a zero, così che all’inizio il modello si comporti esattamente come le due copie separate; poi si addestrano solo quei blocchi, con il resto congelato; infine si sblocca tutto. A questa tappa si aggiunge una penalità che scoraggia i due volumi dal rivendicare gli stessi voxel:
$$\mathcal{L} = \mathcal{L}_{\text{flow}} + \lambda_{\text{ov}}\,\mathbb{E}\big[\,o_A \odot o_B\,\big], \qquad \lambda_{\text{ov}} = 5,$$
dove $o_A$ e $o_B$ sono le occupazioni previste dei due volumi, valori fra 0 e 1 su una griglia $64^3$, e il prodotto elemento per elemento è grande solo dove entrambi dicono «qui c’è qualcosa». Nella seconda tappa, invece, l’architettura di TRELLIS.2 non cambia: un solo insieme di pesi, quelli rilasciati poi rifiniti, e le due correnti convivono restringendo l’attenzione, che in 20 blocchi su 30 guarda solo il proprio volume e negli altri 10 li guarda entrambi.
I dati sono 19.132 oggetti da quattro fonti. Quasi la metà, 8.968, viene da Articraft-10K, una collezione di oggetti costruiti da un agente basato su un modello linguistico che scrive un programma e assembla ogni parte da primitive geometriche. Le parti, lì, non sono annotazioni ma la struttura stessa del programma, quindi sono esatte. Secondo gli autori è la prima volta che un generatore 3D si addestra su oggetti scritti da un agente.
I numeri
Sul test tenuto da parte, i 986 oggetti che tutti e sei i metodi riescono a completare, KaiNinja è primo su tutte e sette le metriche. Contro il concorrente più forte, Hunyuan3D-2.1 seguito da X-Part, la distanza di Chamfer sull’oggetto intero scende da 0,0314 a 0,0186, circa il 40% in meno, e l’F-score delle parti alla soglia stretta di 0,05 sale da 0,597 a 0,692. Il margine è più ampio alla soglia stretta, segno, per gli autori, che la differenza sta nei dettagli fini e nei confini fra i pezzi.
A risoluzione 512 un oggetto diviso in parti richiede circa 24 secondi su una H100. PartPacker è il più economico, e KaiNinja costa il 40% in più, ma guadagna 0,20 punti di F-score sulle parti; AutoPartGen costa il triplo; la sola fase X-Part, il cui segmentatore occupa un nodo intero da quattro GPU, costa 469 secondi-GPU per oggetto, senza contare il generatore davanti: un ordine di grandezza sopra gli altri.
Il risultato più curioso è uno che gli autori non si aspettavano. Se si prende TRELLIS.2 a 512 e lo si rifinisce sugli stessi dati, senza parti, l’F-score stretto dell’oggetto intero sale da 0,781 a 0,830. KaiNinja, con lo stesso punto di partenza e lo stesso corpus, arriva a 0,919, a un costo di generazione circa 2,5 volte maggiore, e sbaglia completamente la forma sullo 0,7% degli oggetti contro l’1,8%. Gli autori lo leggono come indizio che i due volumi siano una rappresentazione migliore dell’oggetto, non solo un contenitore di parti.
Dove i conti non tornano
Il test principale è in casa. I 1000 oggetti di prova vengono dalle stesse quattro fonti su cui KaiNinja è addestrato, e i concorrenti non sono stati riaddestrati su quel corpus. Il confronto con PartPacker, l’unico con la stessa idea di fondo, non isola quindi la rappresentazione: i due sistemi differiscono anche nei dati, come il paper stesso avverte. Anche il protocollo di valutazione delle parti è scelto dagli autori.
Fuori casa il vantaggio si restringe, e in un caso si rovescia. Su 95 oggetti presi da Sketchfab e GitHub, fonti estranee al corpus di addestramento ma non ai dati di pre-addestramento di TRELLIS.2, KaiNinja resta davanti di 0,075 sull’oggetto intero e di 0,036 sulle parti alla soglia stretta, mentre le catene con X-Part hanno un’IoU media delle parti più alta. Su HY3D-Bench, un benchmark esterno con annotazioni proprie, la geometria è ancora la migliore, ma sulle parti vince Hunyuan3D-2.1 con X-Part su ogni metrica, e sull’IoU media KaiNinja è quarto su sei. Gli autori lo attribuiscono alla granularità: il modello separa a ogni contatto e taglia una sedia in più pezzi di quanti il benchmark ne annoti. Plausibile, ma non verificato; un controllo esplicito su quanti pezzi fare resta un lavoro futuro.
I due volumi sono un’ipotesi che a volte cede. Quando i pezzi si incastrano fitti, la fusione per rendere il grafo bipartito produce meno parti del dovuto. Il modello, poi, a volte mette quasi tutto in un volume e pochi pezzi piccoli nell’altro, a volte lascia un volume vuoto (9 oggetti su 1000), a volte genera l’oggetto intero in entrambi. La penalità di sovrapposizione aiuta a monte, portando la sovrapposizione mediana fra i volumi da 0,229 a 0,184, ma sulle metriche finali la versione senza penalità è appena migliore, e sulle parti pesa soprattutto il post-processing: il passo che riattacca i frammenti porta i pezzi per oggetto da 14,06 a 5,43, contro i 5,85 reali. Tre volumi danno parti un po’ migliori ma falliscono su 13 oggetti su 1000; due, mai.
Perché conta adesso
La generazione 3D da un’immagine è diventata di recente uno strumento pratico, e il suo limite più concreto non è più la qualità della forma ma la sua utilità: un oggetto fuso in un blocco va bene per un rendering, poco per un videogioco, un simulatore o un robot che deve capire che un cassetto si apre. KaiNinja mostra che il generatore si può estendere dall’interno, cambiando la rappresentazione e ripartendo dai suoi pesi. E quasi metà dei dati viene da oggetti scritti da un agente, con parti esatte per costruzione: se i dati strutturati si possono generare con un programma, il costo dell’annotazione si sposta altrove. Il mobile, insomma, comincia ad arrivare smontato; resta da decidere in quanti pezzi.
I commenti sono riservati agli iscritti.
Accedi per commentare