
Chi ha imparato a riconoscere le persone da lontano, dalla sagoma e dal modo di camminare, non per questo sa leggere la targa di un’auto che passa. Sono due abilità della vista che si allenano in modi opposti: la prima insegna a ignorare i dettagli, la seconda vive solo di dettagli. Un «1» e una «l», una virgola al posto di un punto decimale, un apice che trasforma $x_2$ in $x^2$: in un documento la differenza fra due significati sta spesso in pochi pixel.
È da questa asimmetria che parte MonkeyOCRv2: A Visual-Text Foundation Model for Document AI, uscito su arXiv il 13 luglio 2026 (2607.11562). Lo firmano quattordici autori della Huazhong University of Science and Technology e di Kingsoft Office, fra cui Yuliang Liu e Xiang Bai, lo stesso gruppo di MonkeyOCR e della serie Monkey. La tesi: molti modelli che leggono documenti usano un encoder visivo nato per le fotografie, e gli encoder pensati per i documenti che esistono già coprono ciascuno una fetta del problema, quasi sempre solo in inglese e cinese.
Il problema: occhi presi in prestito
Il paper fa l’elenco. Qwen3-VL e la serie HunyuanOCR usano SigLIP 2; DeepSeek-OCR è costruito su SAM; TextMonkey su un ViT di OpenCLIP; Vary e GOT-OCR2.0 su un encoder preaddestrato con SAM. I parser più recenti, come PaddleOCR-VL e MinerU2.5, partono invece da encoder presi da grandi modelli multimodali, addestrati su dati che non sono pubblici.
Il punto degli autori è che gli obiettivi con cui questi encoder sono stati addestrati vanno nella direzione sbagliata. La classificazione su ImageNet premia chi ignora le variazioni locali; CLIP e SigLIP allineano l’immagine intera a una didascalia; DINO cerca rappresentazioni stabili fra viste diverse della stessa scena; SAM impara i contorni degli oggetti. Tutti privilegiano il significato d’insieme e sono costruiti per essere indifferenti proprio ai dettagli che in un documento cambiano il senso.
Come un encoder come CLIP impara a mettere immagini e frasi nello stesso spazio, e perché questo allineamento guarda al senso complessivo più che ai singoli tratti, è spiegato nel capitolo su visione e linguaggio.
Due compiti per lo stesso occhio
La proposta ha due metà. La prima è un corpus, MonkeyDoc v2: 113 milioni di campioni in 17 lingue (italiano compreso, e con cinese semplificato e tradizionale contati separatamente), di cui 8 milioni di pagine intere e 105 milioni di elementi ritagliati, cioè blocchi di testo, tabelle, formule. Il 54% è reale, il 46% sintetico. Le pagine reali vengono da dataset pubblici, usando solo le loro partizioni di addestramento, e da raccolte proprie di giornali, appunti a mano e slide. Le etichette non vengono da un modello solo: ogni elemento è trascritto da più riconoscitori diversi e si tiene la trascrizione su cui gli altri concordano di più. I dati sintetici servono a coprire le lingue e i caratteri rari, con testi presi da corpora per LLM resi in immagine con font e stili diversi, più circa 800 mila formule tratte da articoli di arXiv. Un filtro finale scarta, fra le pagine delle fonti difficili (giornali, appunti scritti a mano), quelle in cui il layout annotato lascia fuori del testo o l’ordine di lettura non torna: dei circa 1,2 milioni di pagine iniziali ne restano circa 0,9 milioni.
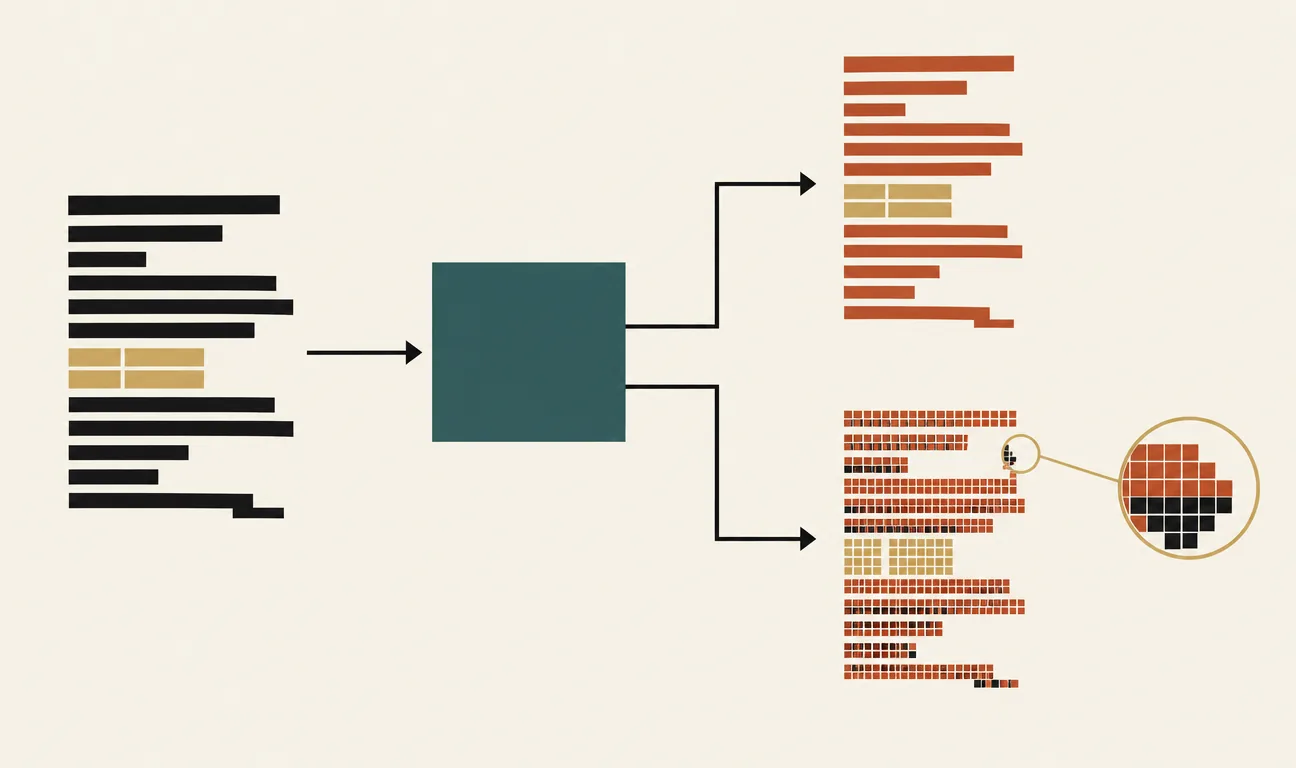
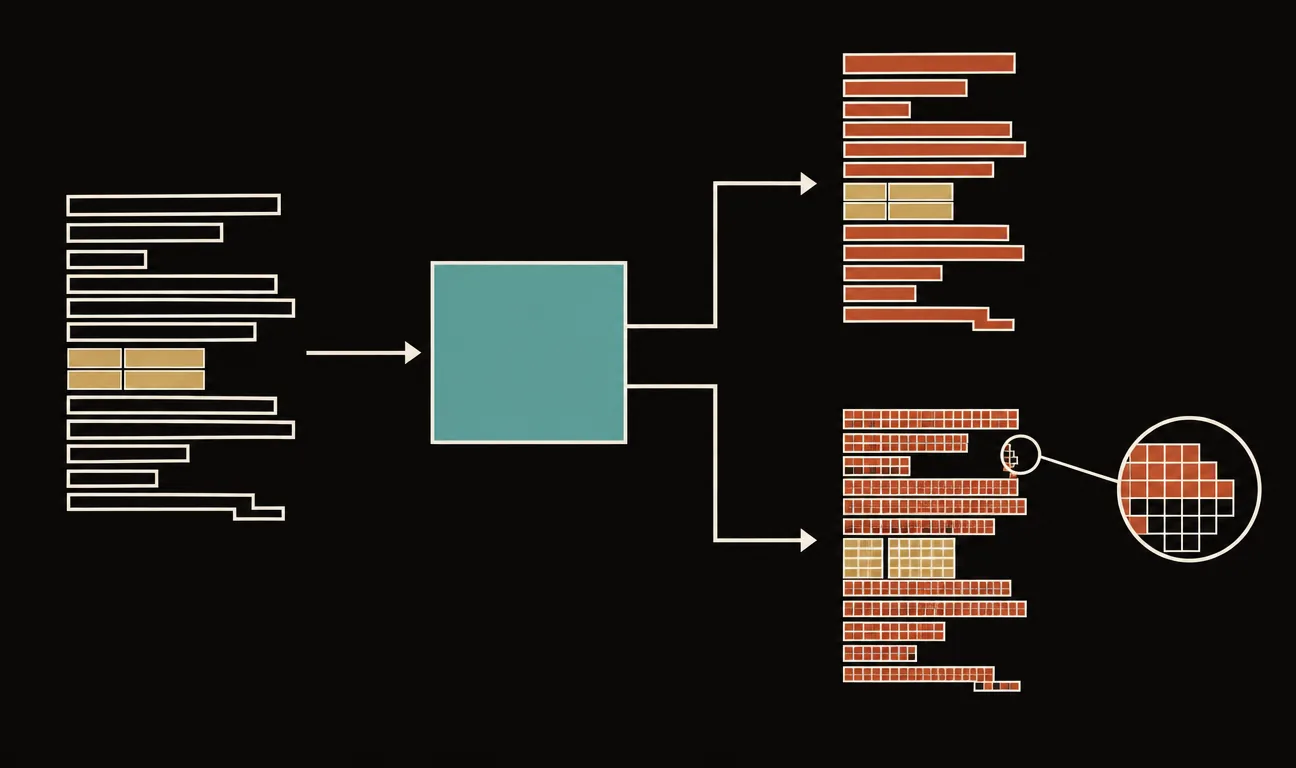
La seconda metà è l’obiettivo di addestramento. L’encoder trasforma la pagina in una sequenza di token visivi; da lì partono due decoder. Uno scrive, token dopo token, il testo che compare nell’immagine. L’altro deve ricostruire l’immagine stessa. La perdita complessiva è la somma delle due:
$$\mathcal{L}_{\text{pretrain}} = \mathcal{L}_{\text{text}} + \lambda\,\mathcal{L}_{\text{rec}}, \qquad \mathcal{L}_{\text{rec}} = \mathcal{L}_{\text{pix}} = \frac{1}{3HW}\,\big\lVert \hat{I} – I \big\rVert_2^2,$$
con $\lambda = 1$. La trascrizione costringe i token a contenere il testo; la ricostruzione li costringe a conservare anche quello che la trascrizione da sola potrebbe permettersi di buttare: la forma dei tratti e dei glifi, la disposizione sulla pagina. L’analogia è quella dello studente a cui si chiede non solo di dettare ciò che legge, ma anche di ricopiare la pagina a mano: il secondo esercizio lo obbliga a guardare davvero. Una variante che confronta anche i bordi dei caratteri (un gradiente di Sobel) e la distanza di ogni pixel dal bordo più vicino compare solo negli esperimenti di comprensione dei documenti; altrove si usa la sola differenza quadratica.
L’idea di far ricostruire l’input a una rete per obbligarla a conservare l’informazione che conta è quella dell’autoencoder, spiegata nel libro a partire dalla compressione.
Gli encoder addestrati sono tre, con la stessa ricetta e gli stessi dati: un ViT-Small da 28 milioni di parametri (MonkeyOCRv2-S), un ViT-Base da 113 milioni (MonkeyOCRv2-B) e una variante ViTAEv2-Small da 21 milioni (MonkeyOCRv2-AS), più adatta ai compiti che vogliono feature a più scale, come il rilevamento. L’addestramento gira su 64 GPU A800.
La prova del trapianto
Il modo in cui il paper si mette alla prova è la parte più convincente: in cinque compiti su sette, invece di costruire un sistema proprio e confrontarlo con quelli degli altri, prende sistemi esistenti, toglie il loro encoder, ci mette MonkeyOCRv2 e lascia il resto com’era.
Nel riconoscimento del testo, CRNN con un ResNet passa da 58,7% a 67,3% di accuratezza media sui tre benchmark difficili (inglese, cinese, testo parzialmente coperto); sul solo Union14M in inglese il salto è di 16 punti. PARSeq, già forte, guadagna meno ma arriva all’87,6% su Union14M, un punto e mezzo sopra il miglior risultato precedente. Nelle formule, UniMERNet-T da 110 milioni di parametri con il nuovo encoder supera UniMERNet-B da 325 milioni; va detto che qui l’encoder originale era stato preaddestrato su 16 milioni di campioni interni non pubblici, e gli autori saltano quella fase usando solo la messa a punto pubblica. Sulle formule scritte a mano di MathWriting la metrica CDM sale di 5,2 punti.
Negli altri tre compiti i guadagni medi vanno da 3,3 a 7,5 punti: rilevamento del testo in scene reali con tre rilevatori diversi (dove oCLIP, un encoder pensato proprio per il testo, non aiuta il rilevatore più moderno), localizzazione delle parti falsificate di un documento (sul test standard l’F1 sale di 11,3 punti rispetto al modello di partenza) e segmentazione di testi sovrapposti.
Congelato, con un LLM piccolo
La prova più attuale è il parsing, cioè trasformare una pagina in testo strutturato con tabelle, formule e ordine di lettura. MonkeyOCRv2-B, congelato, viene collegato a Qwen3-0.6B: il sistema completo pesa 0,7 miliardi di parametri. Prima predice gli elementi della pagina nell’ordine di lettura, poi li ritaglia e li riconosce in parallelo, poi li ricompone. Su MDPBench, che mescola documenti digitali e fotografati in 17 lingue, ottiene il miglior risultato fra i modelli aperti, mentre fra quelli chiusi Gemini-3-pro resta sopra.
| Modello | Punteggio |
|---|---|
| Aperti | |
| MonkeyOCRv2-B con Qwen3-0.6B | 83,3 |
| dots.mocr | 80,5 3 miliardi di parametri, encoder circa 11 volte più grande |
| PaddleOCR-VL-1.6 | 75,0 |
| Chiusi | |
| Gemini-3-pro | 86,4 |
Su CHAOS-Bench, che altera un carattere in due o tre parole per pagina per vedere se il modello scrive quello che vede o quello che si aspetta, è il migliore della tabella, 3,7 punti sopra HunyuanOCR-1.5. In assoluto i numeri restano bassi: 17,9 contro 14,2, cioè meno di una parola alterata su cinque riportata fedelmente.
C’è poi un esperimento che isola bene il contributo della ricostruzione. Si fa leggere al parser piccolo, quello costruito su MonkeyOCRv2-S, un testo sensato e lo stesso testo con i caratteri rimescolati, abbassando via via la risoluzione. Con il testo rimescolato il modello non può indovinare dal contesto e deve guardare. Senza ricostruzione, passando da 1288 a 448 pixel sul lato lungo, l’accuratezza sul rimescolato crolla da 99,7% a 55,4%; con la ricostruzione resta al 72,1%. Gli autori sono prudenti: il rimescolamento introduce una distribuzione insolita e il divario va preso come indizio della dipendenza dal contesto linguistico, non come misura completa delle allucinazioni.
Che cosa leggere con cautela
MDPBench è degli stessi autori. Il benchmark su cui arriva il primato fra i modelli aperti è stato pubblicato a marzo 2026 dallo stesso gruppo, e copre 17 lingue, quante ne ha il corpus di addestramento. Il paper lo dichiara, sostiene che encoder, LLM e dati sono indipendenti dalla sua costruzione e riporta per controllo OmniDocBench 1.6, che contiene solo documenti in cinese e inglese. Lì il quadro è diverso: MonkeyOCRv2 supera modelli generalisti molto più grandi come Qwen3-VL-235B e GPT-5.2, ma resta dietro a Gemini-3-pro e ai parser specializzati più recenti, GLM-OCR, MinerU2.5-Pro, PaddleOCR-VL-1.6 e HunyuanOCR-1.5. Gli autori lo attribuiscono al loro addestramento minimo, senza le fasi di post-addestramento che quei sistemi usano; ma ammettono che un confronto fra sistemi così diversi non permette di individuare la causa del divario.
Il confronto fra encoder ha risoluzioni diverse. Nella prova di comprensione dei documenti (otto benchmark di domande su pagine, tabelle e grafici, stesso LLM Qwen3-1.7B per tutti) MonkeyOCRv2-B ha la media più alta. Ma ogni encoder usa la risoluzione con cui è nato, e quindi un numero diverso di token. CLIP guarda la pagina a 224 pixel e produce 196 token: per lui il confronto è sbilanciato in partenza. Per SigLIP 2, che lavora a risoluzione nativa, lo è molto meno; e OpenVision, secondo, ne usa più di tutti: la quantità di token da sola non spiega il distacco.
| Encoder | Media | Token per pagina |
|---|---|---|
| MonkeyOCRv2-B | 57,2 | 1082 in media |
| OpenVision | 44,0 | 2304 |
| SigLIP 2 | 24,9 | 825 risoluzione nativa |
E il modello che fa 57,2 usa la variante della ricostruzione con i bordi, applicata solo qui: sul modello piccolo la sola differenza quadratica vale un punto, i bordi altri 4,2.
I limiti dichiarati. Il parser riconosce ogni elemento in un passaggio a sé, e privilegia l’accuratezza sulla velocità. Il paper non separa il contributo del disegno dei decoder né del peso dato alla ricostruzione. E il corpus, pur in 17 lingue, pende verso le scritture più diffuse: le lingue con poche risorse e le scritture storiche restano poco coperte. Il paper annunciava codice e dati («will be released»); da allora il repository ha pubblicato encoder e parser (licenza Apache 2.0) e, secondo il README a settembre 2026, 104 dei 113 milioni di campioni del corpus.
Perché conta adesso
La corsa al parsing dei documenti si è giocata finora quasi tutta sul lato del linguaggio e dei dati: modelli più grandi, più passaggi di post-addestramento, pipeline più elaborate. MonkeyOCRv2 sposta l’attenzione sull’occhio, e con un encoder che sta sotto i 120 milioni di parametri mostra che si può recuperare parecchio lì. Ora che pesi e quasi tutto il corpus sono pubblici, l’interesse maggiore non è il primato su un benchmark ma la possibilità di sostituire con un pezzo solo, aperto e piccolo, l’encoder da fotografie che oggi tanti sistemi si portano dietro. Resta da vedere, su benchmark scritti da altri, quanto di quel vantaggio sopravvive.
I commenti sono riservati agli iscritti.
Accedi per commentare