Hai mai provato a ottimizzare qualcosa che non puoi derivare? Il numero di layer di una rete, l’ordine delle consegne di un furgone, i parametri di un simulatore che gira dieci minuti a chiamata: in tutti questi casi la discesa del gradiente — la regina dell’ottimizzazione nel machine learning — resta al palo. Se non ricordi cos’è il gradiente, ti basta sapere che è la direzione di massima pendenza di una funzione: per calcolarlo servono le derivate, e per avere le derivate serve una funzione liscia, continua e scritta in una forma che puoi derivare. Il mondo reale, spesso, non collabora.
In questo tutorial esploriamo tre strategie che non chiedono derivate: hill climbing, simulated annealing e algoritmi genetici. Sono metodi di ricerca, non di calcolo: provano soluzioni, guardano il punteggio e decidono dove provare dopo. E le implementiamo da zero, in Python puro con NumPy — perché il modo migliore per capire un algoritmo di ricerca è vederlo cercare.
Quando il gradiente non c’è (o non aiuta)
Ci sono due situazioni in cui il gradiente ti abbandona. La prima: la funzione è una scatola nera. Puoi valutarla — le dai un input, ti restituisce un punteggio — ma non conosci la formula dentro, quindi niente derivate. È il caso classico degli iperparametri: «accuratezza in funzione del numero di alberi» non è una formula, è un esperimento. La seconda: la funzione ha derivate, ma il paesaggio è pieno di buche — tanti minimi locali — e il gradiente, che è miope per costruzione, ti porta diligentemente in fondo alla prima buca che incontra e lì ti lascia. Ne abbiamo parlato nell’articolo su minimi locali e punti di sella: il gradiente vede solo la pendenza sotto i suoi piedi, mai il panorama.
I tre metodi di oggi rispondono alla stessa domanda — «dove provo la prossima soluzione?» — con tre filosofie diverse: sempre in salita, in salita ma con sbandate controllate, e in parallelo con un pizzico di genetica.
Hill climbing: un passo alla volta, nella nebbia
L’hill climbing (letteralmente «scalata della collina»; noi cercheremo minimi, quindi scendiamo, ma il nome resta) è la strategia più semplice possibile: parti da una soluzione a caso, provi una piccola modifica casuale, e la tieni solo se migliora il punteggio. Ripeti finché non migliori più.
Immagina di cercare il punto più basso di una valle in mezzo alla nebbia fitta: non vedi niente, ma puoi sentire con i piedi se il terreno scende. Fai un passo di prova; se scendi lo confermi, se sali torni indietro. Funziona benissimo… finché non arrivi in fondo a una conca. Lì ogni passo di prova sale, quindi ti fermi — anche se a duecento metri, oltre la collinetta, c’è una valle molto più profonda. L’hill climbing è veloce e semplice, ma resta prigioniero del primo minimo locale che trova: esattamente lo stesso difetto del gradiente, senza nemmeno il vantaggio della direzione esatta.
Simulated annealing: il coraggio di peggiorare
Il simulated annealing («ricottura simulata») aggiunge l’ingrediente che manca: la disponibilità ad accettare, ogni tanto, una mossa peggiorativa. L’idea viene dalla metallurgia: quando un fabbro tempra una lama, scalda il metallo e poi lo raffredda lentamente. Ad alta temperatura gli atomi si muovono liberi, esplorano configurazioni anche scomode; man mano che la temperatura scende si assestano in una struttura ordinata e a bassa energia. Raffredda troppo in fretta e gli atomi restano congelati in una configurazione difettosa — un minimo locale, appunto.
L’algoritmo copia il fenomeno: le mosse migliorative si accettano sempre; una mossa peggiorativa di quantità Δ si accetta con probabilità e−Δ/T, dove T è la «temperatura». All’inizio T è alta e l’algoritmo saltella allegramente anche in salita, scavalcando le collinette; poi T scende secondo un programma di raffreddamento, le sbandate diventano rare, e alla fine l’algoritmo si comporta come un hill climbing che rifinisce la migliore zona trovata. Esplorazione prima, rifinitura poi.
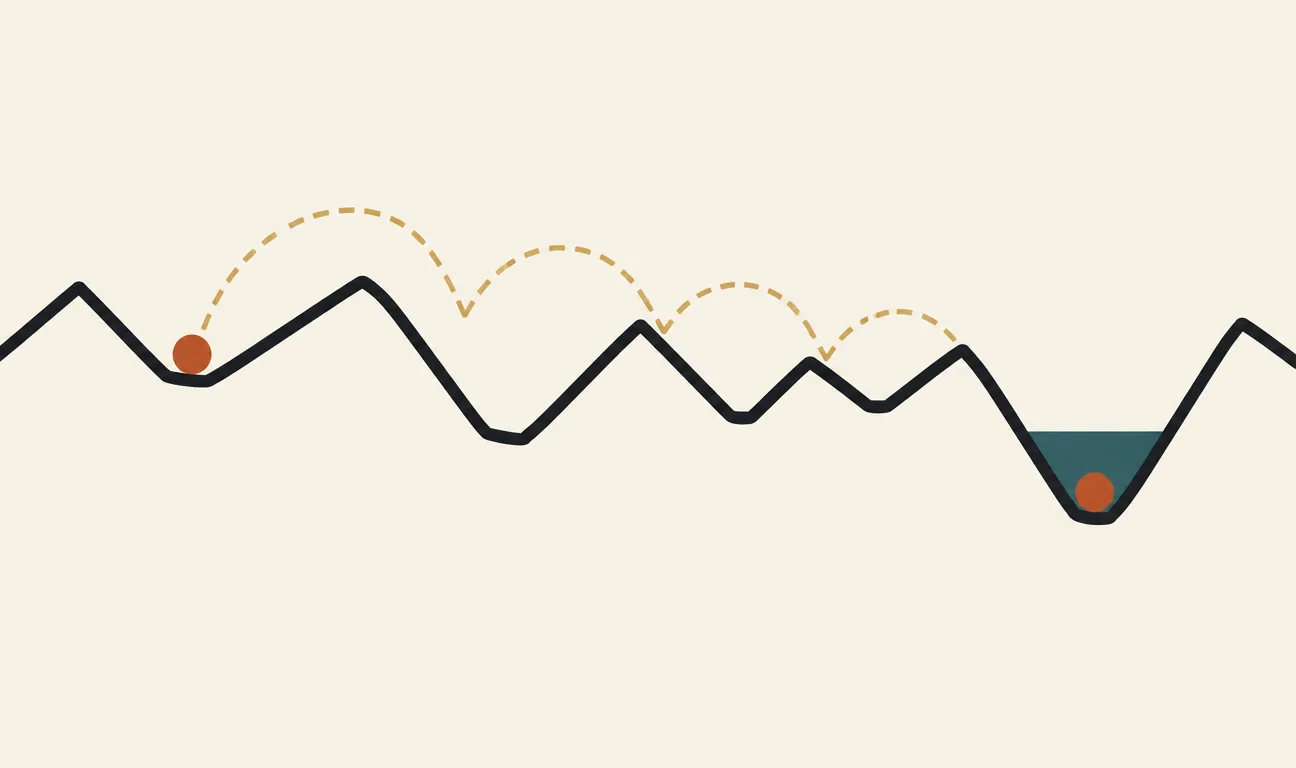
L’hill climbing si ferma in fondo alla prima buca. Il simulated annealing ha un pregio raro anche negli umani: all’inizio accetta di peggiorare, pur di non fermarsi alla prima soluzione comoda.
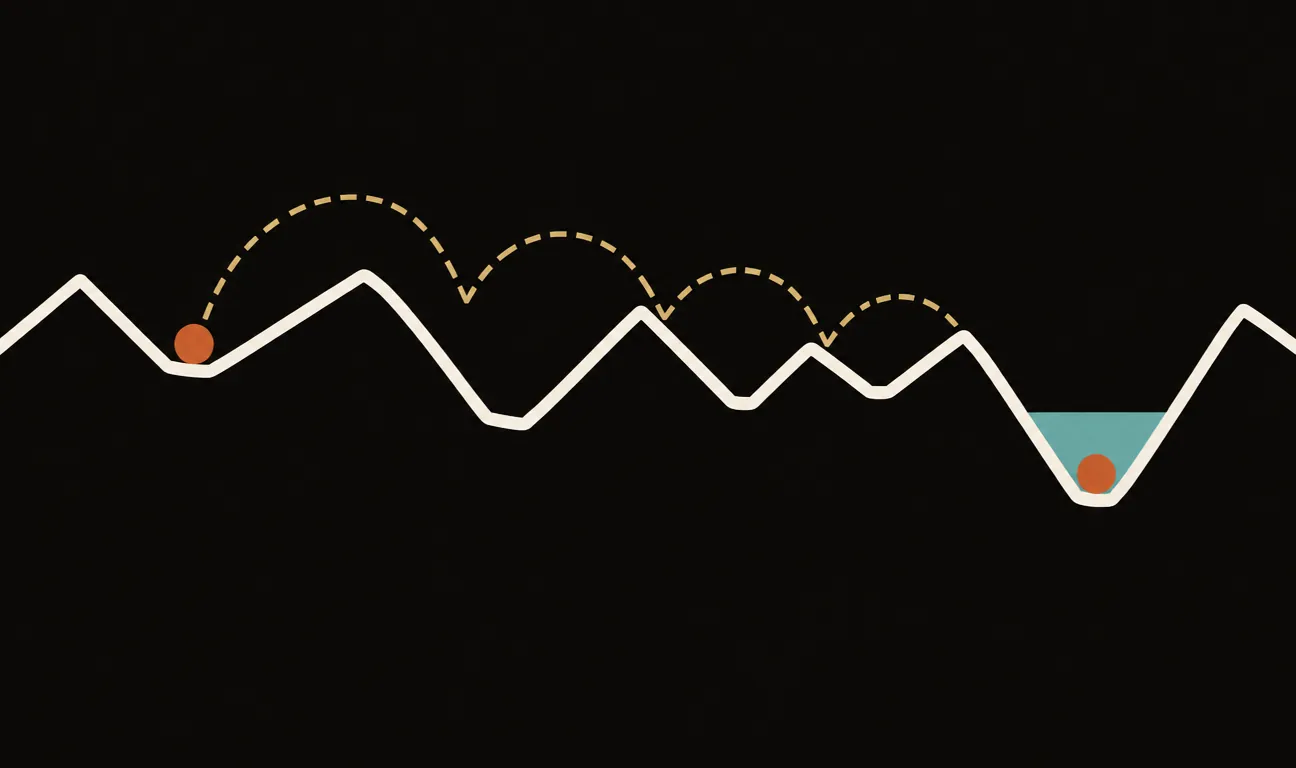
Il paesaggio con i salti: l’hill climbing (terracotta) scende nella prima valle e ci resta; il simulated annealing (teal) accetta all’inizio mosse in salita, scavalca le colline e arriva alla valle più profonda, dove la temperatura ormai bassa lo fa assestare.
Il codice: annealing da zero su un paesaggio pieno di buche
Prepara l’ambiente con Python 3.12 — uv venv && source .venv/bin/activate && uv pip install numpy, oppure il tuo solito venv — e incolla lo script in VS Code o PyCharm. La funzione da minimizzare è una parabola «increspata» da un seno: tanti minimi locali, un solo minimo globale.
import numpy as np

rng = np.random.default_rng(42)

def paesaggio(x: float) -> float:
    # Parabola con increspature: tanti minimi locali, uno solo globale
    return 0.05 * x**2 + 3 * np.sin(x)

def hill_climbing(f, x0: float, passi: int = 2000) -> float:
    """Accetta una mossa solo se migliora: veloce ma miope."""
    x = x0
    for _ in range(passi):
        candidato = x + rng.normal(0, 0.5)   # piccola perturbazione casuale
        if f(candidato) < f(x):              # migliora? la teniamo
            x = candidato                    # peggiora? come se niente fosse
    return x

def simulated_annealing(f, x0: float, T0: float = 5.0,
                        raffreddamento: float = 0.997,
                        passi: int = 4000) -> float:
    """Come l'hill climbing, ma accetta peggioramenti con prob. e^(-delta/T)."""
    x, T = x0, T0
    migliore = x
    for _ in range(passi):
        candidato = x + rng.normal(0, 1.0)
        delta = f(candidato) - f(x)
        # mossa migliorativa: sempre; peggiorativa: dipende da T
        if delta < 0 or rng.random() < np.exp(-delta / T):
            x = candidato
        if f(x) < f(migliore):
            migliore = x                     # ricordiamo il record assoluto
        T *= raffreddamento                  # il metallo si raffredda
    return migliore

# Partiamo apposta lontano dal minimo globale (che sta vicino a x = -1.5)
x0 = 14.0
x_hc = hill_climbing(paesaggio, x0)
x_sa = simulated_annealing(paesaggio, x0)

print(f"partenza:            x = {x0:6.2f}  f = {paesaggio(x0):6.2f}")
print(f"hill climbing:       x = {x_hc:6.2f}  f = {paesaggio(x_hc):6.2f}")
print(f"simulated annealing: x = {x_sa:6.2f}  f = {paesaggio(x_sa):6.2f}")
Eseguilo: l'hill climbing quasi sempre si insabbia in una delle conche intermedie (f attorno a 1–4), mentre l'annealing raggiunge il minimo globale vicino a x ≈ −1,5 con f ≈ −2,9. Rilancia lo script cambiando il seme del generatore e osserva la variabilità: sono metodi stocastici, e la ripetizione fa parte del mestiere. I due iperparametri che contano sono la temperatura iniziale (deve permettere i primi salti: come ordine di grandezza, i dislivelli tipici del tuo paesaggio) e il raffreddamento: 0.997 a 4000 passi è lento e prudente; 0.9 congela il sistema in poche decine di passi, e l'annealing degenera in hill climbing.
Algoritmi genetici: cercare in parallelo, come l'evoluzione
La terza famiglia cambia scala: invece di far evolvere una soluzione, fa evolvere una popolazione. Un algoritmo genetico funziona come un allevatore di cani da pastore: parte da una cucciolata variegata, mette alla prova tutti (la fitness, il nostro punteggio), fa riprodurre i migliori mescolandone i tratti (crossover: il figlio prende metà "geni" da un genitore e metà dall'altro) e ogni tanto introduce una variazione casuale (mutazione, che è esattamente la perturbazione dell'annealing). Generazione dopo generazione, la popolazione migra verso le zone buone del paesaggio — e siccome esplora tanti punti in parallelo, è difficile che resti tutta intrappolata nella stessa buca.
In venti righe: rappresenti ogni soluzione come un vettore NumPy, ordini la popolazione per fitness, tieni il 20% migliore, generi i figli con np.where(rng.random(n) < 0.5, genitore_a, genitore_b) e aggiungi rumore gaussiano come mutazione. Gli algoritmi genetici brillano quando le soluzioni sono strutture più che numeri — permutazioni, sottoinsiemi, architetture — dove crossover e mutazione si progettano su misura. È l'idea dietro gli strumenti di AutoML evolutivo: il vecchio corso citava TPOT, oggi guarderesti TPOT2 o la ricerca evolutiva dentro framework moderni, ma il motore concettuale è lo stesso del nostro script.
Onestà: quando NON usarli
Regola d'oro: se il gradiente c'è, usa il gradiente. Per addestrare una rete neurale questi metodi sono fuori gara — backpropagation e Adam sfruttano la struttura del problema, la ricerca casuale no, e a milioni di parametri la differenza è abissale. Per gli iperparametri, prima di scrivere un annealing a mano prova scipy.optimize (che include dual_annealing e differential_evolution già pronti e ben testati) oppure Optuna, che con poche righe fa ricerca bayesiana, spesso più efficiente su budget piccoli. I metodi di oggi restano la scelta giusta quando la funzione è una scatola nera rumorosa, lo spazio è discreto o combinatorio (percorsi, sottoinsiemi, scheduling), o vuoi capire cosa fanno le librerie prima di fidarti — che è precisamente lo scopo di questo tutorial.
Prova tu
Tre esperimenti in ordine di ambizione. Primo: nel codice qui sopra porta il raffreddamento a 0.9 e poi a 0.9999 e osserva cosa succede al risultato — troverai con mano il compromesso esplorazione/rifinitura. Secondo: sostituisci il paesaggio con la funzione di Rastrigin in due dimensioni, f(v) = 20 + v[0]**2 + v[1]**2 - 10*(np.cos(2*np.pi*v[0]) + np.cos(2*np.pi*v[1])) (minimo globale in (0, 0)), adattando la perturbazione a un vettore di due componenti. Terzo: implementa l'algoritmo genetico descritto sopra (popolazione 50, 100 generazioni) sulla stessa Rastrigin e confrontalo con l'annealing a parità di valutazioni della funzione: chi arriva più vicino allo zero?
Per approfondire: Essentials of Metaheuristics di Sean Luke è il libro di riferimento su questi metodi — pratico, pieno di pseudocodice e scaricabile gratuitamente dal sito dell'autore. Per le versioni pronte all'uso, la documentazione di scipy.optimize sulle funzioni dual_annealing e differential_evolution è il passo successivo naturale.
I commenti sono riservati agli iscritti.
Accedi per commentare