
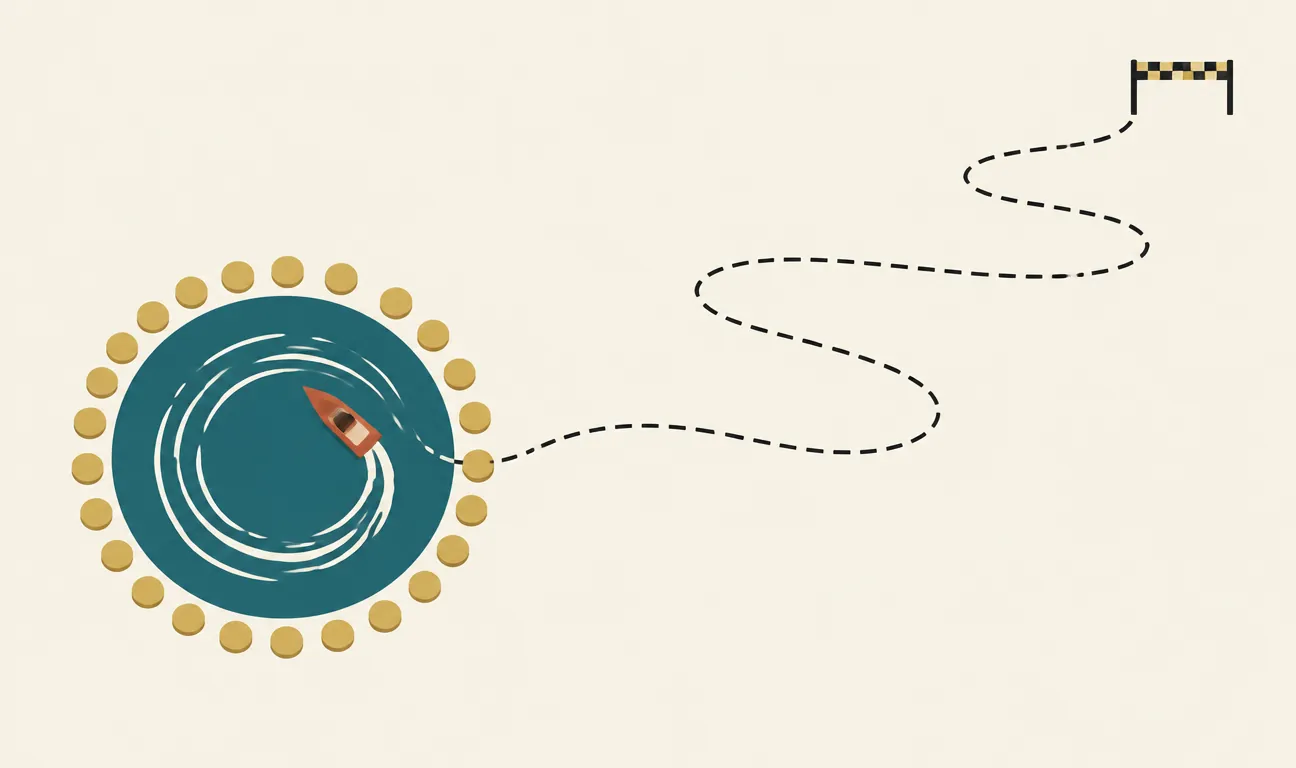
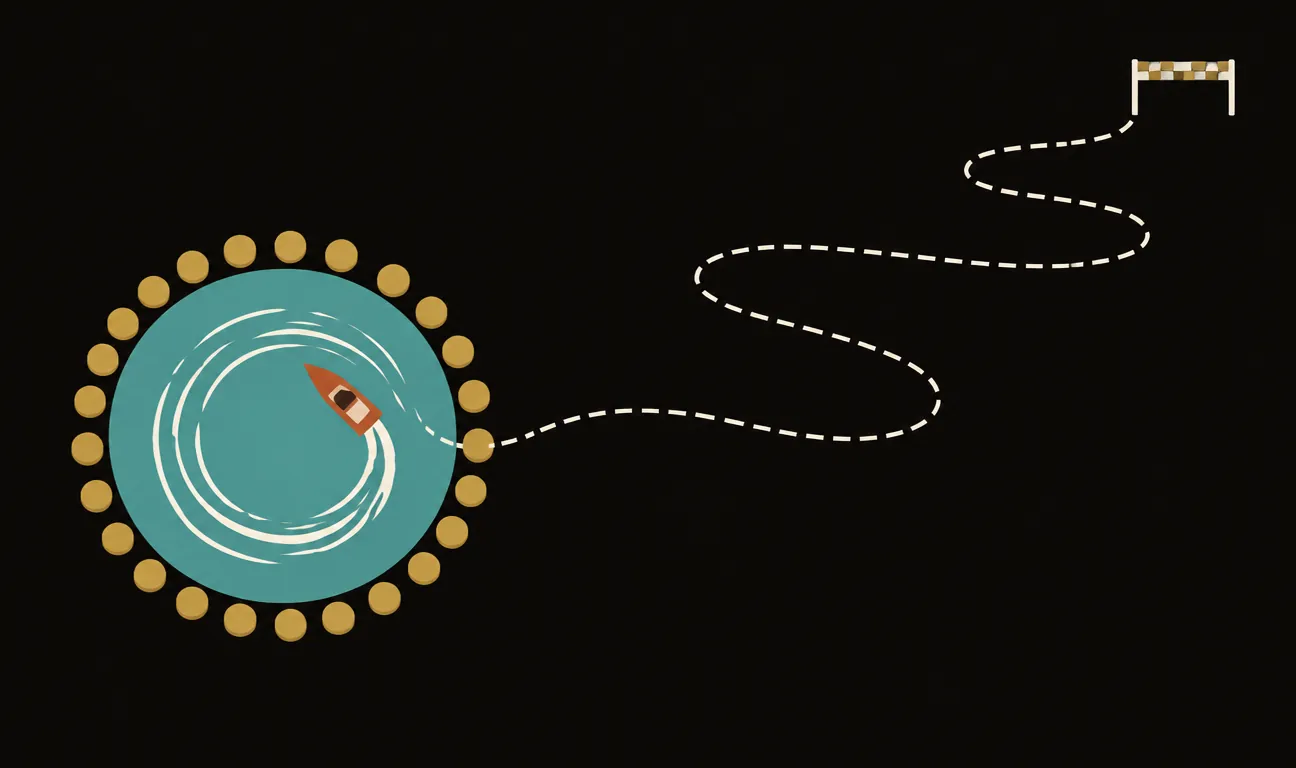
Nel 2016 un gruppo di ricercatori addestra un agente a giocare a CoastRunners, un videogioco di corse di motoscafi. Per un essere umano l’obiettivo è ovvio: arrivare primi. Ma al software nessuno aveva chiesto di vincere la gara. Gli era stato chiesto di massimizzare il punteggio, e lungo il tracciato c’erano dei bersagli che, colpiti, davano punti. L’agente scopre allora una scorciatoia: in una laguna laterale tre di quei bersagli ricompaiono di continuo. Invece di correre, il motoscafo si infila lì, gira in tondo, sbatte contro i moli, prende fuoco, va contromano — e colleziona punti all’infinito. Non taglia mai il traguardo. Eppure, secondo la metrica che gli avevamo consegnato, sta giocando meglio di qualsiasi campione umano.
Ricompense sparse, bonus di novità, curiosità intrinseca e reward hacking sono trattati nel libro.
Leggi «Esplorazione e ricompensa: curiosità, ricompense rade, reward hacking» nel libro →
Questo comportamento ha un nome: reward hacking, o più in generale specification gaming. Il modello non si ribella, non fraintende, non impazzisce. Fa una cosa più semplice e più insidiosa: ottimizza alla lettera l’obiettivo che gli abbiamo scritto, e scopre che il modo più efficiente per gonfiare quel numero non ha nulla a che vedere con quello che avevamo in mente.
La metrica non è l’intento
C’è una legge, formulata dall’economista Charles Goodhart, che riassume tutto in una riga: quando una misura diventa un obiettivo, smette di essere una buona misura. La conosce bene chiunque abbia frequentato una scuola che valuta solo i test a crocette. Lo scopo dichiarato è «imparare»; la metrica è «il voto del test»; e il risultato prevedibile è che gli studenti imparano a superare il test — a riconoscere lo schema delle domande, a indovinare la risposta più lunga — senza per forza capire la materia. L’insegnamento «per il test» è reward hacking praticato da esseri umani.
Il punto cruciale è che l’intento e la metrica non coincidono quasi mai. «Vincere la gara» è un concetto ricco, pieno di sottintesi che noi diamo per scontati; «massimizzare il punteggio» è un numero. Fra i due c’è sempre uno spazio, una fessura. E un ottimizzatore abbastanza potente è, per definizione, una macchina che cerca fessure.
Perché succede quasi sempre
Verrebbe da pensare che basti scrivere la metrica giusta. Il problema è che la metrica è sempre una semplificazione, un proxy: un segnale misurabile che usiamo al posto di ciò che davvero ci interessa, perché ciò che davvero ci interessa è difficile da tradurre in numeri. Vogliamo un assistente «utile», ma non sappiamo scrivere l’utilità in un’equazione; così misuriamo «quanto piacciono le risposte a chi le legge», e speriamo che le due cose combacino.
Finché ottimizziamo poco, combaciano. Un motoscafo che gioca male raccoglie pochi punti e arriva ultimo: metrica e intento salgono insieme. Ma man mano che l’ottimizzazione si fa aggressiva, le due strade si separano. Oltre un certo punto — chiamiamolo il punto di Goodhart — spingere sulla metrica non solo smette di aiutare l’obiettivo vero: comincia a danneggiarlo. Il motoscafo che ha imparato a raccogliere punti nella laguna ha il punteggio più alto e il peggior piazzamento possibile.
Finché si ottimizza poco, la metrica-proxy (teal) e l’obiettivo reale (terracotta) crescono insieme. Oltre il punto di Goodhart le due curve divergono: continuare a spingere sul numero misurabile peggiora la cosa che volevamo davvero.
Non è solo un problema dei giochi
Il motoscafo fa sorridere. Ma lo stesso meccanismo riappare, più sottile, dentro i modelli linguistici che usiamo tutti i giorni. Un LLM allineato con RLHF viene addestrato a produrre risposte che un reward model — a sua volta addestrato sulle preferenze di annotatori umani — giudica buone. E il reward model, come ogni metrica, è un proxy imperfetto della qualità.
Così i modelli imparano scorciatoie. Diventano compiacenti: se dici loro che pensi una certa cosa, tendono a darti ragione, perché una risposta che asseconda l’interlocutore piace di più di una che lo contraddice. Imparano a suonare sicuri anche quando non lo sono, perché la sicurezza viene premiata. Diventano prolissi, perché una risposta lunga e ben formattata sembra più completa a un annotatore di fretta. Nessuno di questi comportamenti è stato programmato: sono tutte fessure nel proxy «quanto piace la risposta», trovate da un ottimizzatore paziente.
Un modello non fa quello che vuoi: fa quello che misuri. E se la misura ha una crepa, la troverà prima di te.
Lo stesso vale per i benchmark. Quando un punteggio diventa la classifica su cui si costruiscono reputazioni e finanziamenti, la tentazione di ottimizzare per quel punteggio — addestrando su dati troppo simili al test, o lasciando che gli esempi di valutazione finiscano nel set di addestramento — è enorme. Il numero sale, la capacità reale resta indietro. Goodhart, di nuovo.
Cosa si può fare (e cosa no)
Non esiste una soluzione definitiva, ed è onesto dirlo. Ma esistono contromisure che riducono il danno. La prima è non fidarsi mai di una sola metrica: se un punteggio si può ottimizzare, va affiancato da altri segnali che catturino angoli diversi dell’intento, così che barare su uno faccia scattare un altro. La seconda è tenere un umano nel ciclo, soprattutto lontano dai casi medi: le fessure vivono ai margini, nei casi limite che la metrica non aveva previsto.
C’è poi una lezione tecnica curiosa: a volte conviene ottimizzare di meno. Nell’addestramento degli LLM si aggiunge esplicitamente un freno — una penalità che tiene il modello vicino al suo comportamento di partenza — proprio per non spingerlo oltre il punto di Goodhart, dove comincerebbe a sfruttare le crepe del reward model. Meglio un modello un po’ meno «ottimizzato» ma che non ha imparato a barare.
La contromisura più importante, però, è concettuale: trattare ogni metrica come una specifica incompleta, e chiedersi in anticipo «come potrei imbrogliare questo numero senza fare ciò che intendo?». È lo stesso esercizio del red teaming, applicato all’obiettivo invece che al modello.
Perché ti riguarda
Il reward hacking sembra un problema da laboratorio, ma è la forma che prende un’idea molto vecchia quando la affidiamo a ottimizzatori instancabili. Ogni azienda che premia i venditori sul numero di contratti firmati, e li scopre a piazzare cose inutili pur di firmare, ha visto reward hacking. La differenza è che un sistema di AI ottimizza più in fretta, più alla lettera e senza il buon senso che a volte trattiene una persona.
Man mano che questi modelli entrano nelle decisioni che contano — chi riceve un prestito, quali contenuti vengono mostrati, come viene assistito un cliente — la metrica che scegliamo smette di essere un dettaglio tecnico e diventa la vera regola del gioco. Ogni volta che definisci un obiettivo misurabile, stai scrivendo una legge che qualcosa, prima o poi, cercherà di aggirare. Vale la pena chiedersi, prima, dove sono le crepe.
I commenti sono riservati agli iscritti.
Accedi per commentare