
Aprite una qualsiasi chat con un modello linguistico e guardate la risposta comparire: parola dopo parola, a ritmo quasi umano. Quel ritmo non è una scelta estetica, è un limite fisico. Un modello autoregressivo genera un token alla volta, e per produrre il successivo deve prima aver deciso il precedente, perché ogni nuova parola dipende da tutte quelle già scritte. Per generare cento token servono cento passaggi in fila attraverso una rete che può pesare decine di miliardi di parametri. Il paradosso è che ognuno di quei passaggi impegna a malapena la GPU: la scheda è costruita per macinare migliaia di operazioni in parallelo, ma la generazione le chiede una moltiplicazione grande alla volta, tenendola per lo più a girare a vuoto. Nel novembre 2022, con una versione rivista nel 2023, tre ricercatori di Google Research hanno pubblicato un modo per riempire quel vuoto senza cambiare di una virgola il risultato. Si chiama speculative decoding.
Perché generare è così lento
Vale la pena capire dove si nasconde il tempo. Durante la generazione, il collo di bottiglia non è quanti calcoli fa la GPU, ma quanta memoria deve leggere. Per produrre un solo token il modello carica dalla memoria tutti i suoi pesi, li usa per una manciata di moltiplicazioni, e li scarta. È come accendere un forno industriale per cuocere un solo biscotto: il costo dominante è portare il forno a temperatura, non cuocere. Gli ingegneri chiamano questa condizione memory-bound: si spende più a spostare i numeri che a usarli. E la brutta notizia è che caricare i pesi per generare un token o per generarne cinque costa quasi lo stesso — se solo si avessero cinque token da elaborare insieme.
Ecco l’intuizione di partenza: verificare più token in un colpo solo costa quasi come verificarne uno. Generarli in fila, invece, costa una passata ciascuno. Se solo ci fosse un modo di avere i token già pronti da verificare tutti insieme…
Le parti facili non hanno bisogno del modello grande
La seconda intuizione riguarda la natura del linguaggio. Scrivere una frase non è uniformemente difficile. Dopo «il gatto si è arrampicato sull'», la parola «albero» è quasi obbligata; dopo «la capitale della Francia è», segue «Parigi» senza troppo pensarci. Solo alcuni punti — una scelta di argomento, un numero, una svolta del ragionamento — richiedono davvero tutta la potenza del modello grande. Sui pezzi facili, un modello molto più piccolo indovinerebbe la stessa parola. Il paper propone di sfruttare questa asimmetria: lasciare che un modello bozza, piccolo e veloce, butti giù una manciata di token in avanti, e usare il modello grande solo per controllarli.
Bozza veloce, verifica in parallelo
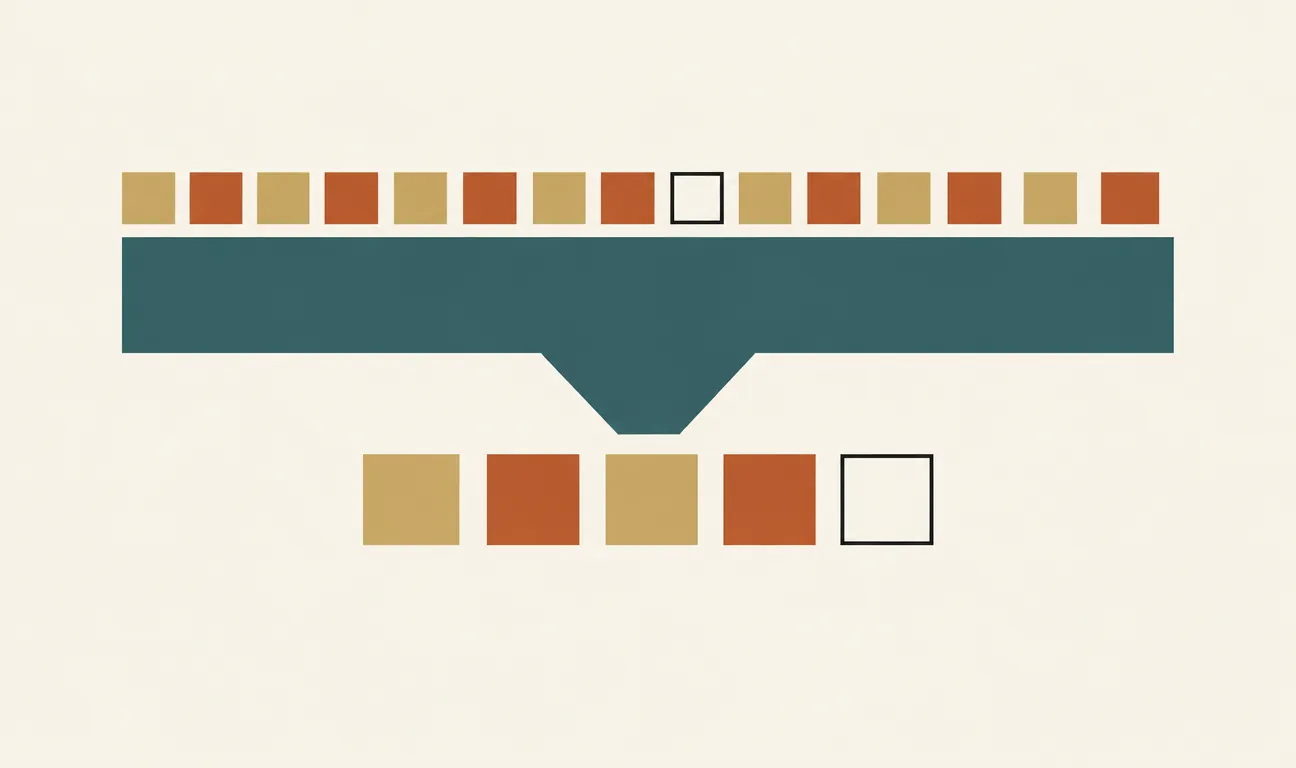
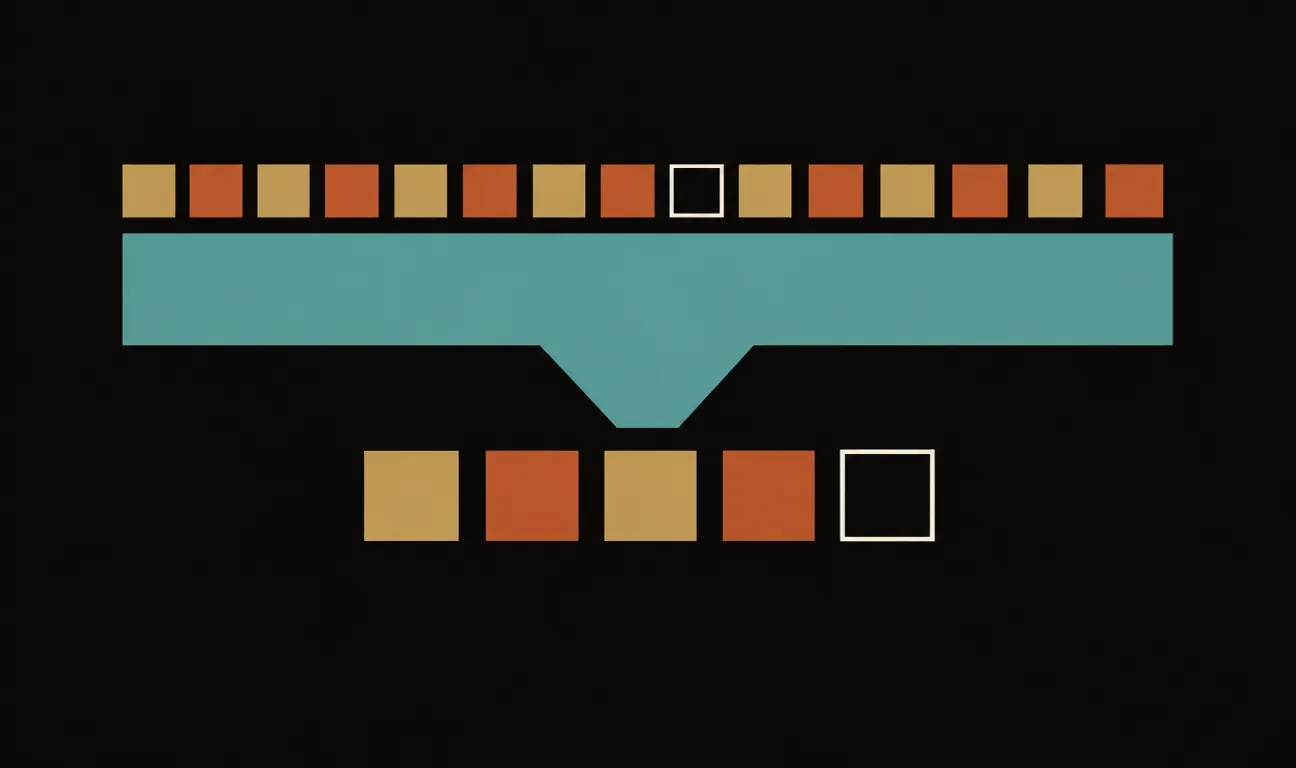
Il meccanismo è una danza a due. Il modello piccolo genera in sequenza qualche token candidato — chiamiamoli γ, nel paper tipicamente da cinque a sette. Sono economici, perché il modello che li produce è una frazione dell’altro. Poi entra il modello grande, e qui sta il colpo di scena: invece di generare, verifica. In un unico passaggio gli si danno in pasto il prompt e tutti i token proposti insieme, e lui calcola in parallelo, per ciascuna posizione, quale parola avrebbe scelto. Una sola passata attraverso il modello grande — quella che prima produceva un solo token — restituisce ora il suo verdetto su un intero blocco di candidati.
Il modello piccolo genera in sequenza alcuni token candidati. Il modello grande li verifica tutti in un’unica passata parallela: accetta il prefisso corretto e, al primo disaccordo, scrive lui il token giusto e scarta il resto. Più candidati sopravvivono, più tempo si guadagna.
Il trucco che non cambia l’output
La domanda naturale è: se un modello scadente propone le parole, la qualità non peggiora? La risposta, ed è la parte elegante del paper, è no — mai, per costruzione. La verifica non è un «sembra giusto, va bene». Gli autori usano una regola di campionamento modificata che accetta ciascun token proposto con una probabilità calibrata sul rapporto tra quanto lo riteneva probabile il modello grande e quanto il piccolo. Al primo token respinto, il modello grande campiona lui stesso la parola da una distribuzione corretta e si scartano tutti i candidati successivi. Si può dimostrare matematicamente che la sequenza risultante ha esattamente la stessa distribuzione di probabilità che avrebbe prodotto il modello grande da solo. L’output è statisticamente indistinguibile: nessun compromesso sulla qualità, solo sul tempo.
Nel caso peggiore — modello bozza pessimo, tutti i token respinti — non si guadagna nulla: si è comunque prodotto un token per passata, come nel metodo normale, pagando un piccolo sovrapprezzo per il lavoro sprecato del modello piccolo. Nel caso migliore si incassano diversi token per ogni passata del modello grande. Il rendimento dipende da due numeri: quanto spesso i token proposti vengono accettati, il tasso di accettazione α, e quanto il modello bozza è più economico del grande. Trovare l’equilibrio giusto è tutta l’arte pratica.
Non si è reso il modello più veloce. Gli si è tolto il tempo che passava fermo ad aspettare se stesso.
I numeri, e cosa dicono
Gli autori provano il metodo su T5-XXL, un modello da undici miliardi di parametri, usando come bozza T5-small, una versione da 77 milioni: oltre cento volte più leggera. Sulla traduzione dall’inglese al tedesco, con generazione deterministica, misurano un’accelerazione di 3,4 volte a parità di output, con un tasso di accettazione dei token proposti intorno al 75%. Sul riassunto di articoli l’accelerazione è di 3,1 volte. Introducendo casualità nel campionamento i guadagni si riducono ma restano netti, e il messaggio che il paper porta nel titolo dell’abstract è prudente e verificabile: tra le due e le tre volte più veloce, con output identico, senza riaddestrare nulla e senza toccare l’architettura. Quest’ultimo punto è ciò che ha reso la tecnica adottabile in fretta: si applica a modelli già esistenti, così come sono.
Perché ci riguarda
Se avete usato un assistente conversazionale nell’ultimo anno, con ogni probabilità avete beneficiato di una qualche forma di speculative decoding senza saperlo: l’idea è diventata parte dell’attrezzatura standard per servire modelli in produzione, con numerose varianti costruite sopra questa. Per chi gestisce infrastruttura AI la lezione è concreta e trasferibile: quando un sistema è limitato dalla memoria e non dal calcolo, il modo per andare più veloci non è sempre comprare hardware più potente, ma riorganizzare il lavoro per riempire la capacità che si sta già pagando. Speculative decoding non ha inventato un modello migliore né un chip migliore. Ha guardato una GPU che aspettava e le ha dato qualcosa da fare mentre aspettava. È il tipo di intuizione — semplice a dirsi, rigorosa a dimostrarsi — che conviene tenere a mente ogni volta che una pipeline sembra lenta per forza di cose.
Il paper
Yaniv Leviathan, Matan Kalman, Yossi Matias, Fast Inference from Transformers via Speculative Decoding, ICML 2023. Prima versione su arXiv nel novembre 2022, revisione nel maggio 2023: arxiv.org/abs/2211.17192.
I commenti sono riservati agli iscritti.
Accedi per commentare