Ti è mai capitato di usare una lista per tutto? Le coordinate di un punto: lista. La rubrica dei contatti: lista di liste. Gli utenti unici di un sito: lista, e poi un ciclo per togliere i doppioni a mano. Funziona, certo — come funziona avvitare una vite col coltello da cucina. Ma Python ti offre un cassetto degli attrezzi completo: tuple, dizionari e set esistono proprio perché la lista non è la risposta a ogni domanda. Oggi impari a riconoscere quale contenitore serve, e quando.
Tipi, strutture dati, controllo di flusso e funzioni: le basi di Python sono nel libro, in un percorso che si legge in ordine.
Prerequisito: le liste. Se non ricordi i dettagli, ti basta sapere che una lista è una sequenza ordinata e modificabile di valori tra parentesi quadre, tipo [7, 9, 8] — ne abbiamo parlato nel tutorial precedente su numeri, stringhe e liste. Tutto il codice di oggi gira con Python 3.12 liscio, senza librerie esterne.
Tupla: la busta sigillata
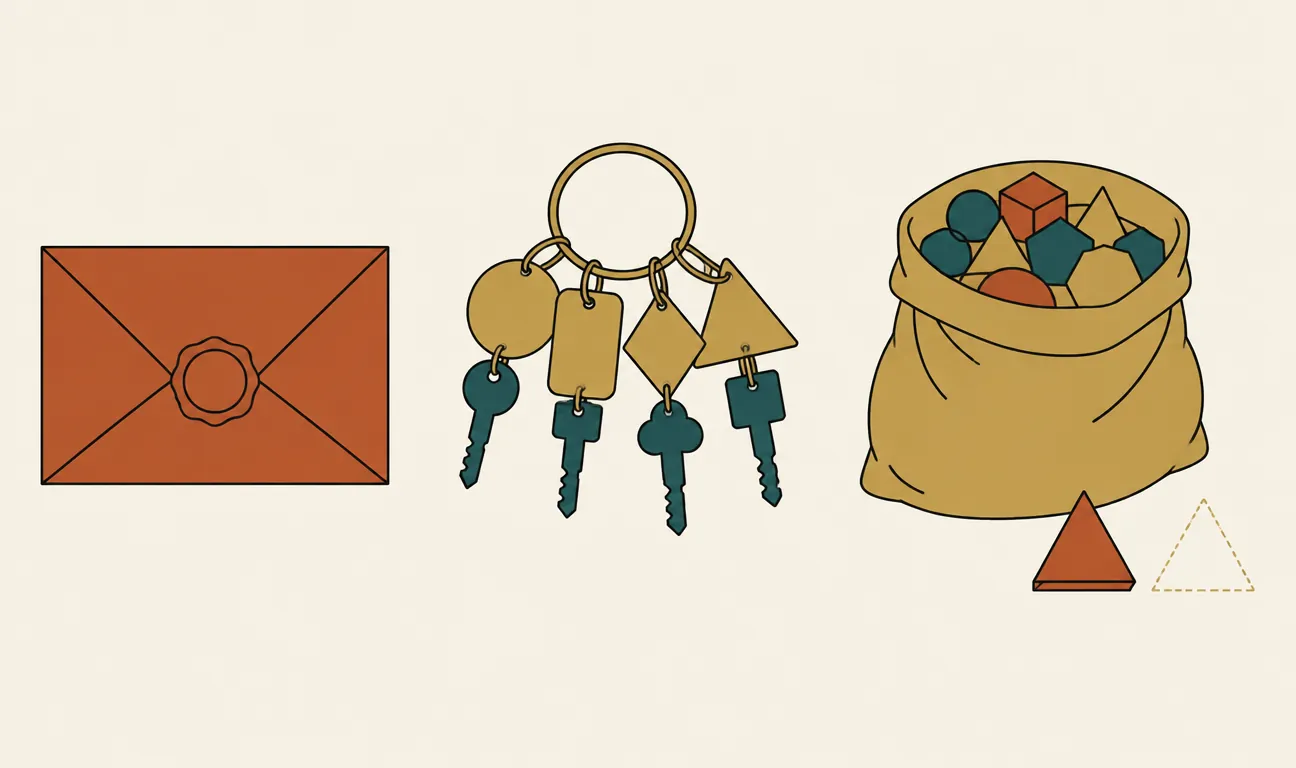
Una tupla si scrive con le parentesi tonde: (45.4642, 9.1900). Sembra una lista, ma con una differenza radicale: una volta creata, non si tocca più. Niente append, niente riassegnazioni. È una busta sigillata: dentro ci metti dati che formano un tutt’uno e che non ha senso modificare pezzo per pezzo — le coordinate di Milano, una data di nascita, una coppia (nome, cognome). Se le coordinate cambiano, non «aggiorni la latitudine»: è proprio un altro posto, quindi un’altra tupla.
Perché rinunciare volontariamente alla modificabilità? Per tre ottime ragioni: il codice comunica l’intenzione («questi valori viaggiano insieme e nessuno li altererà»), Python può usarla come chiave di un dizionario (una lista no!), e ti protegge dai bug — nessuna funzione potrà modificarti i dati di nascosto.
Dizionario: la rubrica
Il dizionario è il contenitore chiave → valore, tra parentesi graffe: {"Anna": 8, "Luca": 7}. L’analogia perfetta è la rubrica del telefono: non cerchi «il terzo contatto che ho salvato», cerchi «il numero di Anna». La lista ti fa accedere per posizione, il dizionario per nome. E la ricerca per chiave è quasi istantanea anche con un milione di voci: sotto il cofano c’è una hash table, la stessa idea che rende veloce l’indice analitico di un libro rispetto a sfogliarlo pagina per pagina.
Nel machine learning i dizionari sono ovunque: gli iperparametri di un modello ({"max_depth": 5, "n_estimators": 100}), i conteggi delle parole in un testo, le configurazioni di un esperimento. Se ti trovi a scrivere «l’elemento in posizione 2 è il prezzo, quello in posizione 3 è la durata»… fermati: volevi un dizionario.
Set: il sacchetto delle figurine (senza doppioni)
Il set è una collezione senza duplicati e senza ordine: {"gatto", "cane", "gatto"} contiene due elementi, non tre. Pensa all’album delle figurine: della figurina 42 o ce l’hai o non ce l’hai — averne tre copie non cambia l’album. Il set fa due cose meglio di chiunque altro: eliminare i doppioni in una riga, e rispondere fulmineamente alla domanda «c’è o non c’è?» (x in mio_set). In più eredita dalla matematica le operazioni tra insiemi: intersezione, unione, differenza — comodissime per confrontare, ad esempio, gli utenti di due giorni diversi.
Scegliere il contenitore giusto non è pignoleria da manuale: è il codice che ti dice da solo cosa sta facendo. Una tupla dichiara «questo non cambia», un dizionario dichiara «qui si cerca per nome», un set dichiara «qui contano solo le presenze».
La tabella decisionale
Come si sceglie, in pratica? Fatti tre domande nell’ordine: mi servono coppie chiave → valore? Contano i duplicati e l’ordine? Il contenuto dovrà cambiare? Questo schema riassume tutto:
La tabella decisionale dei quattro contenitori: leggi la riga, rispondi alla domanda guida nell’ultima colonna e sai già quale usare.
Ora il codice completo. Copialo in contenitori.py ed eseguilo con python contenitori.py:
# contenitori.py — tuple, dizionari e set in azione
# Requisiti: Python 3.12, nessuna libreria esterna

# ---------- TUPLE ----------
milano = (45.4642, 9.1900)     # coordinate: un tutt'uno sigillato

# L'unpacking "apre la busta" in variabili separate:
lat, lon = milano
print(f"Latitudine {lat}, longitudine {lon}")

# milano[0] = 46.0   # TypeError! La tupla non si modifica

# Una funzione che restituisce due valori usa (senza dirlo) una tupla:
def min_e_max(valori):
    return min(valori), max(valori)   # questa è una tupla!

basso, alto = min_e_max([7, 9, 6, 8, 10])
print(f"Voto minimo {basso}, massimo {alto}")

# ---------- DIZIONARI ----------
voti = {"Anna": 8, "Luca": 6, "Sara": 9}

print(voti["Anna"])            # 8 — accesso per chiave, quasi istantaneo
voti["Marco"] = 7              # aggiungere: basta assegnare
voti["Luca"] = 7               # aggiornare: stessa sintassi

# .get evita l'errore se la chiave non esiste:
print(voti.get("Giulia", "assente"))   # 'assente' invece di KeyError

# Scorrere chiavi e valori insieme:
for nome, voto in voti.items():
    print(f"{nome}: {voto}")

# Caso d'uso classico nel ML: contare le occorrenze
frase = "il gatto insegue il topo e il topo scappa"
conteggio = {}
for parola in frase.split():
    conteggio[parola] = conteggio.get(parola, 0) + 1
print(conteggio)   # {'il': 3, 'gatto': 1, 'insegue': 1, 'topo': 2, ...}

# ---------- SET ----------
lunedi  = {"anna@mail.it", "luca@mail.it", "sara@mail.it"}
martedi = {"luca@mail.it", "sara@mail.it", "marco@mail.it"}

# Deduplicare una lista in UNA riga:
visite = ["anna", "luca", "anna", "sara", "luca", "anna"]
unici = set(visite)
print(f"{len(visite)} visite, {len(unici)} visitatori unici")

# Le operazioni tra insiemi:
print(lunedi & martedi)   # intersezione: presenti entrambi i giorni
print(lunedi | martedi)   # unione: tutti gli iscritti
print(lunedi - martedi)   # differenza: c'erano lunedì ma non martedì

# Il test di appartenenza è il superpotere del set:
print("sara@mail.it" in martedi)   # True, velocissimo anche su milioni di voci
Nota il trucco del conteggio parole: conteggio.get(parola, 0) + 1 significa «prendi il valore attuale, o 0 se la parola è nuova, e aggiungi 1». Tre righe che sono l’antenato diretto della bag of words, la rappresentazione del testo che useremo nella sentiment analysis.
Quando NON complicarti la vita
Parliamoci chiaro: non serve il contenitore «perfetto» a ogni costo. Se hai cinque elementi e li scorri una volta, la lista va benissimo e chi ti dice il contrario sta ottimizzando l’inottimizzabile. Il set perde l’ordine di inserimento: se l’ordine conta, non usarlo — deduplica piuttosto con list(dict.fromkeys(x)), che conserva l’ordine. E la leggenda «la tupla è più veloce della lista» è vera ma irrilevante nel 99% dei casi: scegli la tupla per il suo significato (dati sigillati), non per guadagnare microsecondi. La velocità che conta arriverà da NumPy e Pandas, non da queste micro-scelte.
Prova tu
Esercizio: parti da questa lista di prestiti in biblioteca, con doppioni: ["1984", "Dune", "1984", "Neuromante", "Dune", "1984"]. Scrivi uno script che (1) conta quante copie di ogni titolo sono state prestate usando un dizionario e il trucco di .get, (2) stampa i titoli unici usando un set, (3) crea una tupla (titolo, prestiti) per il libro più richiesto e la «apre» con l’unpacking per stampare "Il più letto è X con N prestiti". Suggerimento per il punto 3: max(conteggio.items(), key=...) — e se key ti è ostico, scorri il dizionario con un semplice ciclo, va bene lo stesso.
Per approfondire: il capitolo «Strutture dati» del tutorial ufficiale di Python (in italiano) copre tuple, dizionari e set con tutti i metodi che qui non ho citato; se preferisci la carta, il capitolo sulle strutture dati di Pensare in Python di Allen Downey è gratuito online e pieno di esercizi.
I commenti sono riservati agli iscritti.
Accedi per commentare