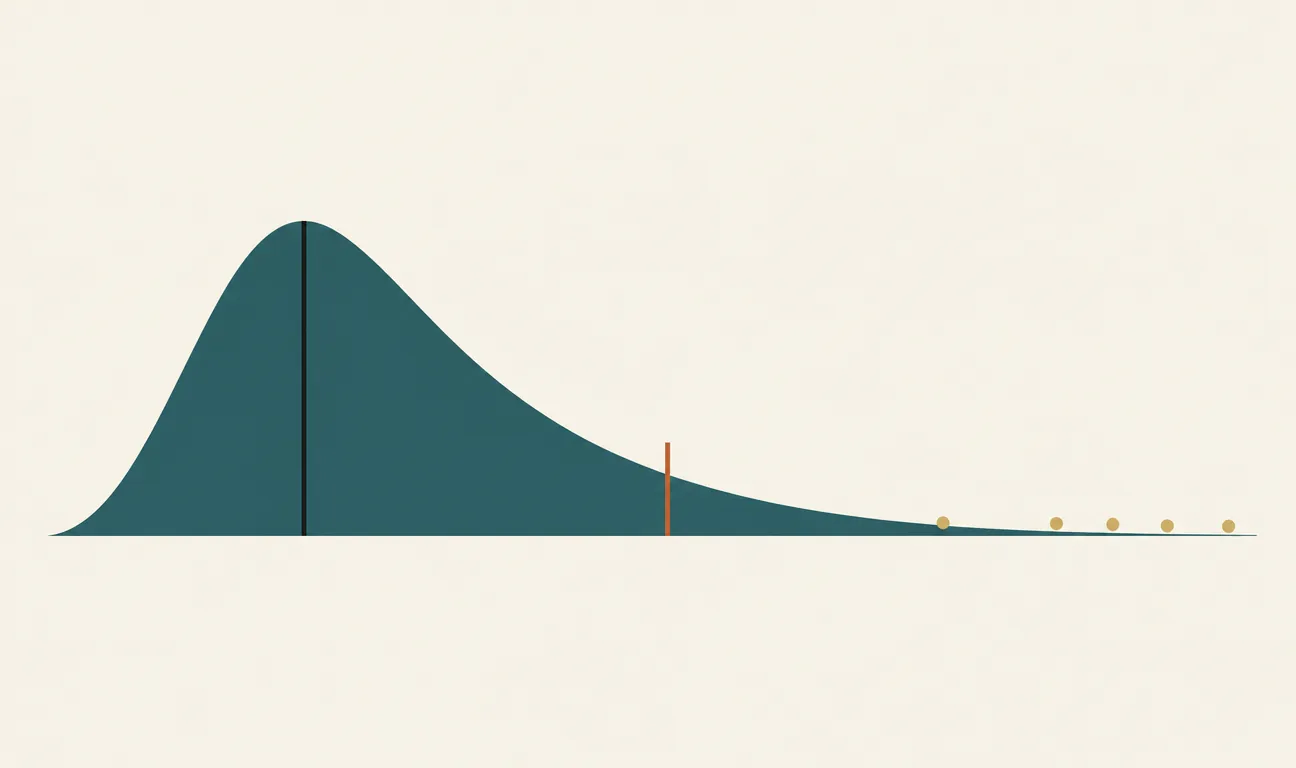
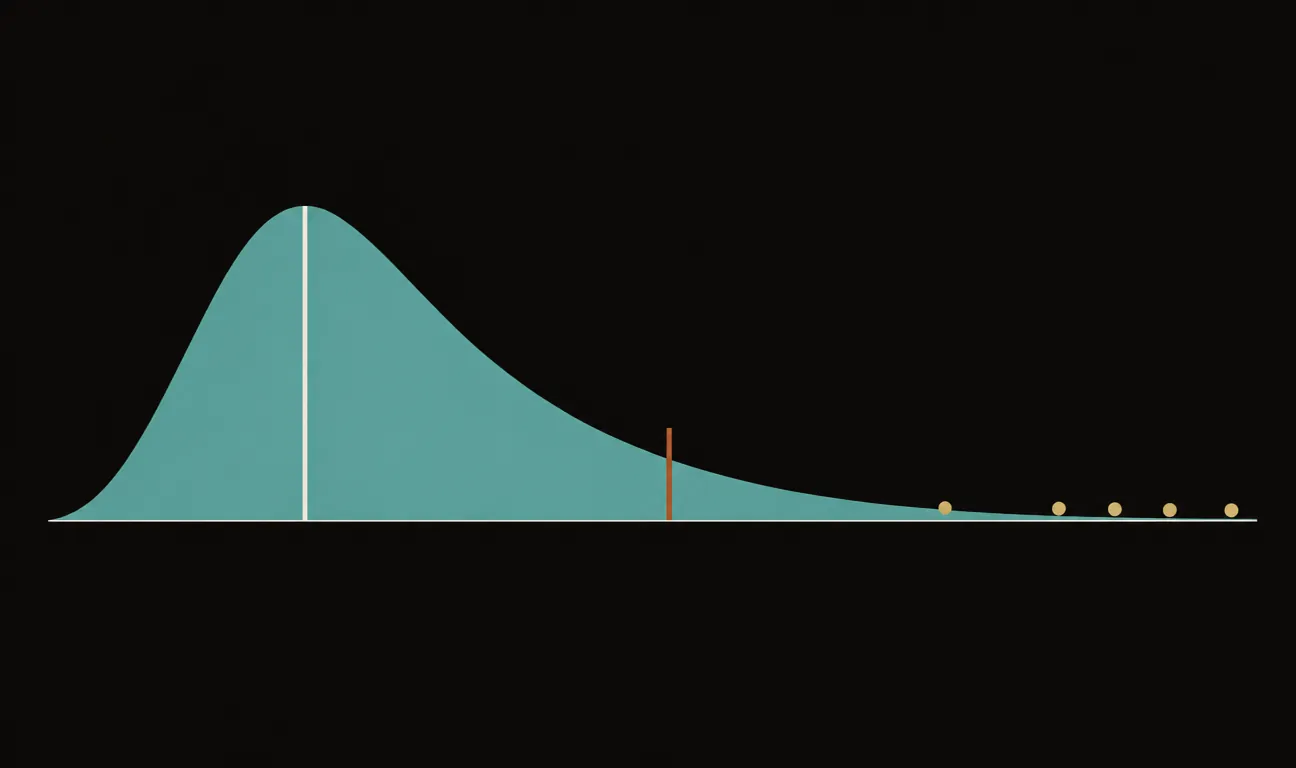
Ti è mai capitato di leggere che «lo stipendio medio in Italia è di circa 30.000 euro» e pensare: «Ma io e tutte le persone che conosco guadagniamo meno»? Non è una sensazione sbagliata: è statistica. Bastano pochi stipendi da dirigente per trascinare la media verso l’alto, mentre la maggioranza resta sotto. Se ti fidi solo della media, ti stai facendo raccontare una storia parziale. E nel machine learning succede la stessa cosa: un modello valutato solo «in media» può nascondere disastri nelle code della distribuzione.
Variabili aleatorie, centro e larghezza di una distribuzione, gaussiana e teorema di Bayes stanno per esteso nel libro.
Leggi «Probabilità e statistica: convivere con l’incertezza» nel libro →
In questo tutorial mettiamo ordine nel vocabolario di base: variabili aleatorie, densità, funzione cumulata, momenti e percentili. Ti serve Python 3.12 con NumPy, SciPy e Matplotlib (li installi in un attimo con uv add numpy scipy matplotlib o con pip dentro un venv). Se non ricordi cos’è una distribuzione, ti basta sapere che è la «forma» con cui i valori di una grandezza si sparpagliano: dove si addensano, dove si diradano.
Una variabile aleatoria è un distributore di numeri
Il nome intimidisce, ma l’idea è semplice. Una variabile aleatoria è come un distributore automatico un po’ capriccioso: ogni volta che premi il pulsante ti consegna un numero, e tu non sai in anticipo quale. Però il distributore non è del tutto imprevedibile — ha delle preferenze. Certi numeri escono spesso, altri quasi mai. L’insieme di queste preferenze è la distribuzione di probabilità.
Nel ML incontri variabili aleatorie ovunque, anche se nessuno le chiama così: l’età dei tuoi utenti, il tempo di risposta di un’API, l’errore di previsione del tuo modello su un esempio pescato a caso. Ogni colonna del tuo DataFrame è, di fatto, un campione estratto da un distributore di cui non conosci il meccanismo interno. Il lavoro dello statistico (e del ML engineer) è ricostruire le preferenze del distributore guardando i numeri che ha già sputato fuori.
PDF e CDF: due fotografie della stessa distribuzione
Per descrivere le preferenze del distributore hai due strumenti complementari.
- La PDF (probability density function) risponde a: «quanto è denso il traffico di valori qui?». È la classica curva a campana (o asimmetrica, o bimodale): alta dove i valori si affollano, bassa dove sono rari.
- La CDF (cumulative distribution function) risponde a: «che frazione dei valori sta sotto questa soglia?». Parte da 0, sale sempre, arriva a 1.
Un’analogia: la PDF è la foto aerea di una coda al supermercato — vedi dove la gente si ammassa. La CDF è il contapersone all’uscita — ti dice quante persone sono già passate quando arrivi al punto x. Stessa coda, due punti di vista. E la seconda, vedrai, è spesso la più utile delle due.
La stessa distribuzione asimmetrica vista due volte: nella PDF la media viene trascinata a destra dalla coda, mentre la mediana resta dove sta la maggioranza; nella CDF il 95° percentile si legge entrando a 0,95 sull’asse verticale.
I momenti: quattro numeri per riassumere una forma
Descrivere un’intera curva è scomodo; per fortuna pochi numeri, detti momenti, ne catturano l’essenziale. Pensa alla distribuzione come a una sagoma ritagliata nel cartone:
- Media (primo momento): il baricentro della sagoma, il punto dove sta in equilibrio sul dito.
- Varianza (secondo momento): quanto il cartone è largo, quanto i valori si allontanano dal baricentro. La sua radice quadrata è la deviazione standard, comoda perché ha la stessa unità di misura dei dati.
- Skewness (terzo momento): quanto la sagoma pende da un lato. Skewness positiva = coda lunga a destra, come gli stipendi dell’apertura.
- Curtosi (quarto momento): quanto sono «pesanti» le code, cioè quanto sono frequenti i valori estremi rispetto a una gaussiana.
La media ti dice dove sta il baricentro. Ma un modello in produzione non fallisce nel baricentro: fallisce nelle code.
Percentili: leggere la distribuzione come un pediatra
Il percentile p è il valore sotto cui cade il p% dei dati. Se hai figli l’hai già incontrato: quando il pediatra dice «è al 75° percentile di altezza», intende che il bambino è più alto del 75% dei coetanei. Nessuna formula, solo una posizione in classifica.
Nel ML i percentili sono ovunque, e spesso battono media e varianza: la mediana (50° percentile) è immune agli outlier; il range interquartile (IQR, dal 25° al 75°) è la base della regola classica per segnalare anomalie; la latenza p95 o p99 è lo standard con cui si misura un servizio di inference in produzione — perché all’utente che aspetta 4 secondi non importa che «in media» rispondi in 200 ms.
Mettiamo tutto in pratica
Simuliamo dei tempi di risposta di un’API di inference con una distribuzione log-normale (asimmetrica, come quasi tutti i tempi di attesa reali) e calcoliamo tutto quello che abbiamo visto. Copia, incolla, esegui.
# Python 3.12 — dipendenze: numpy, scipy, matplotlib
# setup consigliato:  uv init && uv add numpy scipy matplotlib
import numpy as np
from scipy import stats
import matplotlib.pyplot as plt

# Generatore moderno di numeri casuali (seed fissato: risultati riproducibili)
rng = np.random.default_rng(42)

# 10.000 tempi di risposta simulati, in millisecondi (log-normale: coda a destra)
tempi = rng.lognormal(mean=5.3, sigma=0.5, size=10_000)

# --- I quattro momenti ---
media = tempi.mean()                # baricentro
dev_std = tempi.std(ddof=1)         # dispersione (ddof=1: stima campionaria)
asimmetria = stats.skew(tempi)      # > 0: coda lunga a destra
curtosi = stats.kurtosis(tempi)     # > 0: code più pesanti di una gaussiana

print(f"media      = {media:7.1f} ms")
print(f"dev. std   = {dev_std:7.1f} ms")
print(f"skewness   = {asimmetria:7.2f}")
print(f"curtosi    = {curtosi:7.2f}")

# --- Percentili: la vista che conta in produzione ---
p50, p95, p99 = np.percentile(tempi, [50, 95, 99])
print(f"mediana p50 = {p50:6.1f} ms   (metà delle richieste sta sotto)")
print(f"p95         = {p95:6.1f} ms   (1 richiesta su 20 è più lenta)")
print(f"p99         = {p99:6.1f} ms   (1 su 100: qui vivono i reclami)")

# La media è più alta della mediana: firma di una coda destra
print(f"media - mediana = {media - p50:.1f} ms → distribuzione asimmetrica")

# --- Outlier con la regola IQR ---
q1, q3 = np.percentile(tempi, [25, 75])
iqr = q3 - q1
soglia = q3 + 1.5 * iqr
print(f"outlier oltre {soglia:.0f} ms: {(tempi > soglia).sum()} richieste")

# --- PDF e CDF empiriche, fianco a fianco ---
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11, 4))
ax1.hist(tempi, bins=80, density=True, color="#2D5A5C", alpha=0.8)
ax1.axvline(media, color="#B5532C", ls="--", label=f"media {media:.0f} ms")
ax1.axvline(p50, color="#C9A961", ls="--", label=f"mediana {p50:.0f} ms")
ax1.set_title("PDF empirica"); ax1.legend()

ordinati = np.sort(tempi)                       # CDF empirica: valori ordinati...
quota = np.arange(1, len(ordinati) + 1) / len(ordinati)  # ...contro la quota cumulata
ax2.plot(ordinati, quota, color="#2D5A5C")
ax2.axhline(0.95, color="#B5532C", ls="--", label=f"p95 = {p95:.0f} ms")
ax2.set_title("CDF empirica"); ax2.legend()
plt.tight_layout(); plt.show()
Esegui lo script e guarda i due numeri chiave: la media sarà intorno ai 225 ms, ma la p99 supererà i 600. Se avessi dimensionato i timeout del tuo servizio sulla media, un utente su cento vivrebbe un’esperienza tre volte peggiore di quella «ufficiale». Ecco perché nei contratti di servizio si scrive p95, non media.
Quando i momenti non bastano (e quando bastano eccome)
Onestà intellettuale, come sempre. Media e deviazione standard sono strumenti eccellenti quando la distribuzione è ragionevolmente simmetrica e senza code estreme: in quel caso riassumono quasi tutto e le usano felicemente scaler, loss quadratiche e test statistici. Ma se la skewness è marcata — redditi, tempi di attesa, dimensioni dei file, conteggi di click — la media diventa fuorviante e conviene ragionare per percentili, o trasformare i dati (un logaritmo spesso raddrizza una log-normale). Il riflesso da costruire è: prima di riassumere una colonna con mean(), guarda sempre un istogramma. Costa una riga di codice e ti evita conclusioni sbagliate.
Prova tu: carica un dataset reale (ad esempio i prezzi delle case di sklearn.datasets.fetch_california_housing) e per la colonna target calcola media, mediana, skewness, p95 e conta gli outlier con la regola IQR. Poi applica np.log1p ai valori e ripeti: quanto si è ridotta la skewness? La media e la mediana si sono avvicinate?
Per approfondire: Think Stats di Allen B. Downey (gratuito online, con codice Python) è la migliore introduzione operativa a distribuzioni e percentili; per i dettagli sulle funzioni usate qui, la documentazione ufficiale di scipy.stats è chiara e piena di esempi eseguibili.
I commenti sono riservati agli iscritti.
Accedi per commentare