
A Ravenna, sulle pareti della basilica di San Vitale, le figure non sono dipinte: sono fatte di migliaia di tessere di vetro e di pietra. Il mosaicista non dispone di infinite sfumature. Ha una cassetta con un numero limitato di tinte, e per rendere l’incarnato di un volto sceglie, tessera dopo tessera, quella che più si avvicina al colore che ha in mente, e la incolla nella sua casella. Da lontano l’occhio ricompone la figura; da vicino resta una griglia di scelte prese da un catalogo finito. Nel 2017 tre ricercatori di DeepMind — Aaron van den Oord, Oriol Vinyals e Koray Kavukcuoglu — descrissero un modo per far fare esattamente questo a una rete neurale, con le immagini, il suono e il video. Il modello si chiama VQ-VAE, e la cassetta delle tessere se la costruisce da sola.
Che cosa cambia quando il latente è fatto di simboli invece che di numeri continui: nel libro.
Perché discreto
Per capire la proposta serve sapere cosa correggeva. Un autoencoder è una rete che strizza un dato dentro un codice compatto e poi cerca di ricostruirlo; la sua variante probabilistica, il variational autoencoder (VAE), lo fa attraverso uno spazio latente di numeri continui. Continui: ogni coordinata può assumere qualsiasi valore reale. È la scelta che ha dominato, perché si addestra bene e senza intoppi. Eppure buona parte di ciò che ci interessa è discreto per natura. Il linguaggio è fatto di simboli, il parlato si trascrive come sequenza di fonemi, un ragionamento procede a passi separati. Le rappresentazioni discrete sembravano un incastro più naturale per questi mondi, ma i modelli che le usavano restavano indietro rispetto ai cugini continui.
C’era anche un guasto più insidioso, il posterior collapse. Se accoppi un VAE a un decoder molto potente — capace da solo di ricostruire il dato — il decoder impara a fare tutto per conto suo e ignora il codice latente, che diventa peso morto: la parte «intelligente» del modello viene aggirata. Il paper rivendica di essere il primo VAE a variabili latenti discrete a reggere il confronto con le versioni continue, e insieme di scansare per costruzione il collasso del latente.
Il meccanismo: una cassetta di vettori
Il pezzo nuovo è il codebook, la cassetta delle tessere. Formalmente è uno spazio di embedding $e \in \mathbb{R}^{K \times D}$: K vettori-tessera, ciascuno di dimensione D. L’encoder guarda il dato e per ogni porzione produce un vettore continuo $z_e(x)$. Qui avviene la mossa decisiva: quel vettore non passa così com’è, ma viene sostituito dalla tessera del codebook che gli è più vicina, misurata con la distanza euclidea.
$$z_q(x) = e_k, \qquad k = \arg\min_j \lVert z_e(x) – e_j \rVert_2$$
Al decoder arriva la tessera prescelta $e_k$, non il vettore originale. Di ogni porzione sopravvive quindi una sola informazione: quale delle K tessere, cioè un indice. È la stessa strozzatura del mosaico: non conservi il colore esatto di ogni punto, conservi la casella del catalogo. Con un codebook di 512 voci ogni cella dell’immagine costa nove bit, e nient’altro.
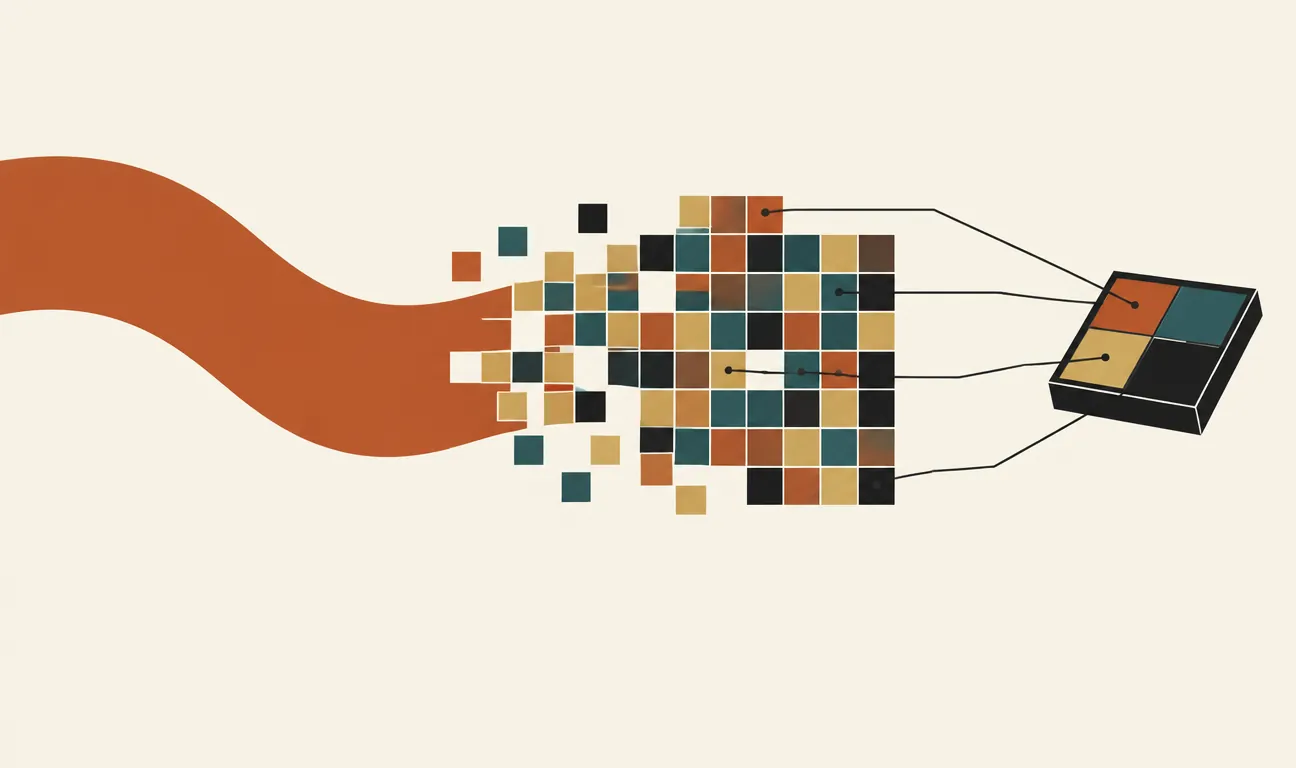
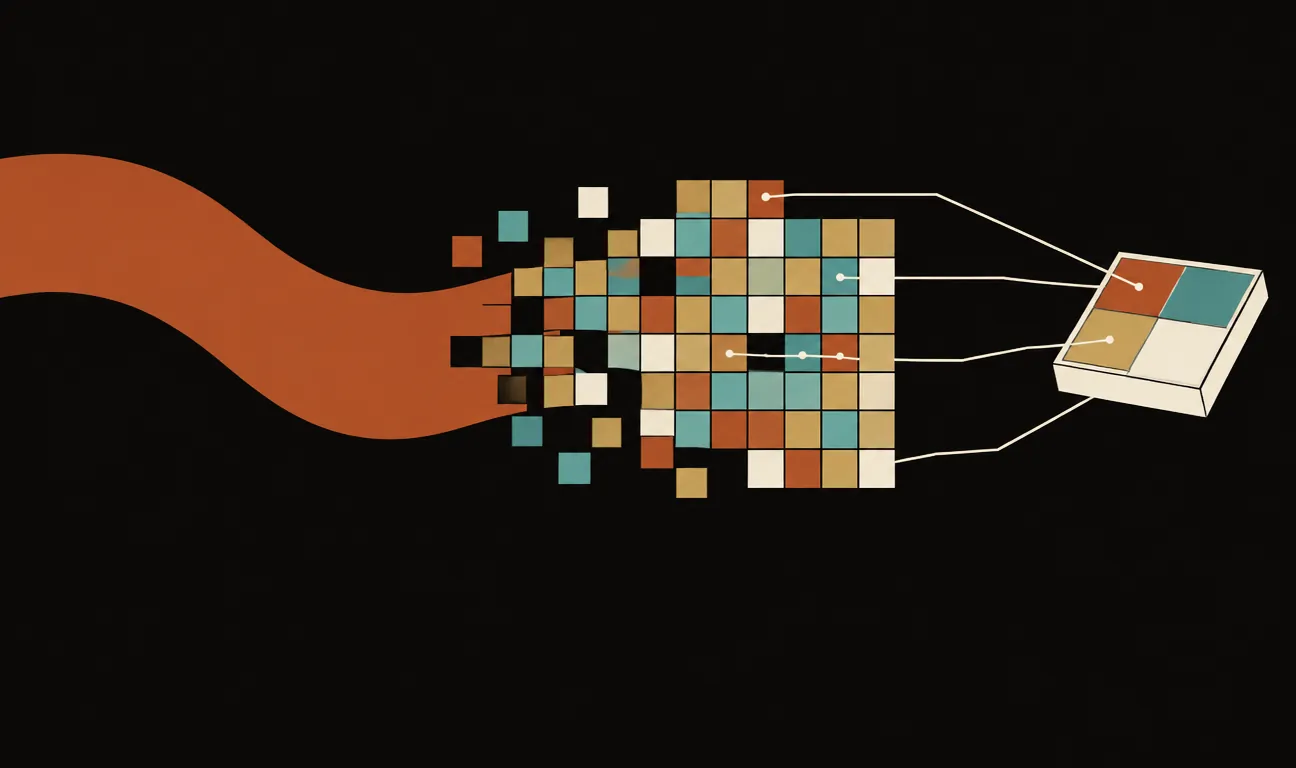
L’encoder produce una griglia di vettori continui; ogni vettore viene sostituito dalla tessera più vicina del codebook, ottenendo una griglia di indici discreti che il decoder trasforma nella ricostruzione. L’arco in alto è il gradiente che, per addestrare l’encoder, viene copiato indietro saltando la discretizzazione.
Il trucco del gradiente
Qui c’è un problema che avrebbe potuto affondare tutto. Scegliere «la tessera più vicina» è un’operazione a scalini: non ha pendenza. E senza pendenza la retropropagazione — il modo in cui una rete capisce come correggersi — non ha nulla a cui aggrapparsi per dire all’encoder di migliorare. La soluzione degli autori è lo straight-through estimator: si fa finta che la discretizzazione non ci sia e si copia il gradiente dall’ingresso del decoder direttamente all’uscita dell’encoder, di peso. È come un vetro smerigliato: non si vede attraverso la strozzatura, allora il messaggio lo si passa dall’altra parte come se il vetro non ci fosse.
Restano due cuciture. La prima fa muovere le tessere: un termine di costo le trascina verso i vettori che l’encoder produce davvero — la cassetta riordina le proprie tinte verso i colori effettivamente richiesti dai dati. La seconda, la commitment loss, impedisce all’encoder di divagare, costringendolo a «impegnarsi» su una tessera invece di far gonfiare a vuoto le proprie uscite. L’obiettivo completo mette insieme ricostruzione, aggiornamento del codebook e impegno:
$$\mathcal{L} = \log p\!\left(x \mid z_q(x)\right) + \bigl\lVert \operatorname{sg}[z_e(x)] – e \bigr\rVert_2^2 + \beta\,\bigl\lVert z_e(x) – \operatorname{sg}[e] \bigr\rVert_2^2$$
Il simbolo $\operatorname{sg}$ è lo stopgradient: lascia passare il valore in avanti ma azzera la derivata, così ciascun termine allena solo la parte giusta della rete. Il peso $\beta$ regola quanto conta l’impegno; gli autori lo fissano a 0,25 e notano che i risultati non cambiano per valori tra 0,1 e 2,0. Un dettaglio elegante: con un prior uniforme sulle tessere il termine di divergenza che di solito complica i VAE diventa una costante pari a $\log K$, e si può ignorare.
Due tempi
C’è un secondo movimento, e cambia il senso del modello. Mentre si addestra il VQ-VAE, la distribuzione a priori sui codici resta piatta, uniforme. Solo dopo, a codebook congelato, si allena separatamente un modello autoregressivo potente sulla griglia degli indici — un PixelCNN per le immagini, un WaveNet per l’audio grezzo — che impara quali tessere tendono a stare vicine a quali, cioè la grammatica del mosaico. Per generare qualcosa di nuovo si campiona una griglia di codici da questo prior e la si consegna al decoder. La creazione avviene nello spazio discreto e compatto, non pixel per pixel: è ciò che rende il campionamento praticabile.
Cosa hanno misurato
I numeri sono sobri e onesti. Su CIFAR10, misurando la compressione in bit per dimensione (più basso è meglio), il VQ-VAE ottiene 4,67 contro i 4,51 del VAE continuo di riferimento e i 5,14 di un metodo discreto concorrente. Non vince: si avvicina, ed è la prima volta che un modello a latenti discreti arriva così vicino a uno continuo. Sulle immagini, un fotogramma da 128×128×3 viene ridotto a una griglia di codici 32×32 con K=512: circa 42,6 volte meno bit, con ricostruzioni «solo leggermente più sfocate» degli originali. In un esperimento estremo comprimono un’intera scena 84×84 in tre soli codici — 27 bit, meno di un singolo numero in virgola mobile: la disposizione della stanza e i muri sopravvivono, mentre le texture vengono rigenerate dal prior invece che memorizzate.
La parte più suggestiva è l’audio. Addestrato su registrazioni vocali con uno spazio latente 64 volte più piccolo della forma d’onda, il modello ricostruisce le stesse parole ma con una forma d’onda ben diversa e la prosodia alterata: segno che il codice ha catturato il contenuto e ha scartato il dettaglio acustico, senza alcuna supervisione linguistica. Da qui due risultati. Confrontando i codici con la sequenza di fonemi reali — mai usati per l’addestramento — una mappatura da 128 codici ai 41 fonemi possibili azzecca il 49,3% dei casi, contro il 7,2% del puro caso: i codici appresi sono descrittori vicini ai fonemi. E scambiando l’identità del parlante al momento della decodifica, il modello riproduce lo stesso testo con un’altra voce, la conversione di parlante. Sul video, infine, srotolano fotogrammi di un ambiente 3D condizionati da un’azione lavorando interamente nello spazio latente.
I limiti che dichiarano
Gli autori non li nascondono. Le ricostruzioni sono un po’ sfocate perché la perdita si misura come errore quadratico sui pixel; una funzione più percettiva, dicono, è lavoro futuro. Il prior viene allenato in un secondo tempo, staccato dal VQ-VAE: addestrarli insieme, che forse migliorerebbe i risultati, è rimandato. Lo straight-through resta un’approssimazione, non un vero gradiente. E il 49,3% sui fonemi, per quanto lontano dal caso, è modesto: i codici assomigliano ai fonemi, non li trascrivono. C’è anche un fallimento riportato con lealtà — un metodo alternativo di quantizzazione «morbida» provato da zero non quantizzava affatto, perché il decoder imparava a invertirlo. È il genere di risultato negativo che un paper onesto scrive per intero.
Perché rileggerlo
L’idea che è rimasta è una sola: trasformare un segnale continuo in una sequenza di simboli pescati da un vocabolario appreso. Nel momento in cui un’immagine o un suono diventano una griglia di codici, si possono modellare con la stessa macchina autoregressiva costruita per il testo. Quel ponte — tutto è token — è la ragione per cui vale la pena rileggerlo oggi, in un’epoca di modelli che macinano pixel, audio e parole come fossero la stessa sequenza di simboli. È bene però essere precisi: il paper non promette niente di tutto questo. Mostra, con misura, che una cassetta di tessere costruita da sola basta a ricostruire il mondo abbastanza bene da essere utile. Ciò che è venuto dopo — i tokenizer di immagini e audio, i sistemi multimodali — è un altro capitolo, che queste otto pagine hanno reso possibile senza pretendere di anticiparlo.
Il paper
Aaron van den Oord, Oriol Vinyals, Koray Kavukcuoglu, Neural Discrete Representation Learning, NIPS 2017. Disponibile su arXiv: arxiv.org/abs/1711.00937.
I commenti sono riservati agli iscritti.
Accedi per commentare