
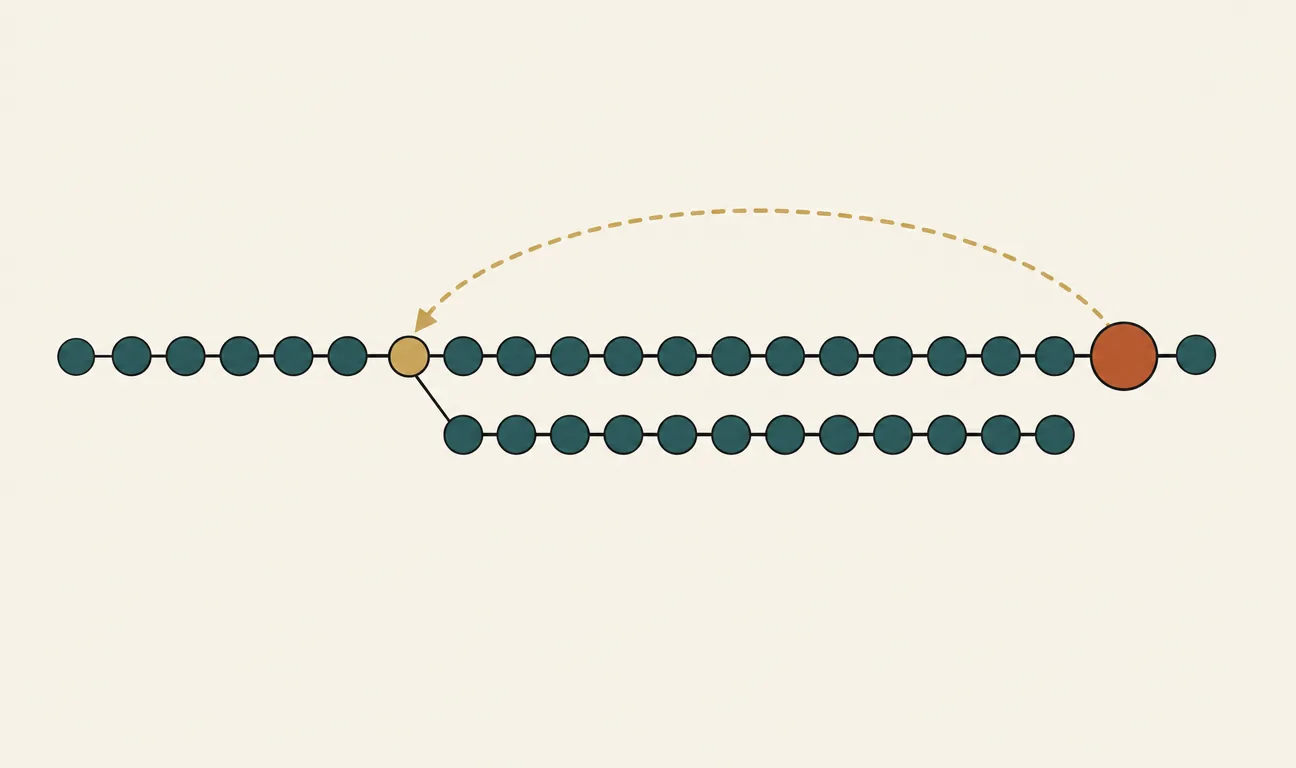
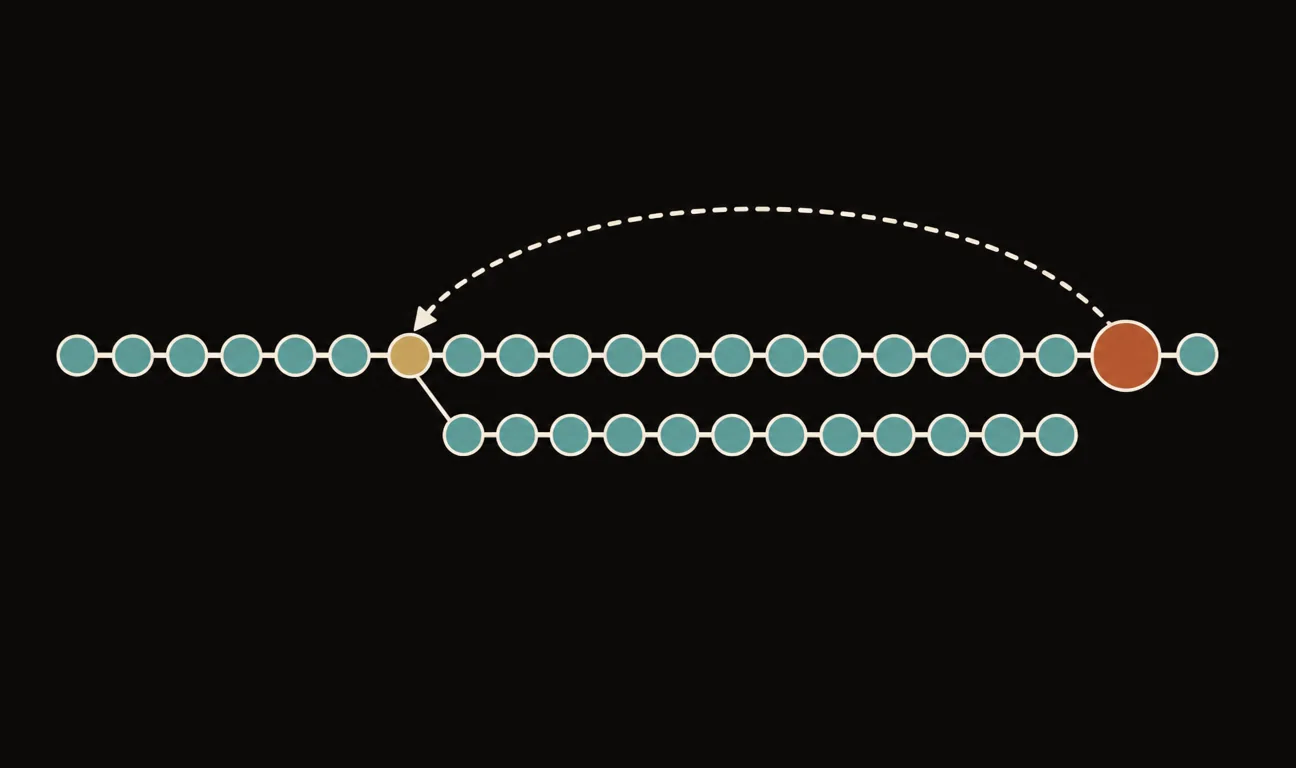
Chi ha portato l’auto dal meccanico per una spia accesa sa che la spia non è il guasto. Si accende quella dell’olio, ma il problema è una guarnizione ceduta tre settimane prima; si sostituisce la lampadina, e la spia torna. Un buon meccanico non guarda dove si vede il sintomo: risale la catena finché trova il pezzo che, se fosse stato a posto, avrebbe evitato tutto il resto.
Gli agenti basati su modelli linguistici hanno lo stesso problema, moltiplicato per la lunghezza delle loro esecuzioni. Un agente sbaglia la risposta finale perché molti passi prima ha dato per scontata un’ipotesi che il testo del compito non autorizzava, o perché un agente ha passato a un altro un’indicazione sbagliata. Il sintomo arriva molto dopo, dietro una serie di azioni che prese una per una sembrano ragionevoli. AgentDebugX: An Open-Source Toolkit for Failure Observability, Attribution, and Recovery in LLM Agents, depositato su arXiv il 21 luglio 2026 (2607.18754), è un tentativo di trasformare quella risalita in un attrezzo. Lo firmano dodici ricercatori, otto dei quali dell’Università dell’Illinois a Urbana-Champaign (gli altri fra Toronto, Google e Stanford), con Kunlun Zhu, Xuyan Ye e Zhiguang Han primi autori a pari merito e Jiaxuan You e Heng Ji in chiusura. Il codice è sotto licenza MIT e si installa con pip install agentdebugx.
Qui si dà per noto come lavora un agente: un modello che pianifica, chiama uno strumento, legge il risultato e ripete, lasciando dietro di sé una traccia di passi. Il ciclo e i suoi componenti sono costruiti da capo nel libro.
Il buco fra vedere e riparare
Gli strumenti esistenti coprono pezzi del problema. Le piattaforme di osservabilità come LangSmith, Langfuse o Phoenix registrano e fanno rivedere ogni passo di un’esecuzione, ma lasciano allo sviluppatore il lavoro di capire quale passo ha condannato il compito e come correggerlo. La ricerca ha prodotto tassonomie dei fallimenti e benchmark di attribuzione, come MAST e Who&When, che mostrano quanto anche i modelli forti fatichino a localizzare la causa, ma restano analisi a sé, non infrastruttura da installare. I metodi di autocorrezione, come Reflexion o CRITIC, fanno riprovare il modello, ma senza sapere dove guardare.
È il punto su cui il paper costruisce: un lavoro del 2024 di Tyen e colleghi ha mostrato che i modelli faticano a trovare gli errori in un ragionamento, ma li correggono molto meglio quando qualcuno indica loro dove stanno. Se l’attribuzione funziona, la riparazione ha una base più solida. AgentDebugX mette le due cose in fila.
Un ciclo in quattro tempi
Il toolkit organizza il debug in quattro fasi: rilevare, attribuire, recuperare, rilanciare. Tutto parte da un formato di traccia portabile, una sequenza ordinata di eventi (chiamate al modello, chiamate agli strumenti, operazioni di memoria, passaggi di consegne fra agenti, azioni sull’interfaccia, con gli screenshot per gli agenti grafici) in cui ogni evento registra chi ha agito, a quale passo, con quali ingressi e uscite. Gli adattatori catturano le esecuzioni da LangGraph, CrewAI, OpenAI Agents SDK, OpenTelemetry o da un semplice ciclo ReAct; gli importatori ricostruiscono lo stesso formato da log già esportati. La diagnosi si appoggia sopra la traccia senza modificarla: la stessa esecuzione può essere rianalizzata o conservata come caso di regressione.
La rilevazione comincia senza modelli: regole deterministiche intercettano i guasti verificabili meccanicamente, come chiamate a strumenti malformate, cicli che non avanzano, successi dichiarati troppo presto. Quando le regole non bastano, un modello giudice legge l’obiettivo e una finestra della traccia e classifica i passi sospetti secondo una tassonomia di partenza di 19 modi di fallimento (pianificazione, memoria, uso degli strumenti, verifica, coordinamento). Ma il passo dove il guasto si manifesta non è necessariamente quello responsabile: la rilevazione fornisce indizi, non il verdetto.
L’attribuzione risale dal sintomo al passo «la cui correzione avrebbe più probabilmente evitato il fallimento». I metodi disponibili hanno costi crescenti: euristiche economiche, una lettura unica dell’intera traccia, una ricerca binaria sui passi, un’ispezione passo per passo. Ognuno restituisce ipotesi ordinate con un grado di fiducia, non una sentenza. Il recupero trasforma la diagnosi in un’istruzione di correzione, e il rilancio riparte da un punto di controllo scelto, conservando accanto all’esecuzione originale il ramo riparato. Se anche quello fallisce, rientra nel ciclo. Nessuna correzione viene applicata da sola: dato che un’azione rifatta può cambiare lo stato del mondo, passa da un’approvazione umana o da una politica esplicita.
DeepDebug: due letture e un arbitro
Il cuore del toolkit è DeepDebug, un agente diagnostico che interviene sui casi che una lettura sola non risolve. Secondo gli autori, i due approcci semplici hanno punti ciechi opposti: chi legge tutta la traccia di un fiato conserva il senso del compito ma si fa attirare dal sintomo più rumoroso, alla fine; chi esamina un passo alla volta perde di vista l’obiettivo.
DeepDebug procede in quattro tempi, sempre in sola lettura: non riesegue mai gli strumenti dell’esecuzione. Prima legge l’intera traccia e nomina un primo candidato. Poi fa una seconda indagine guidata dalla forma della traccia: nelle esecuzioni a più agenti risale la catena dei passaggi di consegne fino al primo passo che ha condannato il compito; in quelle con un agente solo taglia a metà l’intervallo dei passi e rilegge la parte sopravvissuta, come in una ricerca binaria. Se i due candidati coincidono, il passo è accettato. Se no, arriva il terzo tempo, il controinterrogatorio: i due candidati vengono messi a confronto con il loro contesto e le loro conseguenze, e un’unica domanda chiede quale dei due, corretto, avrebbe evitato il fallimento. La ricerca su tutta la traccia si riduce a una scelta fra due ipotesi. Nell’ultimo tempo esce un rapporto: agente e passo responsabili, una spiegazione in linguaggio piano, frammenti citati come prova, una sola correzione concreta.
Le chiamate al modello sono circa cinque, contro una della lettura unica. Il costo reale però cresce meno, perché i turni successivi leggono finestre ristrette: su un campione di 25 tracce, una lettura intera consuma in media 8,1 mila token e DeepDebug 12,8 mila, cioè
$$\frac{12{,}8\text{K}}{8{,}1\text{K}} \approx 1{,}6$$
volte tanto. Secondo gli autori, passando a DeepDebug solo quando la diagnosi semplice è incerta il costo medio resta vicino a quello di una lettura singola.
I numeri
Il primo banco di prova è Who&When, 184 tracce di sistemi multi-agente (126 generate automaticamente, 58 costruite a mano) in cui è annotato chi ha sbagliato e a quale passo. La metrica più severa chiede di indovinare entrambi. Con il modello aperto qwen3.5-9b come motore della diagnosi, DeepDebug fa meglio della lettura unica, il migliore dei metodi semplici, sulla metrica severa e anche sull’agente e sul passo presi da soli. Su un modello aperto più grande, qwen3.6-27b, il vantaggio si assottiglia. Il margine si concentra sulle tracce più lunghe di 40 eventi, che però sono solo 26, e gli autori stessi lo presentano come indizio descrittivo.
| Che cosa si indovina | Lettura unica | DeepDebug |
|---|---|---|
| Motore qwen3.5-9b | ||
| Agente e passo esatto | 21,7% | 28,8% |
| Agente responsabile | 47,8% | 56,0% |
| Passo esatto | 22,3% | 28,8% |
| Motore qwen3.6-27b | ||
| Agente e passo esatto | 36,4% | 38,0% |
Il secondo esperimento conta di più, perché chiude il ciclo. Un agente di ricerca Open-DeepResearch mosso da qwen3.5-9b (diagnosi affidata a gemini-2.5-flash) risolve il 55,8% dei 165 compiti di validazione di GAIA e ne sbaglia 73. Ogni fallimento viene diagnosticato e rilanciato una volta sola. Con la correzione scritta da DeepDebug se ne riparano 13. Gli altri metodi ricevono lo stesso contesto più un riassunto generico del fallimento, ma non la localizzazione: Reflexion ne ripara 6, AutoManual 5, CRITIC 4. L’accuratezza complessiva passa così da 92 a 105 compiti risolti:
$$\frac{92 + 13}{165} \approx 63{,}6\%.$$
Il guadagno più grande è sui compiti di livello 2, quelli a più salti, dal 48,8% al 61,6%.
Che cosa i numeri non dicono
Il vantaggio dipende dal modello. Lo scrivono gli autori, senza riportarne la tabella: sui modelli ospitati provati, gpt-5.4-mini e gemini-3.5-flash, una lettura unica è già più forte e l’arbitrato fra due letture non la migliora. La loro conclusione è di scegliere il metodo modello per modello, non di chiamare DeepDebug sempre. Resta anche il valore assoluto: il 28,8% sulla metrica severa significa sbagliare agente o passo in più di sette casi su dieci.
La diagnosi conosce la risposta giusta. Su Who&When tutti i metodi ricevono, secondo una delle impostazioni previste dal benchmark, la risposta di riferimento del compito. È un aiuto che in un’esecuzione reale spesso non c’è. Per GAIA il protocollo non dice se la diagnosi la vedesse; ma nel rapporto d’esempio pubblicato in appendice, un problema statistico su 1.002 articoli scientifici, la correzione suggerita contiene già il calcolo che porta alla risposta esatta, 41. Il lettore può chiedersi quanto della riparazione sia localizzazione e quanto soluzione consegnata.
Si confrontano ricette intere. Gli autori lo dichiarano: l’esperimento su GAIA non isola l’effetto dell’attribuzione, perché DeepDebug fornisce insieme localizzazione, prove e una correzione scritta da sé, mentre gli altri metodi ricevono un riassunto generico. Un solo modello di partenza, e si rilanciano solo i 73 compiti che il valutatore ufficiale ha già segnato come falliti: non è, avvertono, un punteggio ottenuto alla cieca. E dalla tabella si legge un dettaglio che il testo non commenta: sui compiti di livello 3, i più difficili, nessun metodo ripara niente, e l’accuratezza resta ferma al 34,6% per tutti.
Le parti più ambiziose non sono misurate. L’Error Hub, un archivio condivisibile di casi già diagnosticati che dovrebbe fare da memoria per le diagnosi future, e il meccanismo che propone nuovi modi di fallimento per estendere la tassonomia sono implementati ma non valutati; negli esperimenti l’archivio era vuoto. Il filtro che ripulisce i casi prima di condividerli toglie gli ingressi degli eventi e maschera credenziali e dati personali che seguono schemi noti, ma non contenuti sensibili arbitrari: la condivisione è volontaria, e gli autori raccomandano di rileggere ogni pacchetto. Nessuna misura, infine, del tempo che uno sviluppatore risparmia davvero o dell’usabilità della console.
Perché conta adesso
Gli agenti stanno passando dalle dimostrazioni ai flussi di lavoro in cui un errore costa, e il debug è ancora in gran parte artigianale: si scorre la traccia, si indovina, si ritocca il prompt, si riprova, e il caso finisce dimenticato. AgentDebugX non risolve l’attribuzione, che resta difficile anche per i modelli migliori. Fa una cosa più modesta e forse più utile: dà alla catena che va dal sintomo alla riparazione un formato comune, un’interfaccia a riga di comando, una console locale e una skill installabile in agenti come Claude Code, perché un agente possa diagnosticare le proprie esecuzioni fallite. I numeri di oggi dicono che il metodo aiuta, in certi casi e con certi modelli; l’archivio condiviso di guasti, se qualcuno lo popolerà, dirà se il debug degli agenti può diventare un sapere che si accumula invece di ricominciare da capo a ogni incidente.
I commenti sono riservati agli iscritti.
Accedi per commentare