Cos’è davvero un LLM: next token prediction, tutto qui
Sotto la conversazione fluida di ChatGPT c'è un meccanismo solo: prevedere la parola successiva, miliardi di volte. Capire questo singolo…
LLM, RAG, Agents, MCP
Sotto la conversazione fluida di ChatGPT c'è un meccanismo solo: prevedere la parola successiva, miliardi di volte. Capire questo singolo…
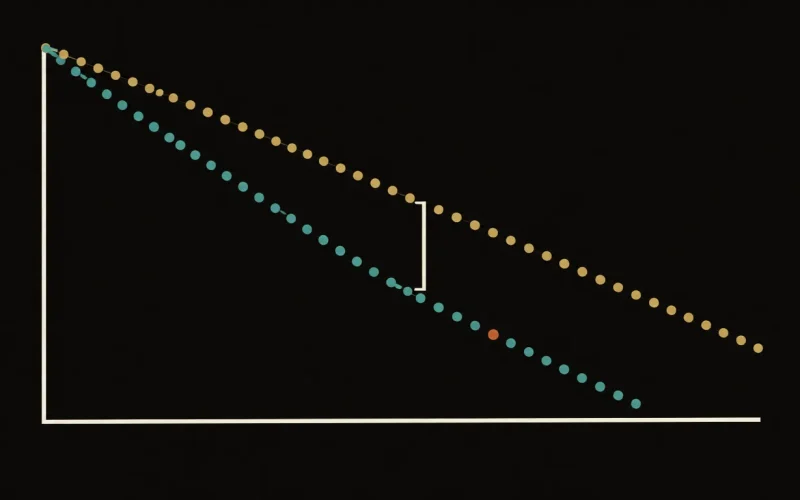
Nel 2020 un gruppo di ricercatori scopre che la qualità dei modelli linguistici migliora seguendo curve matematiche prevedibili. Da quelle…
I modelli linguistici sembrano acquisire capacità "di colpo" superata una certa scala. Ma il salto è nel modello o nel…
Un modello linguistico pre-addestrato sa completare qualsiasi testo, ma non sa cosa significhi essere utile. Il Reinforcement Learning from Human…
La Direct Preference Optimization elimina due dei tre pezzi della pipeline RLHF — il reward model e il reinforcement learning…
Un modello linguistico appena addestrato non risponde alle domande: le continua. L'instruction tuning è il passaggio che trasforma un completatore…
I modelli promettono finestre di contesto da centinaia di migliaia di token, ma quello spazio non è tutto vostro: system…
Ogni token generato da un LLM dovrebbe, in teoria, richiedere di rileggere tutto il testo precedente. Non succede, grazie a…
Un modello da 7 miliardi di parametri che gira su un portatile senza GPU dedicata non è magia: è quantizzazione.…
Specializzare un modello da miliardi di parametri sembra richiedere di riaddestrarlo tutto, con GPU da datacenter e una copia intera…