
Nel 2023 è successa una cosa curiosa: persone comuni hanno iniziato a far girare modelli linguistici da miliardi di parametri su MacBook, su PC da gaming, perfino su Raspberry Pi. Nessuna GPU da datacenter, nessun cluster. Il merito non era di modelli improvvisamente più piccoli, ma di una tecnica che li fa pesare meno senza toglierne i parametri: la quantizzazione.
Quanti bit servono davvero, quanto si sbaglia arrotondando e cosa fanno le poche componenti enormi: nel libro.
Leggi «Meno bit: che cosa si perde arrotondando» nel libro →
L’idea, ridotta all’osso: i pesi di un modello sono numeri, e i numeri si possono scrivere con più o meno cifre. Scriverli con meno cifre fa risparmiare memoria. La parte interessante è capire quanto si può tagliare prima che il modello inizi a dire sciocchezze — e la risposta, sorprendentemente, è: parecchio.
Un modello è un elenco di numeri, e i numeri occupano spazio
Un LLM da 7 miliardi di parametri è, materialmente, un elenco di 7 miliardi di numeri decimali. Ogni numero va conservato in memoria con un certo formato. Il formato standard per l’addestramento e l’inferenza è a 16 bit per numero (FP16 o BF16): 2 byte a parametro, quindi circa 14 GB solo per i pesi. Aggiungete la memoria di lavoro e siete fuori dalla portata di quasi tutte le schede consumer.
Ma servono davvero 16 bit per ogni peso? Qui aiuta un’analogia: pensate ai prezzi al supermercato. Il costo esatto di produzione di un pacco di pasta sarà magari 1,2734… euro, ma sullo scaffale trovate 1,29. L’arrotondamento perde informazione, eppure il sistema — fare la spesa, confrontare prezzi, decidere — funziona esattamente come prima. La quantizzazione fa la stessa scommessa sui pesi di un modello: arrotondarli a una griglia più grossolana cambia poco il comportamento complessivo.
Come funziona l’arrotondamento
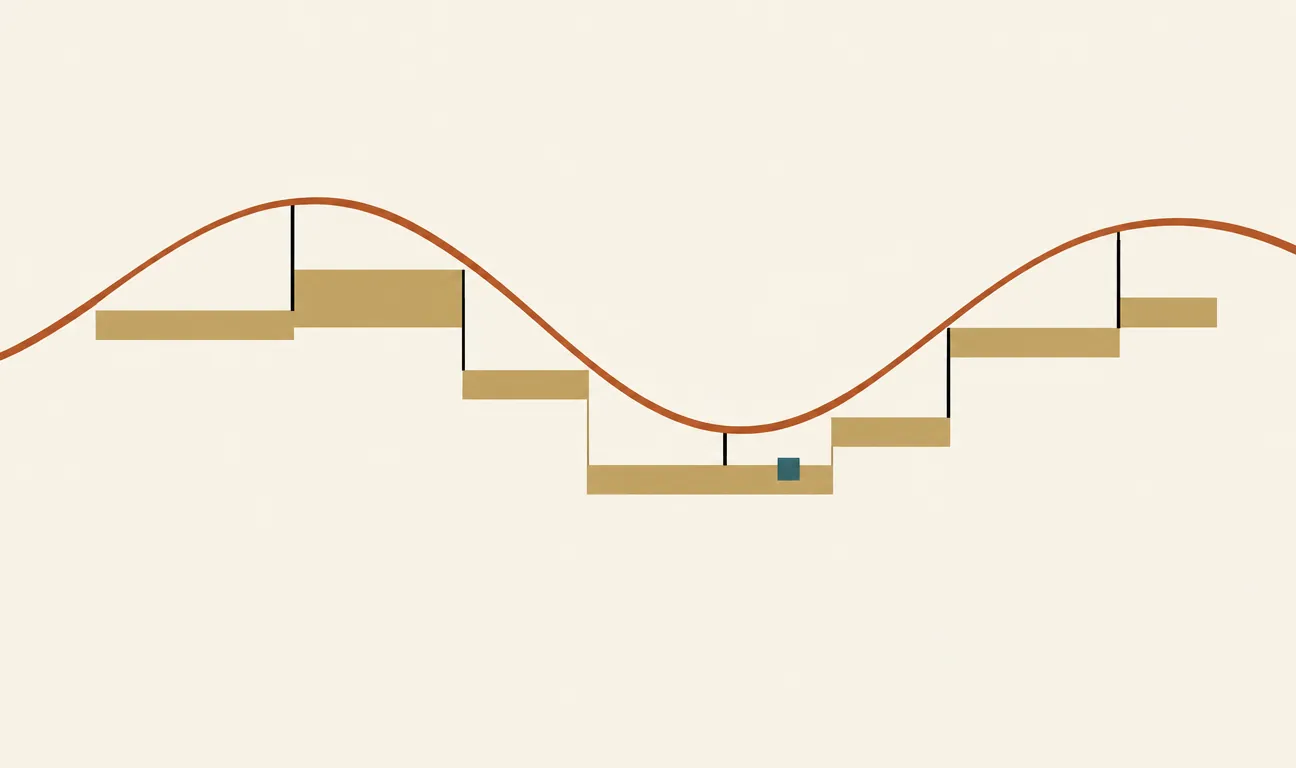
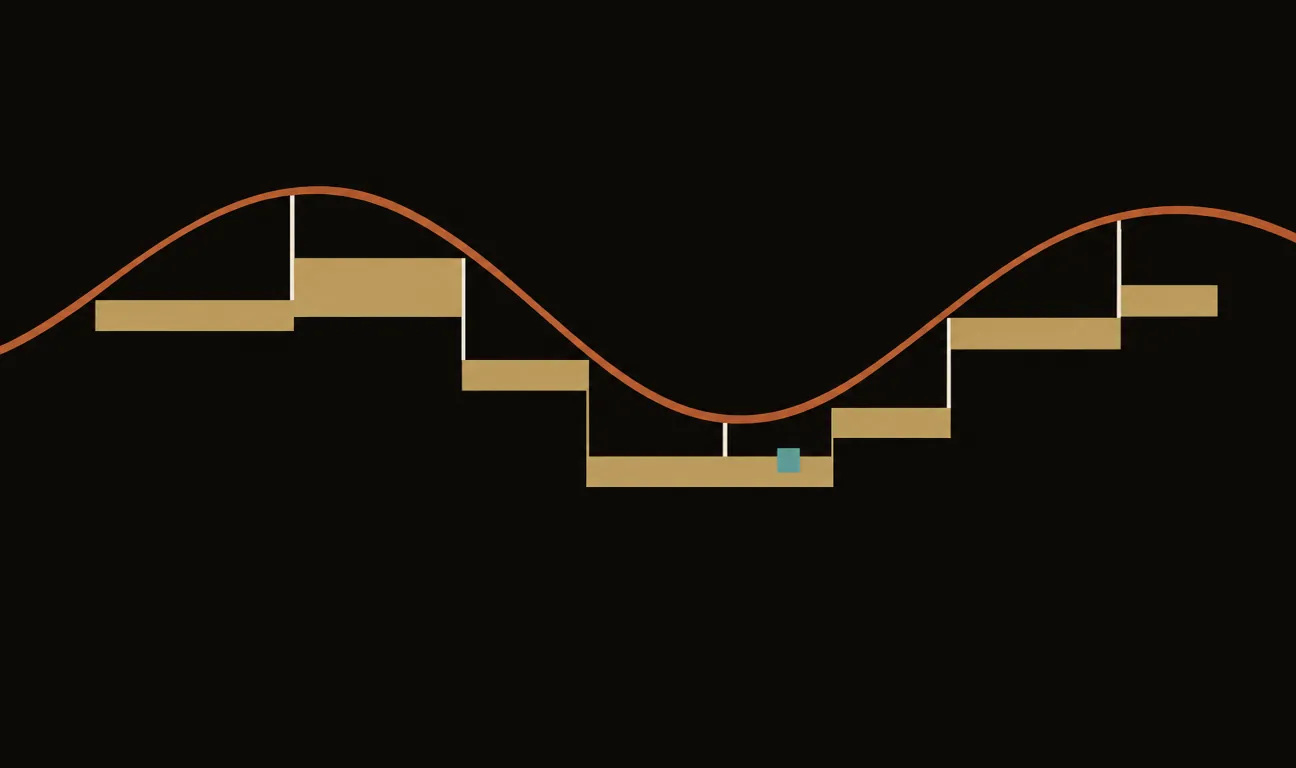
Quantizzare significa mappare i pesi originali su un insieme ridotto di valori possibili. Con 8 bit per peso (INT8) i valori rappresentabili sono 256; con 4 bit (INT4) soltanto 16. Il procedimento tipico lavora a piccoli gruppi di pesi: per ogni gruppo si individua l’intervallo di valori coperto, lo si divide in scalini uguali, e ogni peso viene sostituito dallo scalino più vicino, insieme a un fattore di scala che permette di ricostruire il valore approssimato.
È come ridurre una fotografia da milioni di colori a una tavolozza di 16: se la tavolozza è scelta bene per ogni zona dell’immagine, l’occhio fatica ad accorgersene. Il fattore di scala per gruppo è esattamente questo: una tavolozza locale, adattata ai pesi di quel gruppo.
Il diavolo sta negli outlier: in ogni gruppo ci sono pochi pesi molto più grandi degli altri, e sono spesso quelli che contano di più. Se la griglia si allarga per contenerli, tutti gli altri pesi vengono arrotondati male. Le tecniche moderne di quantizzazione post-training — come GPTQ e AWQ — sono in gran parte strategie per proteggere questi pesi importanti, ad esempio identificandoli osservando come il modello reagisce a un piccolo campione di dati.
La memoria per i soli pesi di un modello da 7 miliardi di parametri, alle diverse precisioni: ogni dimezzamento dei bit dimezza i gigabyte. La qualità, entro certi limiti, cala molto più lentamente.
Quanto si perde davvero
La sorpresa empirica, documentata da anni di benchmark della community e della letteratura, è che la curva della qualità non scende in proporzione ai bit risparmiati. Passare da 16 a 8 bit è in molti casi quasi indolore. A 4 bit, con le tecniche moderne, la degradazione resta contenuta per la maggior parte degli usi: il modello scrive, riassume e conversa in modo difficilmente distinguibile dall’originale, anche se i compiti più fragili — matematica a più passaggi, codice complesso, lingue poco rappresentate — tendono ad accusare il colpo per primi.
Sotto i 4 bit il terreno si fa ripido: a 3 e soprattutto a 2 bit gli arrotondamenti iniziano a mordere sul serio, e servono metodi molto più sofisticati per ottenere qualcosa di utilizzabile.
Un modello grande quantizzato spesso batte un modello piccolo a piena precisione, a parità di memoria: meglio tanti parametri approssimati che pochi parametri esatti.
Questa osservazione, controintuitiva ma ricorrente nei confronti pratici, è la vera giustificazione economica della quantizzazione: non è solo un modo per far entrare un modello dove non entrava, è spesso il modo migliore di spendere i gigabyte che si hanno.
La quantizzazione che avete già usato senza saperlo
Se avete provato Ollama, LM Studio o un file .gguf scaricato da Hugging Face, avete usato modelli quantizzati: il formato GGUF del progetto llama.cpp è nato proprio per distribuire pesi compressi da eseguire su hardware comune, CPU incluse. Le sigle criptiche nei nomi dei file — Q4_K_M, Q8_0 — indicano lo schema di quantizzazione: il numero dopo la Q è, in prima approssimazione, i bit per peso.
Anche chi non scarica nulla incontra la quantizzazione ogni giorno: i modelli che girano on-device sugli smartphone sono quantizzati per necessità, e gli stessi fornitori cloud usano precisioni ridotte (come l’FP8 supportato dalle GPU recenti) per servire più utenti con lo stesso hardware. C’è poi un beneficio meno ovvio: nella generazione di testo il collo di bottiglia è la lettura dei pesi dalla memoria, non il calcolo. Pesi più piccoli significa meno byte da leggere a ogni token — quindi la quantizzazione non solo fa entrare il modello in memoria, spesso lo rende anche più veloce.
I limiti onesti
Vale la pena dire anche cosa la quantizzazione non è. Non è compressione senza perdita: qualcosa si degrada sempre, e i benchmark aggregati possono nascondere regressioni su compiti specifici che magari sono proprio i vostri. Non è uniforme: due schemi a «4 bit» possono comportarsi in modo molto diverso a seconda di come trattano gli outlier e di come raggruppano i pesi. E riguarda principalmente l’inferenza: addestrare direttamente a precisioni molto basse è un problema più difficile, ancora in piena evoluzione.
La regola pratica per chi usa modelli quantizzati è semplice: valutare sul proprio caso d’uso, non fidarsi della sigla. Un test di venti prompt rappresentativi del vostro lavoro dice più di qualunque benchmark generale.
Perché vi riguarda
La quantizzazione è il motivo per cui l’AI open source è un fenomeno di massa e non un hobby per chi possiede un datacenter. Ha spostato il confine tra «serve il cloud» e «gira in locale» — con tutto ciò che ne segue per privacy, costi e indipendenza: un modello che gira sul vostro portatile non manda i vostri documenti a nessuno e non smette di funzionare se un fornitore cambia listino.
E per chi lavora con l’AI in azienda, è una leva economica concreta: servire un modello quantizzato bene può dimezzare o quadruplicare in meno i costi di inferenza a parità di qualità percepita. Prima di pagare per hardware più grande, vale sempre la pena chiedersi: quanti di questi bit stiamo davvero usando?
I commenti sono riservati agli iscritti.
Accedi per commentare