
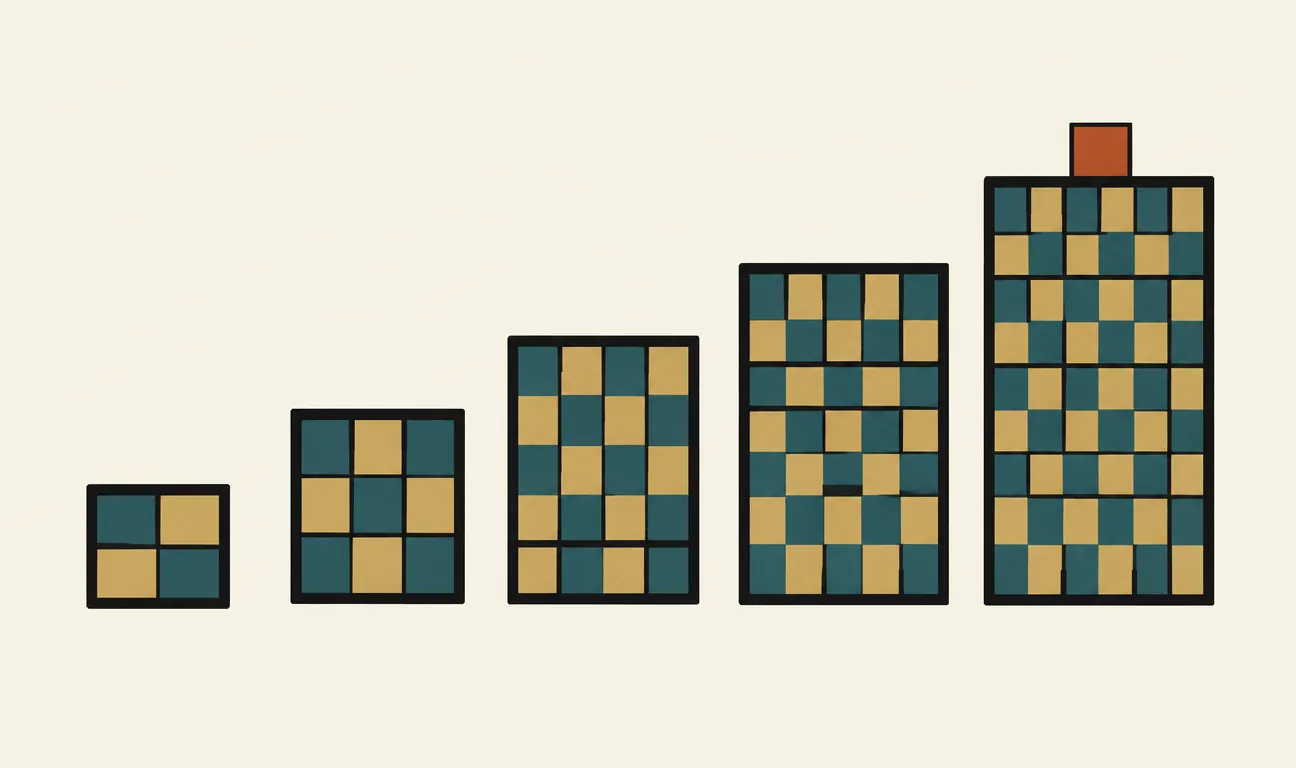
Chiedete a un modello linguistico di scrivere un sonetto e osservate i tempi: la prima parola arriva dopo una pausa percettibile, le successive scorrono via veloci, una dietro l’altra. Non è un’illusione dell’interfaccia. È il segno visibile di una delle ottimizzazioni più importanti — e meno raccontate — dell’inferenza dei modelli linguistici: la KV cache.
Il pretraining su scala web, le leggi di scala, e l’arte di scegliere la parola dopo — temperatura, top-p, KV cache — stanno nel libro.
Per capirla bisogna partire da un fatto scomodo: un LLM, per come è definito matematicamente, dovrebbe rileggere l’intero testo ogni volta che produce una parola nuova. La KV cache è il trucco che gli evita di farlo. Senza, ChatGPT e simili sarebbero troppo lenti e troppo costosi per esistere come li conosciamo.
Il problema: ogni token guarda tutti i precedenti
Un transformer genera testo un token alla volta. Per decidere il prossimo token, il meccanismo di attention confronta la posizione corrente con tutte le posizioni precedenti: ogni token produce tre vettori — query, key e value — e la query del token nuovo viene confrontata con le key di tutti i token già presenti, per poi combinare i rispettivi value.
Presa alla lettera, questa definizione implica un calcolo assurdo. Per generare il token numero 1000, il modello dovrebbe ricalcolare key e value dei 999 token precedenti. Per il token 1001, ricalcolarli di nuovo tutti. È come se, leggendo un romanzo, doveste ricominciare da pagina uno ogni volta che girate pagina: tecnicamente rileggete sempre lo stesso testo, e il tempo per avanzare di una pagina cresce man mano che procedete.
L’osservazione che salva tutto è semplice: le key e i value dei token già elaborati non cambiano mai. Il token «gatto» in posizione 12 produce sempre gli stessi vettori K e V, indipendentemente da quanto testo viene generato dopo. Ricalcolarli è lavoro buttato.
La soluzione: un archivio che cresce a ogni passo
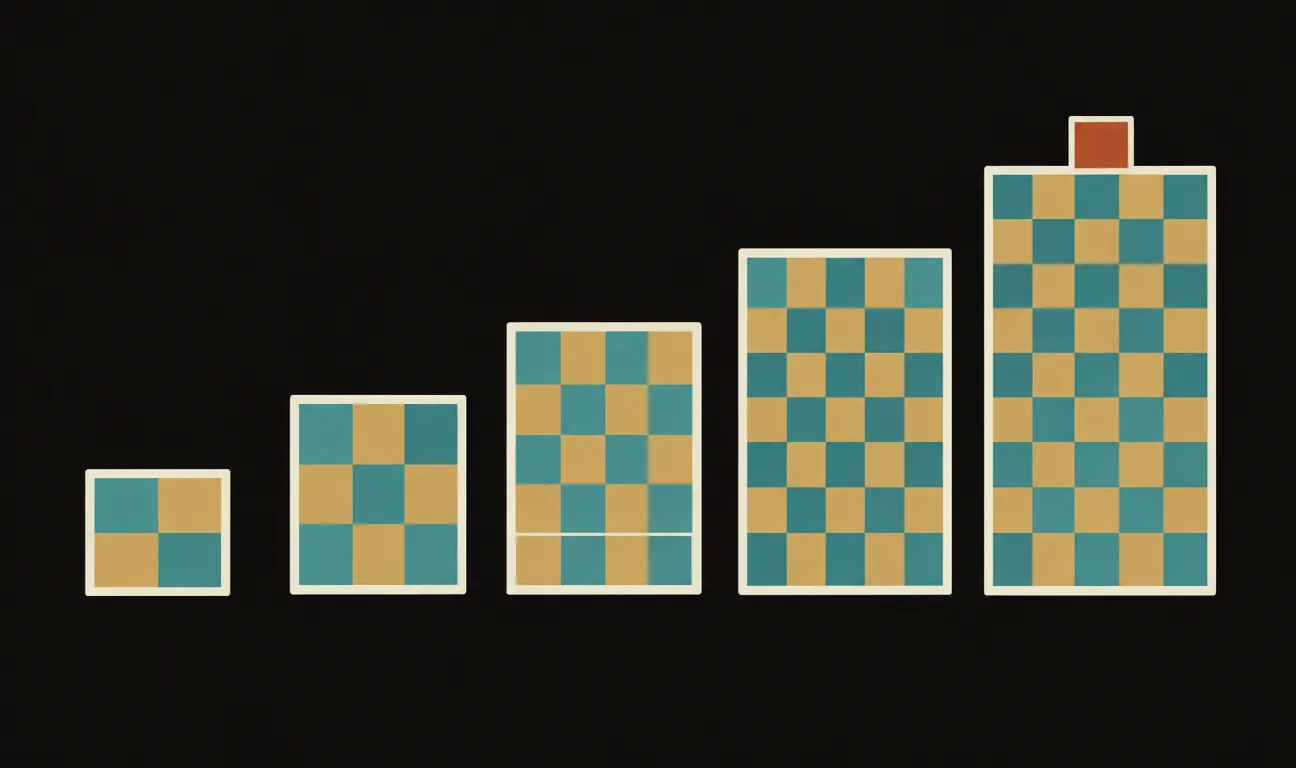
Da qui l’idea: calcolare key e value una sola volta, e conservarli in memoria. È la KV cache — letteralmente, la cache delle key e dei value. A ogni passo di generazione il modello calcola i vettori solo per il token nuovo, li aggiunge in coda alla cache, e usa la query del token nuovo per interrogare tutto l’archivio accumulato.
L’analogia più fedele è quella del verbale di una riunione. Un verbalizzatore diligente non riascolta la registrazione dall’inizio ogni volta che qualcuno prende la parola: tiene appunti, e quando arriva un intervento nuovo gli basta consultare gli appunti e aggiungere una riga. Gli appunti sono la KV cache; la riga nuova è la coppia key-value del token appena generato.
A ogni passo di generazione si calcola una sola coppia key-value nuova (terracotta); tutte le precedenti (ocra) restano in cache e vengono solo rilette.
Prefill e decode: perché la prima parola tarda
La cache spiega anche la pausa iniziale di cui parlavamo. L’inferenza di un LLM ha due fasi con caratteri opposti. La prima è il prefill: il modello legge tutto il prompt in un colpo solo e riempie la cache con le key e i value di ogni token in ingresso. È un calcolo massiccio ma parallelizzabile, il tipo di lavoro in cui le GPU eccellono.
La seconda fase è il decode: la generazione vera e propria, un token alla volta. Qui ogni passo è leggero — grazie alla cache si calcola quasi nulla — ma è intrinsecamente sequenziale: non si può generare il token 50 prima del 49. Il collo di bottiglia si sposta dal calcolo alla memoria: a ogni passo bisogna rileggere dalla memoria della GPU l’intera cache accumulata.
La generazione di testo non è limitata da quanto velocemente la GPU sa calcolare, ma da quanto velocemente sa rileggere ciò che ha già scritto.
Il prezzo: la memoria cresce con il contesto
Niente è gratis. La KV cache scambia calcolo con memoria, e il conto della memoria cresce linearmente con la lunghezza del contesto: ogni token in più aggiunge una coppia di vettori per ogni layer e per ogni testa di attention del modello. Su conversazioni lunghe decine di migliaia di token, la cache può arrivare a occupare una fetta di memoria GPU paragonabile a quella dei pesi del modello stesso.
È il motivo per cui le context window lunghe non sono solo una questione di addestramento: sono un problema di infrastruttura. Chi serve un LLM a molti utenti contemporaneamente deve tenere in memoria una cache separata per ogni conversazione attiva, come un ristorante che deve apparecchiare un tavolo dedicato per ogni cliente — e i clienti con conversazioni lunghe occupano tavoli enormi.
Buona parte della ricerca recente sull’inferenza attacca proprio questo punto. Alcune direzioni ricorrenti:
- Multi-Query e Grouped-Query Attention: più teste di attention condividono le stesse key e value, riducendo la cache di un fattore consistente con perdite di qualità contenute.
- PagedAttention (l’idea al cuore di vLLM): gestire la cache a blocchi, come la memoria virtuale di un sistema operativo, per eliminare gli sprechi di allocazione.
- Quantizzazione della cache: conservare key e value con meno bit per vettore, tema a cui dedichiamo un articolo a parte.
Il prompt caching è la KV cache venduta al dettaglio
Se avete guardato i listini delle API di OpenAI o Anthropic, avrete notato il prompt caching: i token di un prompt già visto di recente costano una frazione del prezzo pieno. Ora sapete perché è possibile: se l’inizio del prompt è identico a una richiesta precedente, il fornitore può conservare la KV cache corrispondente e saltare del tutto il prefill di quella parte.
È lo stesso principio del verbalizzatore, applicato tra una richiesta e l’altra: se la riunione ricomincia dallo stesso punto, gli appunti già presi valgono ancora. Per chi costruisce applicazioni su LLM, questo ha una conseguenza pratica immediata: mettere le parti stabili del prompt (istruzioni di sistema, documenti di riferimento) all’inizio, e le parti variabili alla fine, massimizza la porzione di cache riutilizzabile — e riduce la bolletta.
Perché vi riguarda
La KV cache sembra un dettaglio da ingegneri di inferenza, ma determina cose che chiunque usi un LLM tocca ogni giorno: il tempo di attesa prima della prima parola, la velocità con cui il testo scorre dopo, il costo per token dei fornitori, il limite pratico delle conversazioni lunghe. Quando un chatbot rallenta in una chat chilometrica, o quando una API vi sconta i token «cached», state osservando questa struttura dati al lavoro.
E c’è una lezione più generale: molti dei progressi che percepiamo come «modelli più intelligenti» sono in realtà progressi nel servire gli stessi modelli in modo più efficiente. La differenza tra un prototipo di laboratorio e un prodotto usato da milioni di persone passa spesso da idee come questa — poco fotogeniche, ma decisive.
I commenti sono riservati agli iscritti.
Accedi per commentare