
Nel maggio del 2023 un gruppo di ricercatori di Stanford mette online un paper con un sottotitolo insolitamente spavaldo: Your Language Model is Secretly a Reward Model. La tesi, se vera, avrebbe conseguenze pratiche enormi: tutta la macchina complicata dell’RLHF — addestrare un reward model separato, poi ottimizzare con reinforcement learning, con i suoi iperparametri capricciosi e i suoi costi computazionali — si potrebbe sostituire con una singola, semplice funzione di loss. Niente secondo modello, niente PPO, niente campionamento durante il training. La tesi era vera, il metodo si chiama Direct Preference Optimization, e nel giro di un anno è diventato uno degli strumenti standard per allineare modelli linguistici, soprattutto nel mondo open source.
Instruction tuning, LoRA, RLHF e DPO: tutto quello che succede dopo il pre-addestramento è nel libro.
Leggi «Dopo il pre-addestramento: istruzioni, preferenze, allineamento» nel libro →
Il peso della macchina RLHF
Per apprezzare la DPO bisogna avere presente cosa costa la pipeline classica. L’RLHF, come abbiamo visto nell’articolo precedente, funziona in tre fasi: si raccolgono confronti umani tra risposte, si addestra un reward model che impara a punteggiarle, e infine si ottimizza il modello linguistico con reinforcement learning perché massimizzi quel punteggio, tenendolo al guinzaglio con una penalità KL che gli impedisce di allontanarsi troppo dal modello di partenza.
La terza fase è la più delicata. Durante il training con PPO bisogna tenere in memoria fino a quattro modelli contemporaneamente — la policy che si sta ottimizzando, la versione di riferimento, il reward model e un value model — e bisogna generare risposte a ogni passo, perché il reinforcement learning impara dai propri tentativi. Il campionamento è lento, l’addestramento è instabile, e la messa a punto richiede un’esperienza che pochi team possiedono. È come imparare a cucinare assumendo un critico gastronomico a tempo pieno che assaggia ogni piatto: funziona, ma è un apparato sproporzionato se l’obiettivo è solo migliorare le ricette.
L’intuizione: il reward model è già dentro la policy
Il punto di partenza della DPO è un’osservazione matematica sul problema che l’RLHF sta risolvendo. L’obiettivo «massimizza il reward, ma resta vicino al modello di riferimento» ha una soluzione ottima che si può scrivere in forma chiusa: la policy ottima è il modello di riferimento ri-pesato in base al reward. Ma allora la relazione si può leggere anche al contrario: dato un modello e il suo riferimento, il rapporto tra le loro probabilità definisce implicitamente un reward. Ogni policy è, in questo senso, il proprio reward model sotto mentite spoglie — da cui il sottotitolo del paper.
Questo cambio di prospettiva permette il colpo di scena: invece di addestrare un reward model esplicito e poi cercare la policy che lo massimizza, si sostituisce quel reward implicito direttamente nella loss usata per addestrare i reward model — la stessa forma Bradley-Terry dei confronti a coppie — e si ottiene una funzione obiettivo che dipende solo dal modello, dal riferimento e dai dati di preferenza. Il problema di reinforcement learning è sparito: è diventato una classificazione binaria. Per ogni coppia di risposte, la loss spinge il modello ad aumentare la probabilità della risposta preferita e a diminuire quella della risposta scartata, misurando entrambe rispetto al modello di riferimento, così che il vincolo di vicinanza resti incorporato.
La DPO non elimina il reward model: dimostra che era già lì, nascosto nel rapporto tra le probabilità della policy e quelle del riferimento.
Le due pipeline a confronto
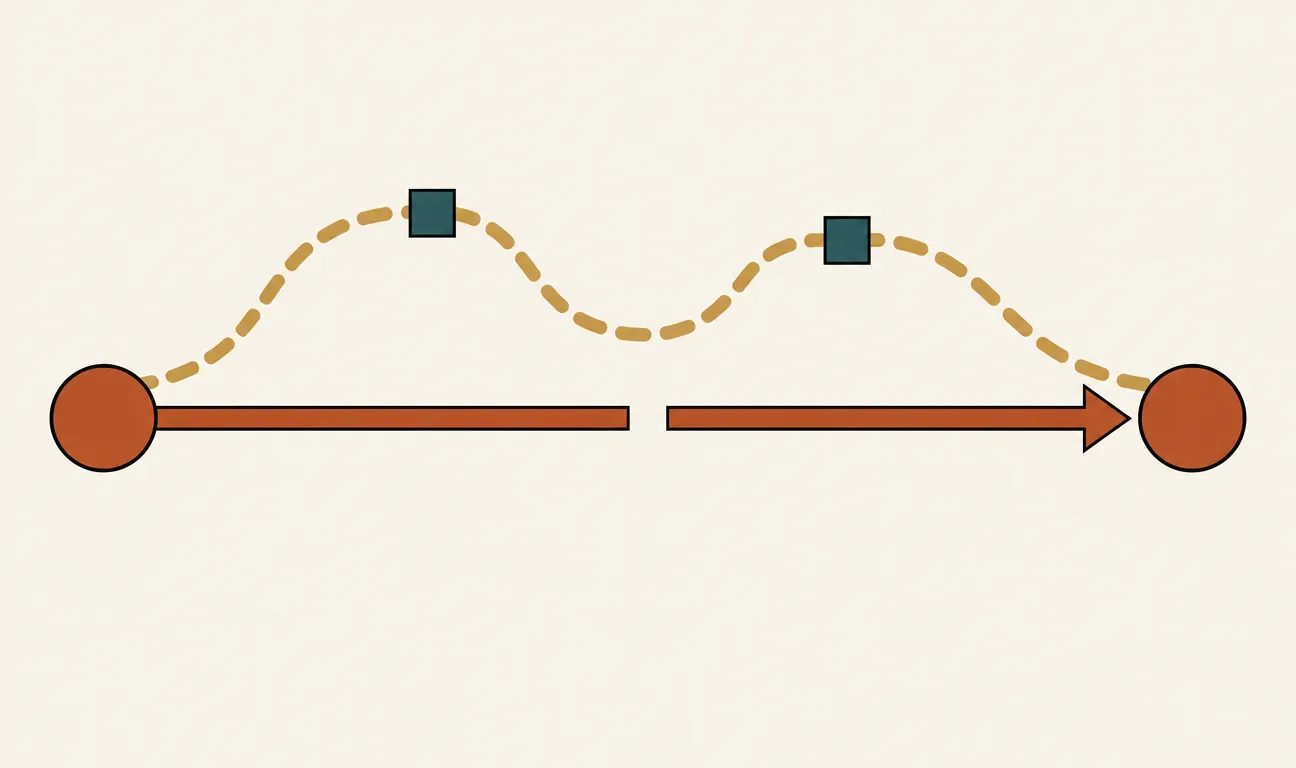
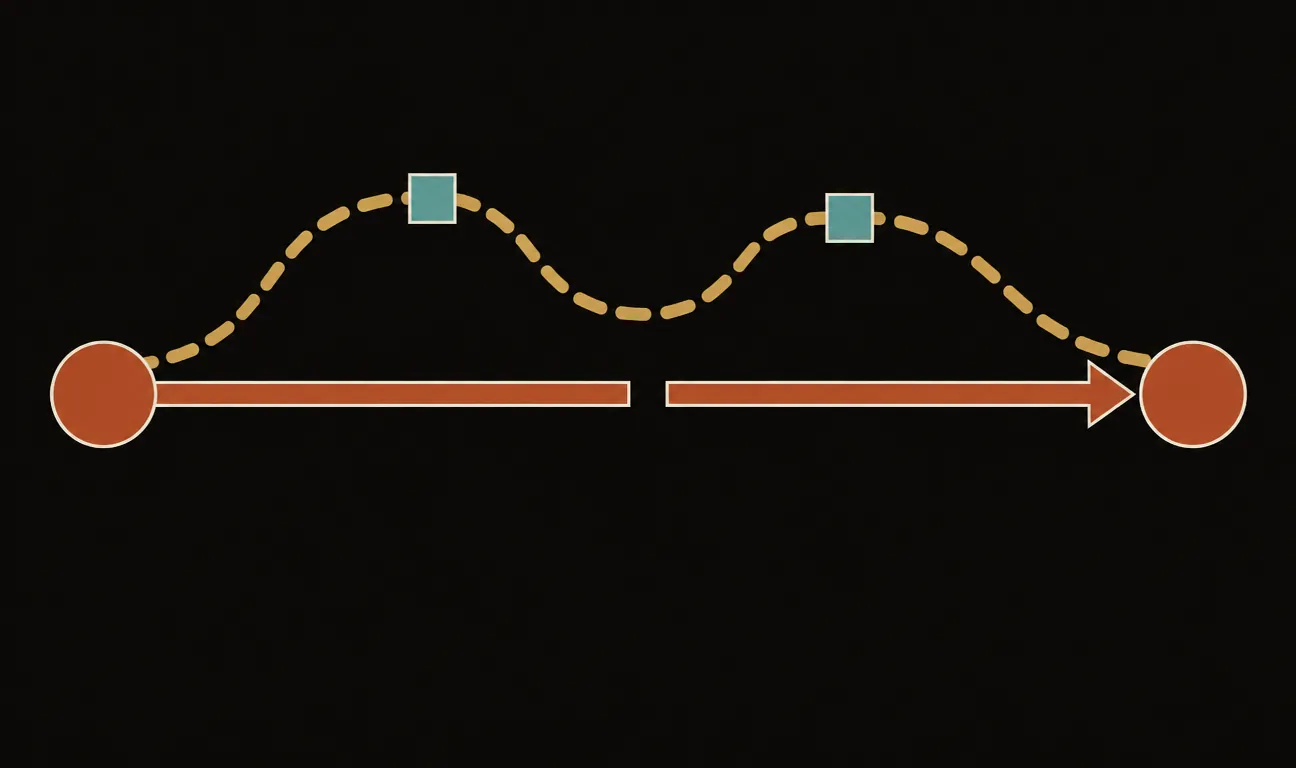
La differenza pratica si vede meglio affiancando i due percorsi. L’RLHF parte dai dati di preferenza, ci addestra sopra un reward model, e poi usa quel modello per guidare un ciclo di reinforcement learning fatto di generazione, valutazione e aggiornamento. La DPO prende gli stessi dati di preferenza e li usa direttamente: una passata di training supervisionato, con una loss speciale, e nient’altro. Stesso punto di partenza, stesso obiettivo teorico, ma un tragitto con due tappe in meno.
Le due pipeline a confronto: l’RLHF passa per un reward model esplicito e un ciclo di reinforcement learning; la DPO ottimizza il modello direttamente sui dati di preferenza.
Cosa si guadagna e cosa si perde
I vantaggi sono concreti. La DPO è più semplice da implementare — poche righe di codice sopra una pipeline di fine-tuning standard — più stabile, più economica in memoria e in calcolo, e più riproducibile: niente campionamento significa niente varianza da generazione. Per un laboratorio piccolo o un progetto open source, la differenza tra «serve un team con esperienza di RL» e «basta una GPU e un dataset di preferenze» è la differenza tra non farlo e farlo. Non a caso molti modelli open pesano proprio su DPO o sue varianti per la fase di allineamento.
Ma la semplificazione ha un prezzo, ed è giusto nominarlo. Il metodo è offline: impara solo dalle coppie di risposte presenti nel dataset, che tipicamente sono state generate da altri modelli. L’RLHF, generando durante il training, esplora: scopre risposte nuove e riceve un giudizio anche su quelle, coprendo zone dello spazio che il dataset non contiene. È la differenza tra studiare le partite degli altri e giocare le proprie: il primo metodo è più efficiente, il secondo ti espone a situazioni che i libri non coprono. Inoltre la DPO tende, se addestrata troppo a lungo, a spostare probabilità verso risposte fuori distribuzione, e i grandi laboratori — che possono permettersi la macchina completa — continuano spesso a usare pipeline con reward model espliciti, anche perché un reward model si può riusare, verificare e correggere separatamente.
Una famiglia in espansione
La DPO ha aperto un filone. Sono seguite varianti che modificano la loss o rimuovono altri pezzi: IPO aggiunge una regolarizzazione contro l’overfitting sulle preferenze, KTO lavora con giudizi singoli («buona»/«cattiva») invece che con coppie, ORPO elimina anche il modello di riferimento fondendo allineamento e instruction tuning in un solo passaggio. I dettagli differiscono, ma la direzione è la stessa: trattare l’allineamento non come un problema di reinforcement learning, che è difficile, ma come un problema di ottimizzazione diretta su dati di preferenza, che è alla portata di molti.
Perché vi riguarda
Se lavorate con modelli open source, la DPO è probabilmente il motivo per cui il modello che state usando si comporta in modo civile: è la tecnica di allineamento più accessibile, e la troverete nei changelog e nelle model card di gran parte dei modelli rilasciati dal 2024 in poi. Se dovete adattare un modello al vostro dominio — un assistente aziendale, un tono di voce specifico — un dataset di qualche migliaio di coppie di preferenze e una passata di DPO sono oggi un percorso realistico anche senza un team di ricerca. E se semplicemente seguite il settore, la vicenda della DPO è una lezione di metodo: a volte il progresso non consiste nell’aggiungere un pezzo, ma nell’accorgersi che un pezzo che tutti davano per necessario era già contenuto negli altri.
Il paper originale
Il metodo è descritto in Direct Preference Optimization: Your Language Model is Secretly a Reward Model, di Rafael Rafailov, Archit Sharma, Eric Mitchell, Stefano Ermon, Christopher D. Manning e Chelsea Finn (Stanford University), pubblicato nel 2023 e presentato a NeurIPS 2023. Il paper è disponibile su arXiv: arxiv.org/abs/2305.18290. Per il confronto con la pipeline classica vale la pena leggere anche il paper su InstructGPT, Training language models to follow instructions with human feedback (arxiv.org/abs/2203.02155), che della DPO è il termine di paragone naturale.
I commenti sono riservati agli iscritti.
Accedi per commentare