
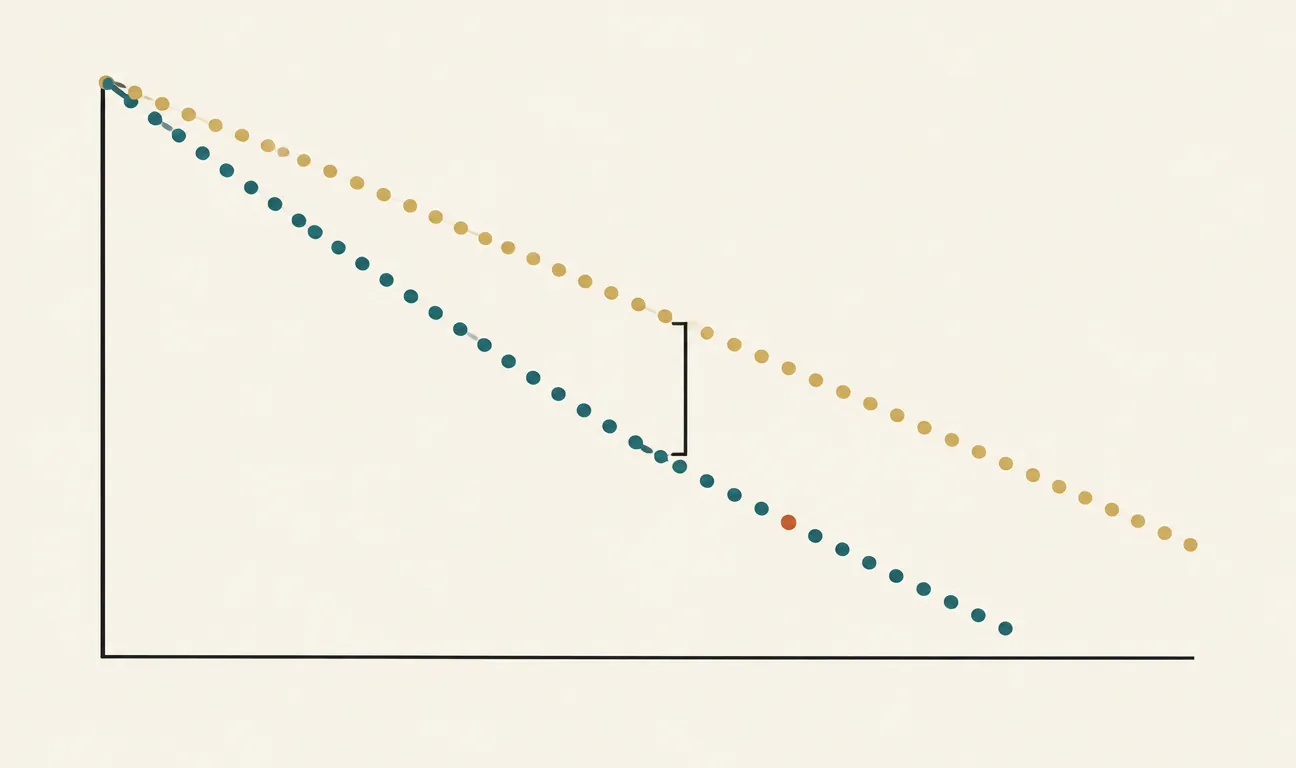
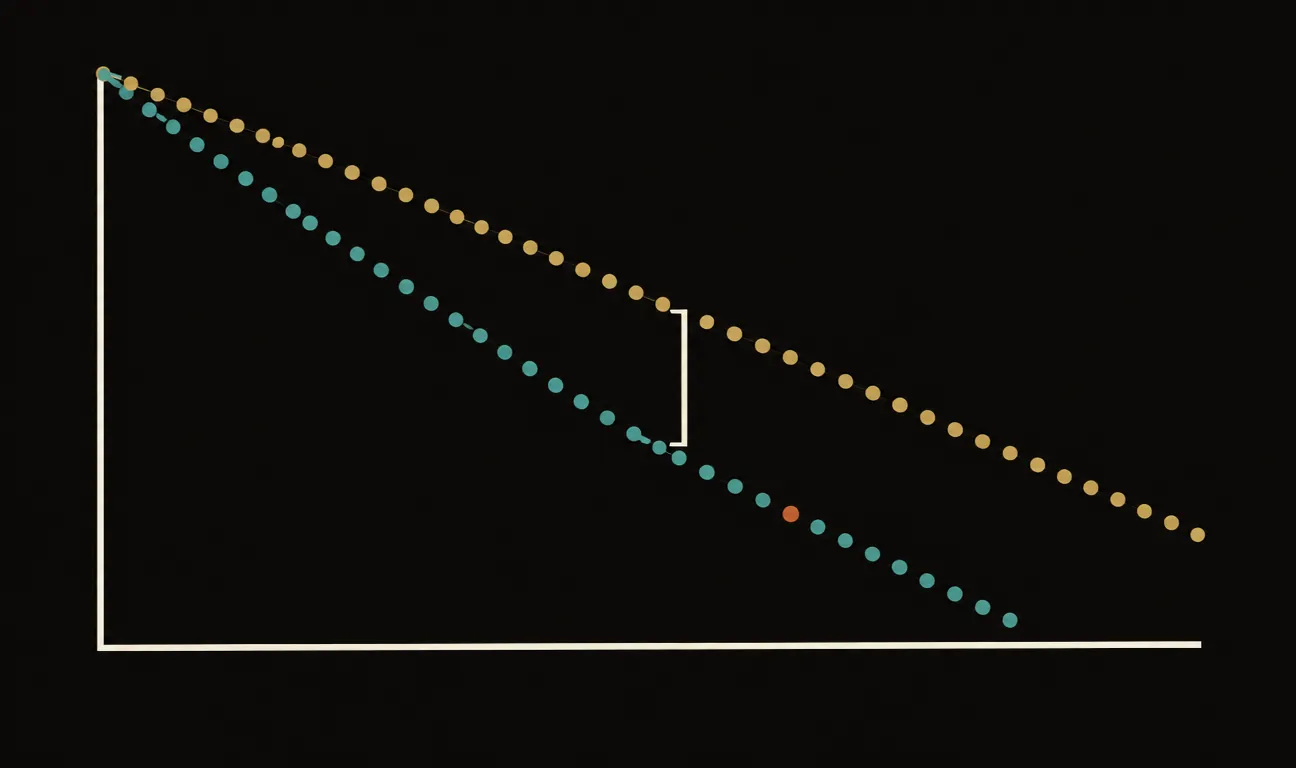
Nel gennaio 2020, un gruppo di ricercatori di OpenAI guidato da Jared Kaplan pubblica un grafico destinato a orientare miliardi di dollari di investimenti. Sull’asse orizzontale c’è il calcolo speso per addestrare un modello linguistico; su quello verticale, l’errore di predizione. E i punti, su scala logaritmica, si allineano lungo una retta quasi perfetta. Nessun plateau in vista, nessuna sorpresa: più calcolo, meno errore, con regolarità matematica. Cinque mesi dopo esce GPT-3, con 175 miliardi di parametri. La corsa ai modelli giganti è cominciata lì, su quella retta.
Il pretraining su scala web, le leggi di scala, e l’arte di scegliere la parola dopo — temperatura, top-p, KV cache — stanno nel libro.
Cosa misura, esattamente, una scaling law
Una legge di scala è una relazione empirica tra le risorse investite in un modello e la sua prestazione. Le risorse sono tre: il numero di parametri (la taglia del modello), la quantità di dati di addestramento (misurata in token) e il compute totale, cioè il numero di operazioni matematiche eseguite durante l’addestramento — che dipende da entrambi i primi due.
La prestazione, in questi studi, è la loss: quanto male il modello prevede il token successivo su testo mai visto. È una misura fredda ma onesta — non «quanto è intelligente», solo «quanto sbaglia a completare frasi». Ciò che Kaplan e colleghi osservano è che la loss scende seguendo una legge di potenza: ogni volta che moltiplichi le risorse per dieci, la loss cala di una frazione costante.
L’analogia giusta è il fertilizzante su un campo. Raddoppi il fertilizzante e il raccolto cresce, ma non raddoppia; raddoppi ancora e cresce ancora, ma di meno. I rendimenti calano — però calano in modo prevedibile. Ed è la prevedibilità, non la crescita, la vera scoperta: significa che puoi addestrare dieci modelli piccoli ed economici, tracciare la curva, e sapere in anticipo cosa otterrai spendendo cento milioni su un modello enorme. Le scaling laws hanno trasformato una scommessa alla cieca in un investimento pianificabile.
2020: la taglia sopra ogni cosa
Il paper di Kaplan non si limita a osservare le curve: prescrive come spendere. Se hai un budget di calcolo fisso, dice, conviene investirlo soprattutto in parametri — modelli più grandi — piuttosto che in dati. Un modello grande addestrato su relativamente pochi token, conclude, batte un modello piccolo addestrato a lungo.
L’industria prende la prescrizione alla lettera. Tra il 2020 e il 2022 i modelli si gonfiano: GPT-3 a 175 miliardi di parametri, Gopher di DeepMind a 280, Megatron-Turing NLG oltre i 500. I dataset, nel frattempo, crescono molto più lentamente. «Più grande è meglio» smette di essere un’ipotesi e diventa una strategia industriale.
2022: Chinchilla e la correzione di rotta
Poi, nel marzo 2022, un gruppo di DeepMind guidato da Jordan Hoffmann rifà i conti — con più esperimenti, su più scale — e trova un errore di impostazione nelle stime originali. La conclusione ribaltata: a parità di budget di calcolo, parametri e dati vanno scalati insieme, più o meno in proporzione. Come regola pratica: circa venti token di addestramento per ogni parametro. I giganti del biennio precedente erano tutti drammaticamente sotto-addestrati — muscoli enormi, pochissimo allenamento.
La prova sta nel modello che dà il nome al paper: Chinchilla, 70 miliardi di parametri — un quarto di Gopher — ma addestrato su 1.400 miliardi di token, oltre quattro volte tanto. Stesso budget di calcolo, modello quattro volte più piccolo: e Chinchilla batte Gopher praticamente su tutta la linea. Il messaggio è scomodo ed elegante insieme: la domanda giusta non è «quanto grande», ma «quanto grande rispetto a quanti dati».
Le scaling laws non promettono l’intelligenza: promettono che l’errore scende in modo prevedibile. Sono una legge sull’efficienza della spesa, non sul destino dell’AI.
Curve di loss in funzione del compute, su assi logaritmici: ogni modello a un certo punto smette di migliorare, e la frontiera compute-ottimale collega i punti in cui conviene cambiare taglia.
Dove le curve incontrano il mondo reale
Le leggi di scala descrivono un mondo pulito in cui l’unica variabile è il budget di addestramento. Il mondo reale ha attriti che le curve non vedono. Il primo è il muro dei dati: la ricetta Chinchilla chiede token di qualità in quantità enormi, e il testo umano disponibile — pulito, non duplicato, legalmente utilizzabile — non è infinito. Non a caso la ricerca si è spostata su dati sintetici e su un uso più accurato di quelli esistenti.
Il secondo attrito è che l’addestramento si paga una volta, ma l’inferenza — servire il modello a milioni di utenti — si paga per sempre. Un modello piccolo costa meno a ogni singola risposta. Per questo, dopo Chinchilla, l’industria ha iniziato a fare l’opposto dell’ottimo teorico: addestrare modelli oltre il punto compute-ottimale, spendendo di più in addestramento per avere un modello compatto ed economico da servire. La famiglia Llama di Meta è l’esempio più noto di questa filosofia. Non è una violazione delle scaling laws: è la stessa matematica, con una funzione di costo più onesta.
Terzo attrito, il più sottile: la loss non è la qualità percepita. Le curve garantiscono che l’errore di predizione scende dolcemente; non dicono nulla su quali capacità compaiono, né quando. Un miglioramento continuo della loss può tradursi in salti bruschi — o in progressi impercettibili — sulle abilità che interessano davvero a chi usa il modello.
Allora: più grande è meglio?
La risposta onesta è: più grande è meglio a parità di tutto il resto, ma «tutto il resto» quasi mai è pari. Un modello più grande con gli stessi dati e la stessa cura è quasi sempre migliore. Ma un modello più piccolo con più dati, dati migliori, o tecniche di addestramento più raffinate può batterlo — Chinchilla contro Gopher resta la dimostrazione da manuale. E infatti i modelli compatti di oggi superano i giganti di quattro anni fa su quasi ogni compito.
Le scaling laws non sono una profezia sull’intelligenza artificiale generale: sono una legge sull’efficienza. Dicono al pianificatore come spendere il prossimo euro di calcolo, non cosa il modello diventerà.
Perché ti riguarda
Se scegli modelli per lavoro, le scaling laws ti danno una bussola concreta: la taglia da sola non dice quasi nulla, chiedi sempre su quanti dati e con quanto calcolo un modello è stato addestrato. E ti spiegano il listino prezzi delle API: i modelli piccoli e sovra-addestrati esistono precisamente perché servirti una risposta costa, e qualcuno ha ottimizzato quella curva al posto tuo.
Se invece osservi il settore da fuori, le curve spiegano la sua psicologia. La fiducia — a tratti l’ostinazione — con cui le aziende investono decine di miliardi in data center nasce da lì: da una retta su scala logaritmica che, finora, ha mantenuto le promesse. La domanda da tenere d’occhio nei prossimi anni non è se le curve siano vere — lo sono state — ma se i loro presupposti, a partire dai dati disponibili, reggeranno ancora. I riferimenti originali, per chi vuole verificare: Kaplan et al., Scaling Laws for Neural Language Models (arXiv:2001.08361) e Hoffmann et al., Training Compute-Optimal Large Language Models (arXiv:2203.15556).
I commenti sono riservati agli iscritti.
Accedi per commentare