
Nel giugno 2022 un gruppo di ricercatori di Google, Stanford, DeepMind e UNC pubblica un paper con un grafico che diventa subito celebre: decine di curve piatte che, superata una certa scala del modello, si impennano all’improvviso. Il titolo è «Emergent Abilities of Large Language Models» e la tesi è netta: certe capacità — fare aritmetica a più cifre, rispondere a domande in persiano, decifrare parole con le lettere mescolate — non migliorano gradualmente con la dimensione del modello. Non ci sono, non ci sono, non ci sono. E poi, di colpo, ci sono.
Il pretraining su scala web, le leggi di scala, e l’arte di scegliere la parola dopo — temperatura, top-p, KV cache — stanno nel libro.
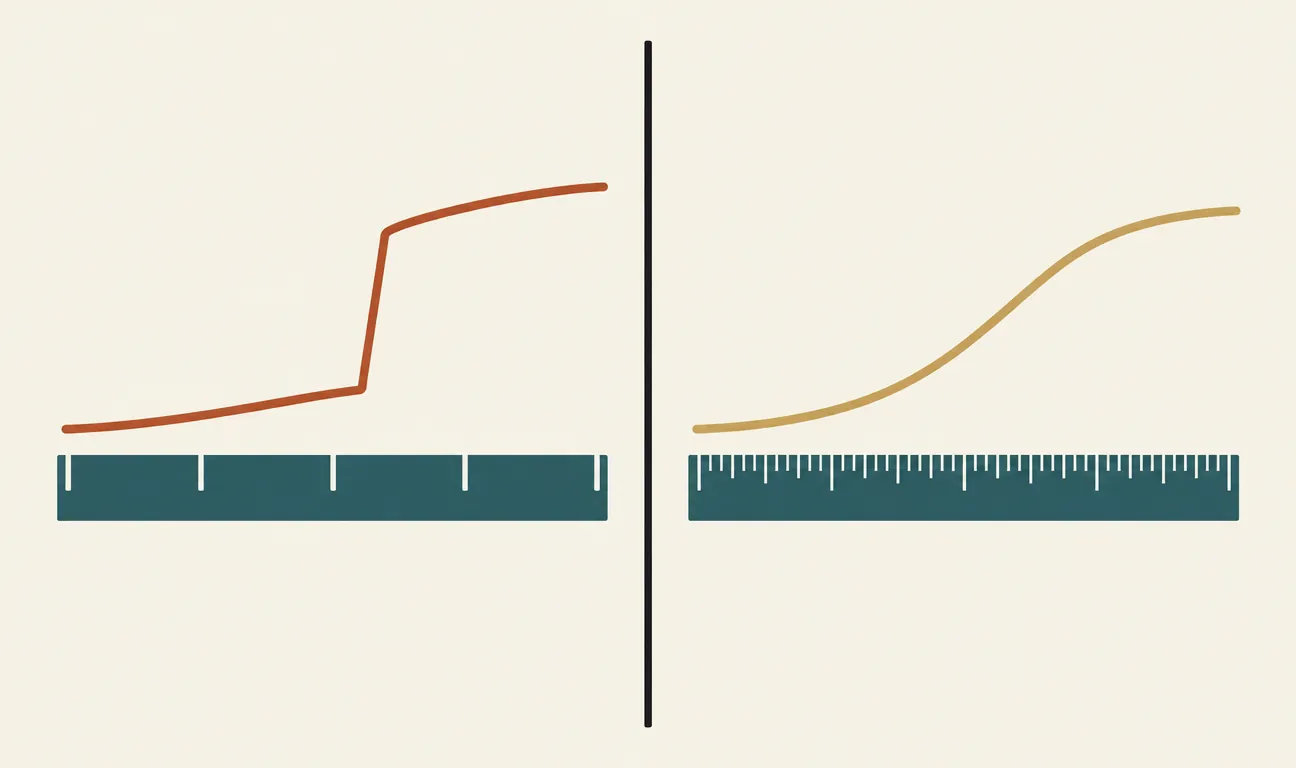
L’idea affascina e inquieta. Affascina perché richiama i fenomeni emergenti della fisica: l’acqua che diventa ghiaccio non lo fa «un po’ alla volta». Inquieta perché suggerisce che i modelli futuri potrebbero acquisire capacità impreviste che nessuna curva ci aveva fatto intravedere. Un anno dopo, però, un secondo paper — «Are Emergent Abilities of Large Language Models a Mirage?», di Rylan Schaeffer, Brando Miranda e Sanmi Koyejo di Stanford — propone una spiegazione molto meno esotica: il salto non sta nel modello, ma nel righello con cui lo misuriamo.
Cosa si intende per «emergente»
Nel paper originale la definizione operativa è questa: una capacità è emergente se è assente nei modelli piccoli e presente in quelli grandi, e se la transizione non è prevedibile estrapolando le curve dei modelli più piccoli. In pratica: sull’asse orizzontale metti la scala (parametri o compute di addestramento), su quello verticale la performance sul compito. Se la curva resta vicino allo zero per ordini di grandezza e poi schizza verso l’alto in un intervallo stretto, hai un’abilità emergente.
Il paper del 2022 ne documenta un’ampia casistica, su benchmark come BIG-Bench e MMLU. L’aritmetica a tre cifre è l’esempio più citato: i modelli della famiglia GPT-3 sotto una certa soglia sbagliano quasi tutto, quelli sopra azzeccano una quota consistente delle somme. Il grafico ha la forma di un gradino.
Il sospetto: è la metrica a fare il gradino
L’obiezione di Schaeffer e colleghi parte da un’osservazione semplice: quasi tutte le abilità emergenti catalogate sono misurate con metriche discontinue, tipicamente l’exact match — la risposta vale 1 se è identica a quella attesa, 0 altrimenti. Non esistono mezzi punti.
Facciamo un esempio concreto. Un modello deve calcolare 234 + 589 = 823. Un modello piccolo risponde 1147: zero. Un modello medio risponde 833: ha sbagliato una sola cifra, ma vale comunque zero. Un modello grande risponde 823: uno. Con l’exact match, il progresso del modello medio — che ha imparato quasi tutto il meccanismo del riporto — è invisibile. La metrica lo tratta esattamente come il modello che sparava numeri a caso.
È come valutare uno studente di pianoforte solo chiedendogli di eseguire un brano intero senza un solo errore. Per anni il giudizio sarebbe «non sa suonare», poi un giorno «sa suonare». La discontinuità sta nel criterio di valutazione, non nell’apprendimento, che sotto la superficie procedeva in modo del tutto graduale.
La controprova
Il paper del 2023 fa tre verifiche. Primo: prende gli stessi compiti «emergenti» e li rimisura con metriche continue — per l’aritmetica, ad esempio, la distanza di edit tra la risposta prodotta e quella corretta, o la log-verosimiglianza assegnata al token giusto. Risultato: il gradino sparisce, la curva torna liscia e prevedibile. Secondo: fa l’operazione inversa su compiti notoriamente graduali, imponendo metriche discontinue, e ottiene finti gradini a comando. Terzo: mostra che si possono fabbricare «abilità emergenti» perfino in reti convoluzionali su MNIST, un contesto dove nessuno le aveva mai rivendicate, semplicemente scegliendo la metrica giusta — o meglio, sbagliata.
La domanda giusta non è «cosa sa fare il modello», ma «cosa riesce a vedere la metrica». Sono due domande diverse, e confonderle produce grafici spettacolari e conclusioni fragili.
C’è anche un fattore statistico più banale: la risoluzione. Se un compito ha una probabilità di successo bassissima per i modelli piccoli, servono moltissimi esempi di test per distinguerla da zero. Con benchmark da poche centinaia di domande, una performance dell’1% e una dello 0,01% risultano entrambe «zero», e il passaggio da invisibile a visibile assomiglia a un salto anche quando non lo è.
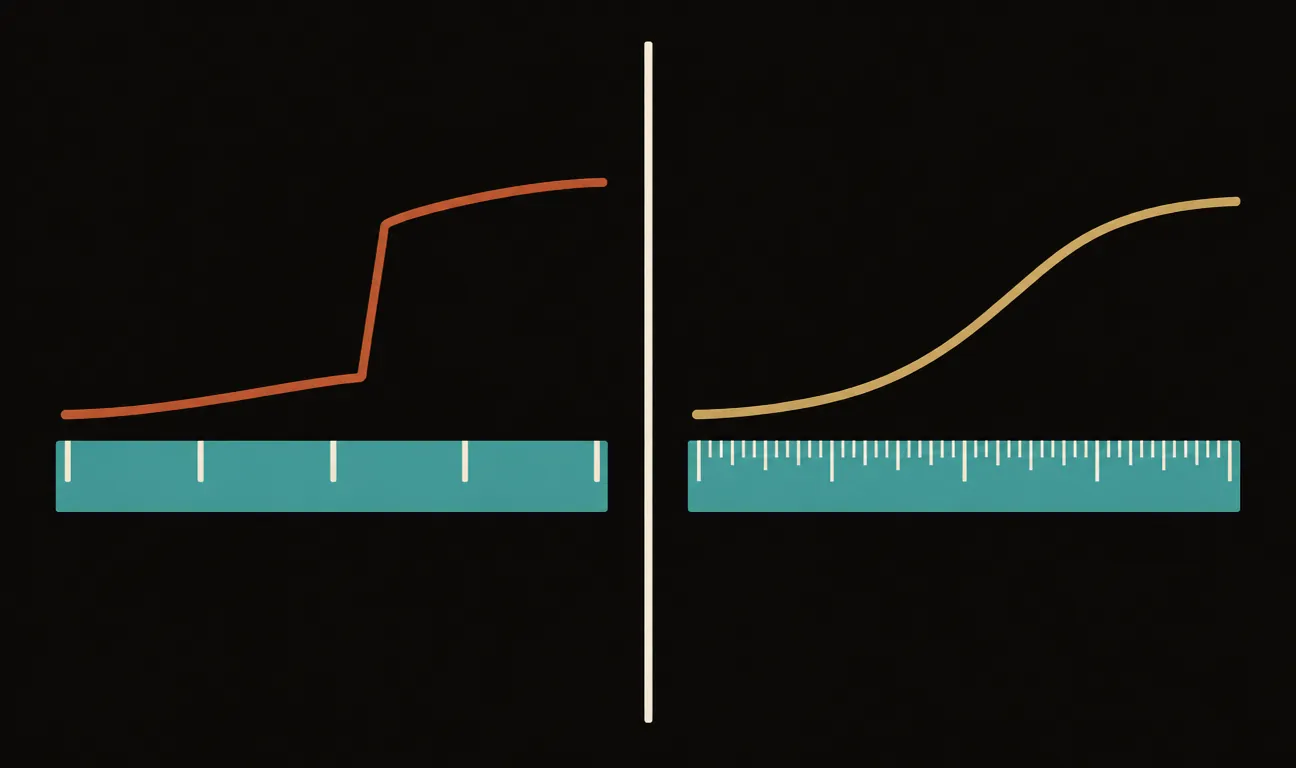
Lo stesso apprendimento graduale visto attraverso due metriche: quella discontinua (a sinistra) produce una curva a gradino, quella continua (a destra) rivela un progresso regolare.
Quindi le emergenze non esistono?
Attenzione a non ribaltare il pendolo. Il paper di Stanford non dimostra che nessuna capacità emerge in modo brusco: dimostra che gran parte dei casi celebri si spiega con la scelta della metrica, e che l’onere della prova va alzato. Restano questioni aperte. Alcuni compiti — come certe forme di ragionamento in più passaggi — sono intrinsecamente «tutto o niente»: se sbagli un passaggio intermedio, il risultato finale crolla, e una metrica continua onesta è difficile da definire. Inoltre, per l’utente finale conta l’exact match: se il modello sbaglia una cifra del bonifico, il fatto che «ci fosse quasi» è una consolazione magra. La discontinuità percepita nell’uso reale può essere genuina anche quando la capacità sottostante cresce in modo liscio.
E c’è il fenomeno del grokking, documentato in contesti controllati: reti che, dopo aver memorizzato i dati di training, molto più tardi «generalizzano» in modo relativamente repentino. È un caso diverso — riguarda il tempo di addestramento, non la scala — ma tiene aperta la porta a transizioni reali, non solo apparenti.
Perché la disputa conta anche fuori dai laboratori
Questa non è una querelle accademica. Se le capacità emergono in modo imprevedibile, allora la sicurezza dei modelli futuri è difficile da valutare in anticipo, e chi regola — pensiamo alle soglie di compute dell’AI Act europeo — naviga a vista. Se invece le capacità crescono in modo continuo e misurabile, allora possiamo costruire sistemi di allerta: metriche continue che segnalano l’arrivo di una capacità prima che diventi visibile all’exact match. La seconda ipotesi è molto più rassicurante per chi fa governance, ed è anche, per fortuna, quella meglio supportata dai dati oggi disponibili.
Per chi lavora con i modelli la lezione è pratica: quando un benchmark mostra un salto, la prima domanda da farsi è come è costruita la metrica. E per chi legge le notizie sull’AI, il criterio è lo stesso: un grafico a gradino è un ottimo titolo, ma prima di crederci vale la pena chiedersi se il gradino sta nel fenomeno o nello strumento di misura. È una domanda vecchia quanto la scienza sperimentale, e i modelli linguistici non l’hanno resa meno attuale.
I paper originali
Il paper che ha introdotto il concetto è «Emergent Abilities of Large Language Models» di Jason Wei e colleghi (2022), disponibile su arXiv: arxiv.org/abs/2206.07682. La replica è «Are Emergent Abilities of Large Language Models a Mirage?» di Rylan Schaeffer, Brando Miranda e Sanmi Koyejo (2023), premiato a NeurIPS 2023: arxiv.org/abs/2304.15004. Letti in coppia, sono un piccolo corso accelerato su come si costruisce — e si smonta — un’affermazione scientifica.
I commenti sono riservati agli iscritti.
Accedi per commentare