
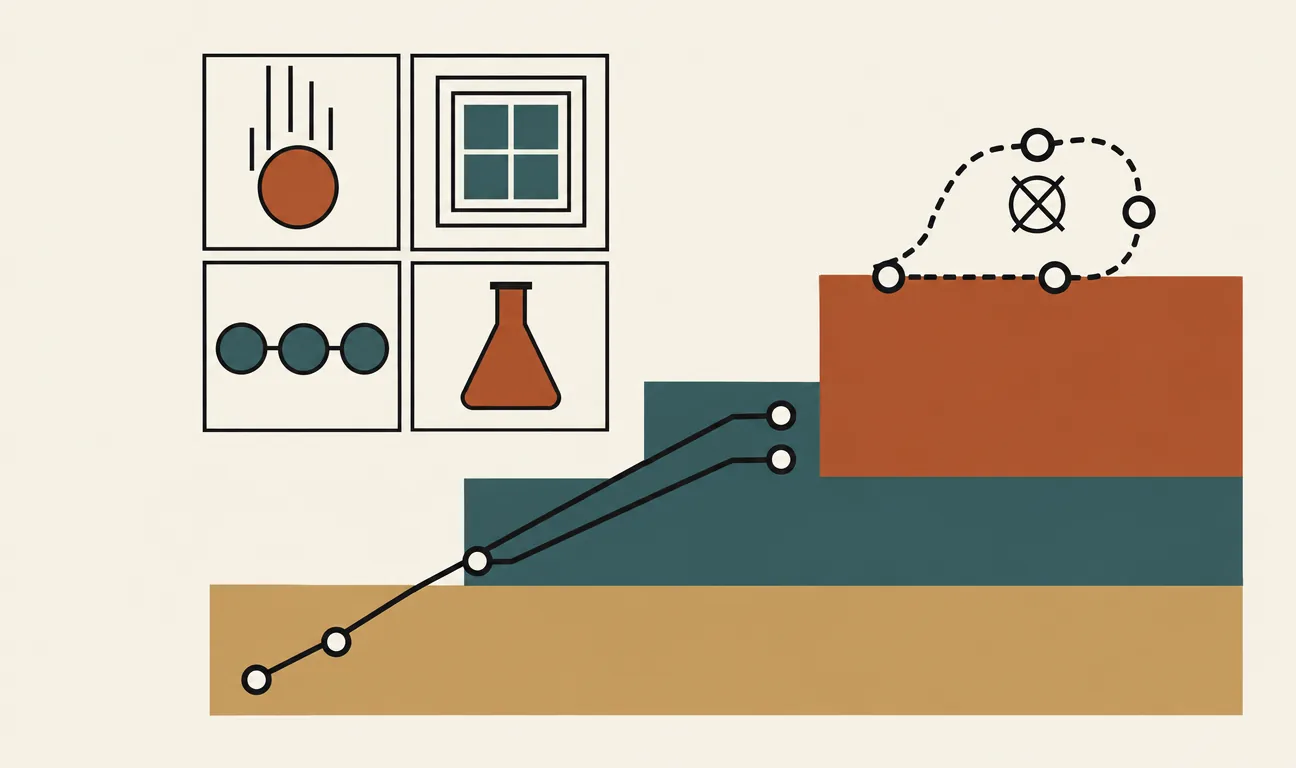
Tre persone guardano la stessa mappa della metropolitana. La prima sa soltanto qual è la fermata successiva: le basta per non scendere nel posto sbagliato. La seconda pianifica il tragitto intero, con i cambi, e sa dire che cosa succede se invece della linea verde prende la rossa. La terza, un mattino, scopre che una stazione è chiusa per lavori, se ne accorge perché il treno non si ferma dove la mappa diceva, e ridisegna la mappa prima di rimettersi in viaggio. Tutte e tre hanno un «modello del mondo», ma non la stessa cosa: chi le confonde paragona mestieri diversi.
È il problema da cui parte Agentic World Modeling: Foundations, Capabilities, Laws, and Beyond, caricato su arXiv il 24 aprile 2026 (2604.22748) e arrivato alla terza versione il 16 giugno. Lo firma una cinquantina di autori di tredici istituzioni, fra cui HKUST, la National University of Singapore, Oxford e Cambridge; Xuan Billy Zhang è indicato come responsabile del progetto, Jiaya Jia chiude l’elenco dei senior. Sono 92 pagine, oltre 400 lavori citati e più di cento sistemi riassunti. Gli autori la definiscono una survey «guidata da una tesi»: non presenta un modello né un benchmark nuovo, propone un modo di classificare quelli esistenti e chiede alla comunità di adottarlo.
Una parola, cinque comunità
Nella visione artificiale un world model è spesso un generatore di video o di scene 3D che resta coerente nel tempo. Nel reinforcement learning è la dinamica appresa con cui l’agente «immagina» il futuro prima di agire, sulla linea di Dreamer e MuZero. Negli agenti basati su modelli linguistici è una simulazione testuale della pagina web o dell’interlocutore. Il paper la chiama frammentazione concettuale: chi viene dalla visione giudica un world model dalla fedeltà dei fotogrammi, chi viene dal reinforcement learning dal successo nel compito, e un articolo può riportare grandi progressi secondo un’accezione restando non confrontabile secondo l’altra.
La scelta degli autori è di giudicare un world model per la qualità delle decisioni che rende possibili a un agente, non per quanto è bello quello che produce. Da qui discendono i due assi della proposta.
Che cosa si intende per world model, da Ha e Schmidhuber a Dreamer, e perché un agente che immagina prima di agire impara con meno esperienza: le basi sono nel capitolo del libro dedicato.
Tre gradini
Il primo asse sono tre livelli di capacità, scritti nella notazione dei processi decisionali parzialmente osservabili. Il livello L1, il Predictor, fornisce operatori locali: dato lo stato latente e l’azione, prevede il passo successivo, $p_\theta(z_t \mid z_{t-1}, a_t)$, più le componenti che servono a costruire quello stato e a ridecodificarlo in osservazioni. Non promette nulla su che cosa succede quando quei passi si concatenano.
Il livello L2, il Simulator, risponde a domande su intere traiettorie,
$$\hat{p}(\tau \mid z_0, a_{1:H}, c), \qquad \tau = (z_1, \dots, z_H),$$
dove $H$ è l’orizzonte e $c$ il vincolo che le traiettorie devono rispettare. Per salire da L1 a L2 non basta prevedere bene un passo: servono tre condizioni che il paper chiama di confine. La coerenza a lungo orizzonte (la simulazione resta usabile per $H$ passi invece di sfaldarsi per errori che si accumulano); la sensibilità agli interventi (se cambio un’azione, il futuro previsto cambia in modo stabile e nella direzione giusta); la coerenza con i vincoli (il futuro generato rispetta le leggi del dominio). Per gli autori nessuna implica le altre: un modello può produrre simulazioni coerenti che non rispondono ai comandi, o traiettorie reattive che violano le leggi del dominio.
Il livello L3, l’Evolver, è quello che dà il senso al titolo. Qui il modello stesso diventa oggetto di revisione: un ciclo progetta un esperimento, lo esegue, osserva l’esito e ne ricava evidenza con cui aggiornare lo stack, $(M_t, d_t) \to M_{t+1}$. Anche qui tre condizioni: la diagnosi deve poggiare su evidenza riproducibile, la correzione deve diventare una risorsa persistente e riusabile (una regola, un test, una skill), non solo una toppa temporanea nel contesto, e l’aggiornamento deve passare controlli di regressione e di robustezza, con rollback e rilascio graduale, prima di diventare la versione di default.
I livelli non sono tipi di modello ma capacità che lo stesso agente invoca secondo il momento: reazioni rapide a L1, confronto fra piani a L2, revisione del modello solo quando fallisce in modo sistematico e ripianificare non basta più.
Quattro leggi
Il secondo asse spiega la parola «Laws» del titolo, che qui non ha niente a che vedere con le leggi di scala: sono i regimi di leggi che governano le transizioni in un dominio. Nel mondo fisico sono contatti, collisioni, gravità, e una violazione si riconosce subito, perché un motore fisico può dire se due oggetti si sono compenetrati. Nel mondo digitale sono la semantica dei programmi, i contratti delle API, le macchine a stati delle interfacce: una chiamata a una funzione che non esiste si verifica eseguendo il codice. Nel mondo sociale sono credenze, obiettivi e norme, con due complicazioni che gli altri regimi non hanno: le transizioni sono riflessive (quello che gli agenti credono sullo stato cambia lo stato) e normative (conta anche che cosa dovrebbe succedere). Nel mondo scientifico le leggi non sono note in forma chiusa e di solito si controllano contro dati di laboratorio o di osservazione.
Dove sono i sistemi veri
La mappa che ne esce è sbilanciata. Il paper elenca cinque modi ricorrenti in cui i simulatori di livello L2 falliscono: l’errore che si accumula passo dopo passo; stati diversi che il modello confonde, come due pagine di un’interfaccia quasi identiche; il modello che non risponde alle azioni, per cui chiedersi «meglio A o B?» non ha senso; le scappatoie del simulatore che la pianificazione trova e sfrutta sistematicamente; la sicurezza eccessiva quando l’ambiente cambia. Sul terzo punto il paper è netto: un modello visivamente ricco ma poco condizionato dalle azioni serve alla pianificazione meno di un modello rozzo che ai comandi risponde.
Per il livello L3, invece, gli esempi più completi vengono dalla scienza automatizzata, l’unico regime che il paper giudica «consolidato». CAMEO (2020) scopre materiali con un ciclo di apprendimento attivo bayesiano a un sincrotrone. A-Lab (2023), in 17 giorni di funzionamento a ciclo chiuso, ha condotto 353 esperimenti e ottenuto 36 composti su 57 obiettivi, usando i fallimenti come evidenza per le ricette successive. Nel digitale la maturità è «parziale»: FunSearch e AlphaEvolve hanno un valutatore automatico che fa da cancello di regressione, ma nella tabella del paper a entrambi manca il passo che rivede il modello; di AlphaEvolve il paper ricorda il miglioramento dell’algoritmo di Strassen dopo 56 anni. Nel sociale il livello L3 è «aspirazionale»: il caso più vicino citato sono costituzioni per società di agenti fatte evolvere con programmazione genetica guidata da un modello linguistico, che superano del 123%, secondo quanto dichiarato, le regole scritte a mano su un punteggio di stabilità.
Misurare le decisioni, non i fotogrammi
La parte più utile per chi lavora con gli agenti è la critica alla valutazione. Metriche come FID, FVD o SSIM misurano la qualità percettiva e, scrivono gli autori, sono nella migliore delle ipotesi indicatori deboli della capacità di un agente: un video può essere convincente e contenere oggetti che si muovono in modo impossibile. La proposta sono due misure orientate alla decisione. L’Action Success Rate è la frazione di compiti riusciti nell’ambiente reale da un pianificatore che sceglie le azioni sulle simulazioni del modello. La Counterfactual Outcome Deviation misura quanto divergono gli esiti simulati di due sequenze di azioni che differiscono in un solo passo $k$:
$$\mathrm{COD}(k) = \mathbb{E}\big[\, d(\hat{z}_H^{(1)}, \hat{z}_H^{(2)}) \,\big].$$
Qui $d$ è una distanza scelta secondo il compito. Un valore basso segnala un modello sordo alle azioni, quindi inutile per ragionare sui controfattuali. Accanto, un pacchetto minimo per la riproducibilità (MREP, nell’acronimo inglese) in cinque punti: versioni degli ambienti bloccate per commit, tracce complete dei passaggi intermedi, classificazione automatica dei fallimenti secondo le cinque categorie, intervalli di confidenza e profili di prestazione invece di stime puntuali, dichiarazione esplicita delle condizioni di confine che un benchmark mette alla prova.
La diagnosi che accompagna la proposta è scomoda: la grande maggioranza dei sistemi è valutata solo a livello L1, con accuratezza a un passo o tasso di successo senza perturbazioni; i protocolli di tipo L2 esistono ma non sono pratica comune; l’infrastruttura per valutare L3 è, fuori dalla scienza automatizzata, «sostanzialmente inesistente». Lo stesso benchmark misura livelli diversi a seconda del protocollo: su SWE-bench completare una riga è L1, risolvere un problema su più file con guasti iniettati è L2, trasformare lo script di riproduzione in un test di regressione riusabile sarebbe L3.
I limiti
Il primo lo dichiarano gli autori in copertina: è un preprint non revisionato, che potrebbe contenere imprecisioni. Il secondo: è una tassonomia, e le etichette di copertura dei benchmark (forte, media, debole) sono assegnate, parole loro, per giudizio. ASR e COD sono proposte, non misure fatte: il paper non le calcola su nessun sistema. E, osservazione nostra, una COD alta dice che il modello reagisce alle azioni, non che reagisce nella direzione giusta, che pure fa parte della definizione di sensibilità agli interventi: la metrica da sola non lo cattura.
La sezione sulla sicurezza è onesta sui propri numeri. Riporta un attacco a un world model di guida con un successo mirato dichiarato del 55% e un jailbreak di un modello mondo-azione per robot all’84,2%, ma avverte che gli studi di attacco sono preprint recenti di pochi gruppi di autori sovrapposti, in attesa di replica indipendente, e che quelle cifre vanno lette come preliminari. Infine, gli esempi più solidi di L3 vengono da laboratori strumentati; per codice, robot e società il terreno, ammettono gli autori, è in parte empirico e in parte ancora da progettare: la distanza fra il ciclo di CAMEO e un agente che corregge da sé il proprio modello del web resta, per ora, un programma di ricerca.
Che cosa c’è in gioco
La tesi di chiusura è che il futuro degli agenti non stia in predittori più grandi ma in modelli che interiorizzano le leggi del loro mondo e le rivedono quando l’evidenza le smentisce. E aggiungono: le revisioni di leggi nella storia della scienza, da Newton a Maxwell, sono avvenute di solito su rappresentazioni simboliche, esplicite e modificabili, mentre le reti neurali tengono le loro regolarità implicite nei pesi. Va bene per prevedere e simulare, diventa un ostacolo quando il compito è cambiare la struttura del modello.
Che la tassonomia venga adottata o no, pone la domanda giusta a chi mette in produzione un agente: non se il suo modello del mondo produce scenari plausibili, ma se, quando la stazione è chiusa, se ne accorge, capisce perché e ridisegna la mappa senza rompere quello che già funzionava.
I commenti sono riservati agli iscritti.
Accedi per commentare