
Nel novembre del 2020, ai giudici della quattordicesima edizione di CASP — la gara internazionale in cui i gruppi di ricerca provano a predire la forma tridimensionale delle proteine — arriva un risultato che non erano abituati a vedere. Un sistema chiamato AlphaFold 2, del laboratorio DeepMind, predice molte strutture con un’accuratezza vicina a quella dei metodi sperimentali, che di solito richiedono mesi di lavoro in laboratorio. Per un problema rimasto aperto per mezzo secolo, è uno spartiacque.
Il lavoro viene poi descritto in dettaglio su Nature nel 2021. Vale la pena capire cosa fa AlphaFold 2 e, soprattutto, come lo fa: perché la sua idea centrale — sfruttare un segnale che l’evoluzione ha lasciato scritto nei dati — è una delle più eleganti che il machine learning abbia messo al lavoro su un problema scientifico.
Dalla collana alla forma
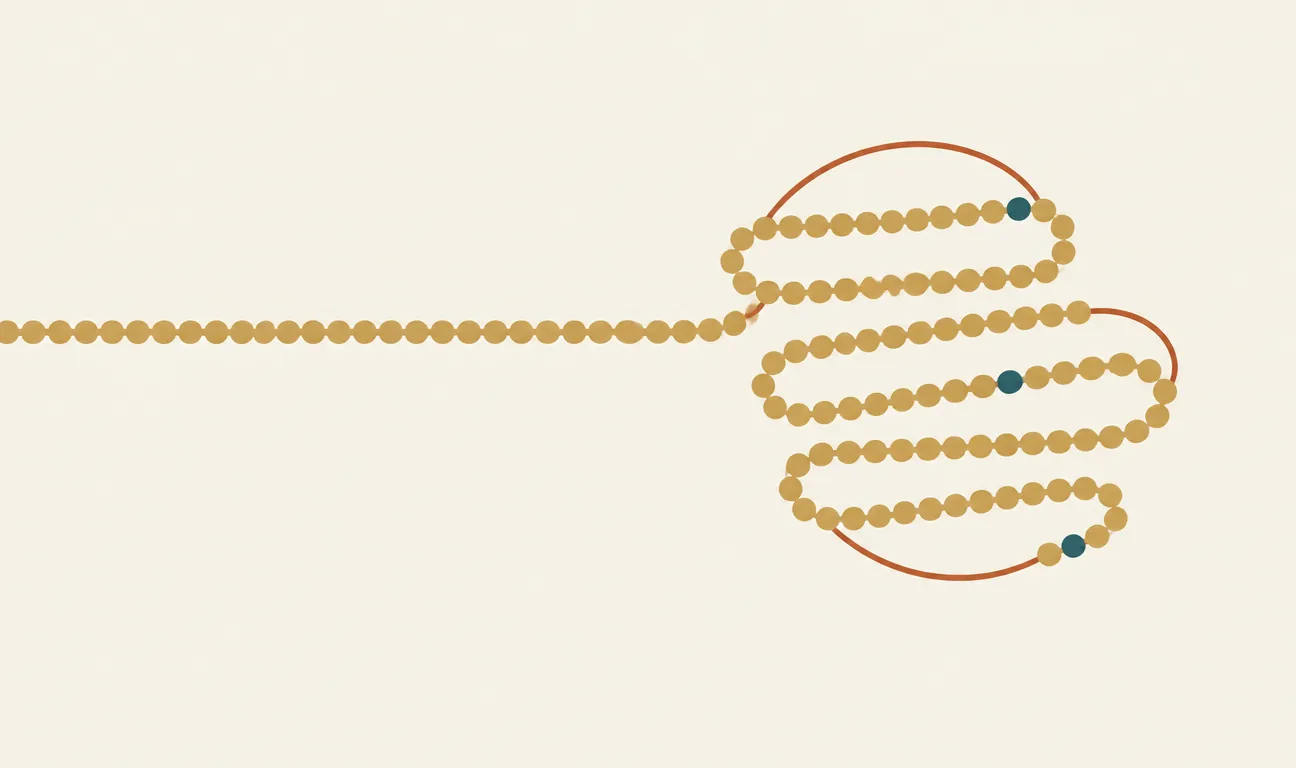
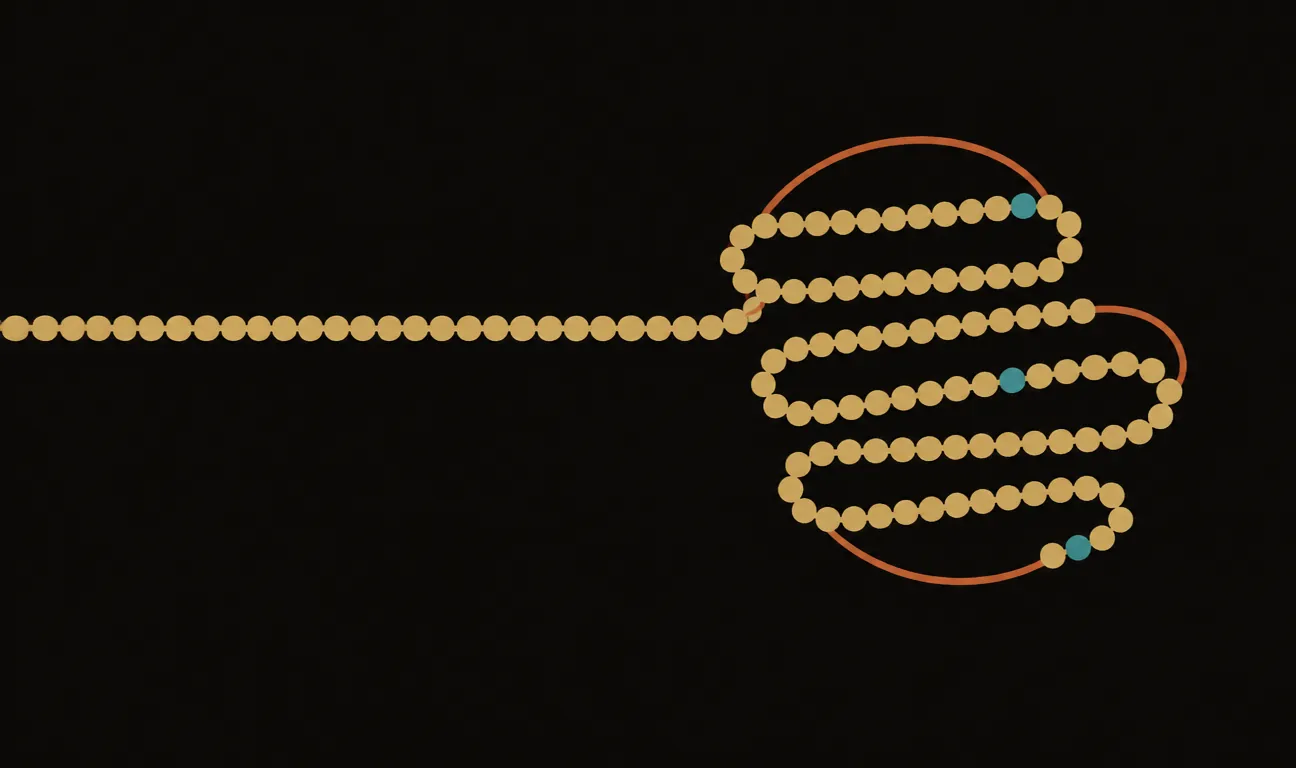
Una proteina è, alla sua origine, una lunga catena di amminoacidi: venti «mattoncini» diversi, agganciati uno dietro l’altro secondo un ordine preciso. Questa sequenza è un’informazione monodimensionale, come una collana di perline. Ma appena esiste, la catena si ripiega su se stessa e assume una forma tridimensionale specifica — e da quella forma dipende tutto ciò che la proteina sa fare: catalizzare una reazione, trasportare ossigeno, agganciare un farmaco.
Il legame tra sequenza e forma è noto da tempo: l’ordine degli amminoacidi determina il ripiegamento. Il guaio è passare dall’uno all’altra. Il numero di forme che una catena potrebbe teoricamente assumere è astronomico, eppure in natura la proteina si ripiega sempre nella stessa, in una frazione di secondo. Devono esistere vincoli fortissimi che restringono le possibilità — ma scriverli a mano, con la fisica e la chimica note, si era rivelato al di là delle nostre forze.
L’analogia utile è quella di una lunga collana di perline magnetiche che, ogni volta che la lasci cadere, si annoda esattamente nello stesso modo. Prevedere quel nodo a partire dal solo ordine delle perline è il problema. E non è accademico: determinare una struttura in laboratorio, con tecniche come la cristallografia a raggi X, è lento e costoso, mentre di proteine da studiare — per capire una malattia, progettare un farmaco — ce ne sono milioni.
Il segnale nascosto nell’evoluzione
La mossa decisiva di AlphaFold non parte dalla fisica, ma dalla storia. Data una proteina da predire, il sistema cerca prima tutte le proteine imparentate nelle altre specie viventi e le allinea in colonna, una sotto l’altra. Questo «allineamento multiplo di sequenze» (in sigla MSA) è una miniera di indizi.
Il ragionamento è questo: se due posizioni lungo la catena, nel corso di milioni di anni di evoluzione, tendono a cambiare in coppia — quando muta l’una, muta anche l’altra per compensare — è un segnale forte che quei due punti si toccano nella forma ripiegata. Sono vicini nello spazio, quindi si vincolano a vicenda. La co-evoluzione, letta su migliaia di specie, disegna una mappa di quali parti della catena stanno accanto a quali altre.
È come dedurre chi è seduto vicino a chi a un lungo banchetto, guardando anni di foto di famiglia: due parenti che cambiano taglio di capelli sempre insieme, di anno in anno, con ogni probabilità stanno allo stesso tavolo. AlphaFold trasforma questo intuito in matematica.
Evoformer e modulo di struttura
Il sistema ha due parti principali. La prima è chiamata Evoformer: una pila di blocchi di attenzione che raffinano insieme due rappresentazioni. Una descrive la famiglia evolutiva (l’MSA), l’altra descrive le coppie di posizioni — chi sta vicino a chi. L’informazione scorre avanti e indietro tra le due: quello che si scopre sulle coppie aggiorna la lettura dell’MSA, e viceversa, per molti passaggi.
La seconda parte è il modulo di struttura: prende le rappresentazioni raffinate e produce le coordinate tridimensionali vere e proprie, ragionando direttamente nello spazio anziché su una griglia astratta. Il tutto è addestrato dall’inizio alla fine: si entra con sequenza e MSA, si esce con la geometria, e l’errore misurato sulla forma finale corregge l’intera catena.
Dalla sequenza di amminoacidi si costruisce l’allineamento con le proteine imparentate (MSA); l’Evoformer ne raffina la lettura scoprendo quali posizioni si toccano; il modulo di struttura traduce quelle relazioni in coordinate tridimensionali.
A questo si aggiungono due accorgimenti importanti. Il primo è il recycling: l’output viene reimmesso in ingresso più volte, così la rete rilegge la propria bozza e la corregge a ogni giro, come si fa rileggendo un testo. Il secondo è un punteggio di confidenza per ogni singolo amminoacido, che dice dove fidarsi della predizione e dove no: un dettaglio decisivo per usare i risultati in modo responsabile, invece di prendere ogni struttura per oro colato.
Duecento milioni di strutture
DeepMind, insieme all’istituto europeo di bioinformatica EMBL-EBI, ha usato AlphaFold per costruire una banca dati pubblica: prima l’intero proteoma umano, poi circa duecento milioni di strutture, di fatto quasi tutte le proteine catalogate finora. Gratuita e aperta. Per la biologia strutturale è un cambio di ritmo quotidiano: un modello di partenza in pochi secondi, dove prima servivano mesi o anni.
Conviene però essere onesti sui limiti. AlphaFold predice una struttura statica, non il movimento di una proteina né come essa cambia forma quando si lega a un’altra molecola. Le regioni «disordinate», che una forma fissa non ce l’hanno, ricevono correttamente una confidenza bassa. E il sistema, da solo, non modella la maggior parte dei complessi tra proteine diverse né l’effetto preciso di una mutazione sulla stabilità. È uno strumento di partenza potentissimo, non la fine della biologia sperimentale.
La misura di quanto lontano sia arrivato l’ha data, nel 2024, il premio Nobel per la chimica assegnato a John Jumper e Demis Hassabis, insieme a David Baker per il lavoro complementare sulla progettazione di nuove proteine.
Il paper e chi l’ha scritto
L’articolo si intitola Highly accurate protein structure prediction with AlphaFold, firmato da John Jumper e colleghi di DeepMind, pubblicato su Nature nel luglio del 2021. La banca dati delle strutture predette, realizzata con EMBL-EBI, è consultabile liberamente all’indirizzo alphafold.ebi.ac.uk, e il codice del sistema è stato rilasciato pubblicamente.
Perché ti riguarda, anche se non toccherai mai una proteina? Perché AlphaFold è l’esempio più limpido di cosa succede quando un’architettura di apprendimento ben scelta incontra un problema in cui la natura ha lasciato un segnale — l’evoluzione — che a mano non riuscivamo a leggere. Ed è anche un modello di rilascio responsabile: il punteggio di confidenza che dichiara i propri limiti, la banca dati aperta a tutti. Due lezioni che valgono ben oltre la biologia, per chiunque costruisca strumenti su cui altre persone finiranno per contare davvero.
I commenti sono riservati agli iscritti.
Accedi per commentare