
Nell’agosto del 2022 vengono resi pubblici i pesi di un modello chiamato Stable Diffusion. Non è la prima intelligenza artificiale capace di generare immagini a partire da una frase: pochi mesi prima OpenAI aveva mostrato DALL·E 2 e Google i suoi Imagen e Parti. È però la prima che chiunque può scaricare e far girare su una scheda grafica da videogiochi, in casa propria. Nel giro di settimane nascono interfacce, plugin, comunità intere. La differenza non sta in un’immagine più bella: sta in un’idea tecnica che rende il calcolo abbastanza leggero da uscire dai data center.
Il prezzo dei pixel, il variational autoencoder come archivista e la ricetta in quattro mosse sono nel libro.
Quell’idea ha un nome: latent diffusion, diffusione nello spazio latente. È descritta in un articolo del 2022 firmato dal gruppo CompVis di Monaco, e Stable Diffusion ne è l’incarnazione più nota. Vale la pena capirla, perché spiega non solo come nasce un’immagine sintetica, ma anche perché è diventata una cosa alla portata di tutti.
Partire dal rumore e togliere disturbo
Un modello di diffusione impara a fare una cosa apparentemente banale: ripulire un’immagine dal rumore. Durante l’addestramento si prende una foto e le si aggiunge disturbo casuale, un po’ alla volta, finché non resta che una nebbia grigia priva di forma. Il modello osserva questi passaggi e impara a stimare, a ogni tappa, quale rumore è stato aggiunto e come toglierlo.
Al momento di generare si parte proprio dalla nebbia: puro rumore casuale. Il modello lo ripulisce passo dopo passo, e a ogni passo l’immagine diventa un po’ più nitida, finché dal caos emerge una scena coerente. È come guardare una Polaroid che si sviluppa, con la differenza che qui sotto non c’era nessuna fotografia: la costruisce il modello, tirandola fuori dal rumore un dettaglio alla volta.
Il problema è il costo. Se ogni passo di pulizia lavora sui pixel di un’immagine da 512×512, il modello deve manipolare quasi ottocentomila numeri a ogni tappa, e le tappe sono decine. Moltiplicato per milioni di immagini in addestramento, il conto in ore-GPU diventa proibitivo. Prima del 2022 la generazione ad alta risoluzione era di fatto un lusso da grandi laboratori.
Comprimere prima, diffondere dopo
L’intuizione di latent diffusion è semplice da enunciare: non serve fare tutto quel lavoro sui pixel. Gran parte di un’immagine è ridondante — vaste zone di cielo uniforme, texture ripetute, sfumature prevedibili. Quello che conta davvero, il contenuto, si può riassumere in molto meno spazio.
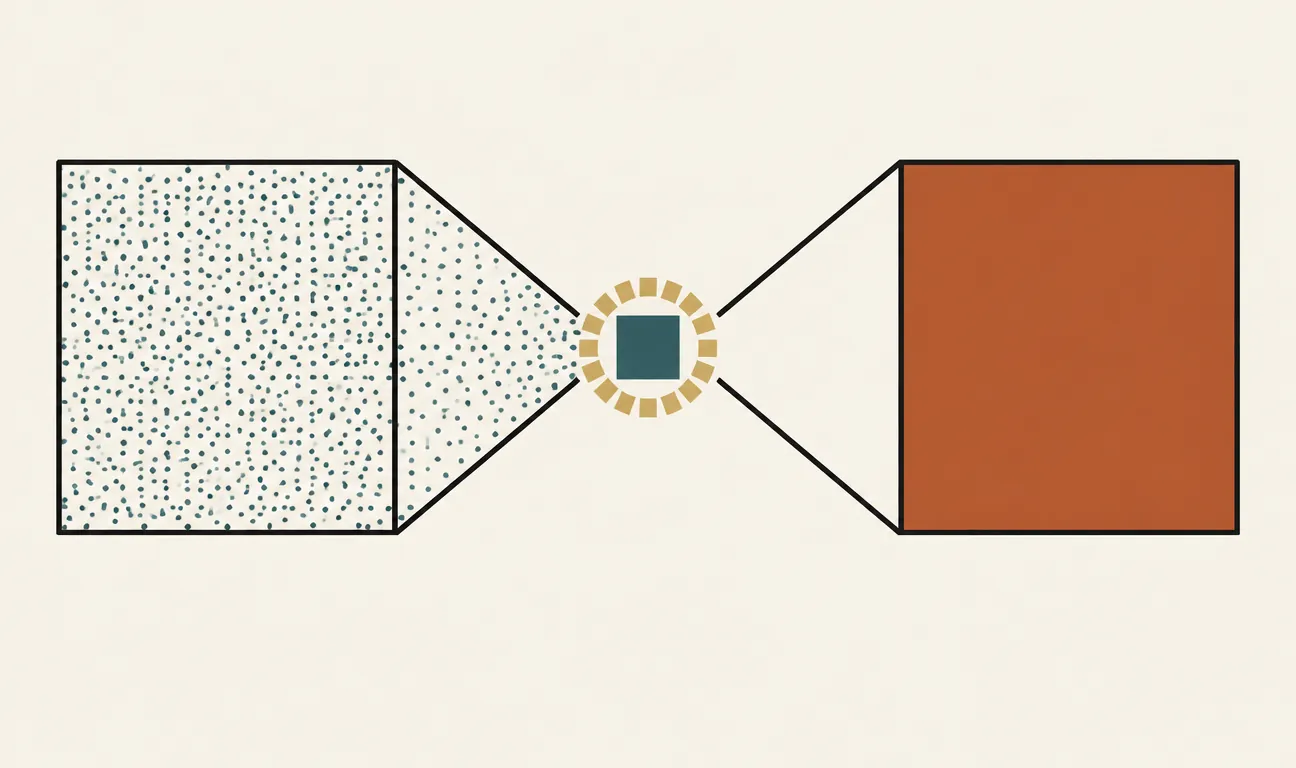
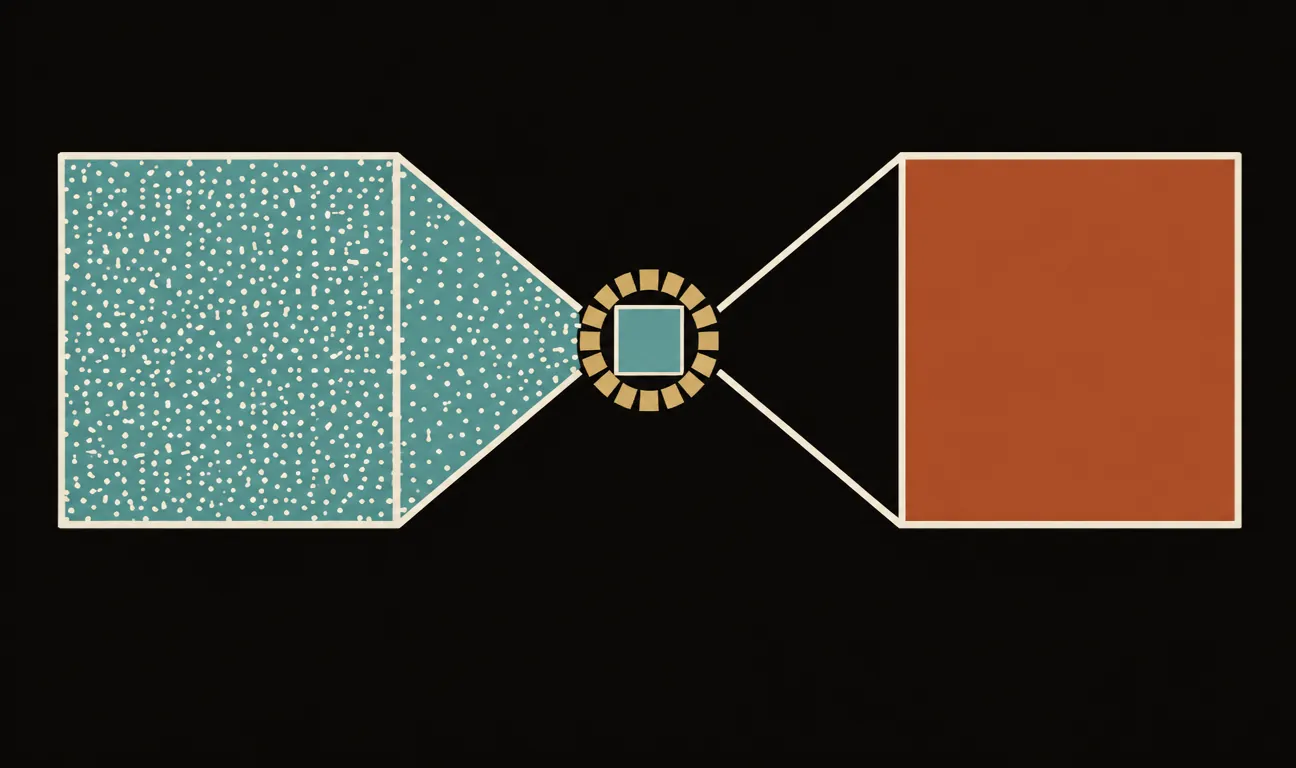
Il modello usa allora un secondo componente, un autoencoder, addestrato a fare da traduttore nei due sensi. Un encoder comprime l’immagine in una griglia molto più piccola — lo spazio «latente» — e un decoder sa ricostruire l’immagine a partire da quella griglia. In Stable Diffusion la compressione riduce ciascun lato di un fattore otto: un’immagine 512×512 diventa una griglia latente 64×64. Sono sessantaquattro volte meno posizioni da trattare.
A questo punto la diffusione — il lento lavoro di aggiunta e rimozione del rumore — non avviene più sui pixel, ma su quella griglia latente compatta. Si genera una descrizione latente ripulendo il rumore, e solo alla fine il decoder la traduce in un’immagine vera e propria. È come progettare una casa lavorando sulla pianta in scala invece che spostando mattoni veri: si ragiona sulla struttura, non sui materiali, e si costruisce soltanto alla fine.
La diffusione classica ripulisce il rumore direttamente sui pixel; nel latent diffusion l’immagine viene prima compressa dall’encoder in una griglia molto più piccola, tutto il lavoro di denoising avviene lì, e solo alla fine il decoder espande il risultato in immagine.
La diffusione non lavora più sui pixel, ma su una miniatura di significato che il decoder saprà espandere in immagine.
Come si aggancia una frase all’immagine
Resta la domanda centrale: come fa il modello a sapere che deve disegnare «un gatto astronauta» e non altro? Qui entra un meccanismo di attenzione incrociata (cross-attention). La frase viene prima trasformata in numeri da un codificatore di testo — in Stable Diffusion è quello di CLIP, un modello che aveva già imparato ad allineare testo e immagini — e questi numeri vengono iniettati nella rete che ripulisce il rumore.
A ogni passo, mentre decide come togliere disturbo da una certa zona della griglia latente, il modello «guarda» le parole della frase e si lascia guidare da quelle più pertinenti a quella zona. È il motivo per cui cambiare una sola parola nel prompt può spostare tutta la scena: non esiste un archivio di immagini prefabbricate da cui pescare, esiste una rete che a ogni passo negozia tra il rumore che sta ripulendo e il testo che deve rispettare.
Perché il peso conta
Il risultato pratico di questa architettura è che Stable Diffusion, addestrato dal gruppo CompVis insieme a Stability AI, Runway e al dataset aperto LAION, può generare un’immagine su una scheda grafica di fascia consumer, non su un cluster. E i pesi sono stati rilasciati apertamente, scaricabili da chiunque.
Questo ha avuto conseguenze che vanno oltre la tecnica. Da un lato un’ondata di strumenti: adattamenti su stili specifici, integrazione nei software di grafica, ricerca accademica che finalmente poteva partire da una base concreta invece che da un servizio chiuso. Dall’altro le questioni aperte che oggi conosciamo bene — diritti d’autore sui dati di addestramento, immagini ingannevoli, contenuti problematici — diventate urgenti proprio perché la tecnologia era, per la prima volta, nelle mani di tutti.
Vale la pena tenere separati i due piani. Il contributo tecnico dell’articolo è preciso e circoscritto: spostare la diffusione dallo spazio dei pixel a uno spazio latente compresso, senza perdere qualità visibile. Tutto il resto — l’esplosione di strumenti, i dibattiti legali, l’uso improprio — è la conseguenza sociale di aver reso quel calcolo economico. Capire con chiarezza la prima cosa aiuta a ragionare con più lucidità sulla seconda.
Il paper e chi l’ha scritto
L’articolo si intitola High-Resolution Image Synthesis with Latent Diffusion Models, firmato da Robin Rombach, Andreas Blattmann, Dominik Lorenz, Patrick Esser e Björn Ommer, del gruppo Machine Vision & Learning (CompVis) dell’Università di Monaco. È stato presentato a CVPR 2022 ed è disponibile su arXiv con identificativo 2112.10752. Stable Diffusion, il modello addestrato che ne mette in pratica le idee, è un progetto successivo che coinvolge CompVis, Stability AI, Runway e la comunità LAION per i dati.
Se oggi usi un generatore di immagini — dentro un’app di fotoritocco, un editor di presentazioni o un servizio online — è molto probabile che sotto ci sia una qualche forma di diffusione latente. Sapere che quella «magia» è, in fondo, un togliere rumore da una miniatura compressa non toglie nulla al risultato: aiuta a capire perché certi dettagli fini vengono male, perché il testo dentro le immagini spesso è illeggibile, e perché la stessa idea si è estesa così in fretta anche al video e all’audio. Sono tutti casi in cui si è imparato a diffondere in uno spazio compatto, invece che sui dati grezzi.
I commenti sono riservati agli iscritti.
Accedi per commentare