
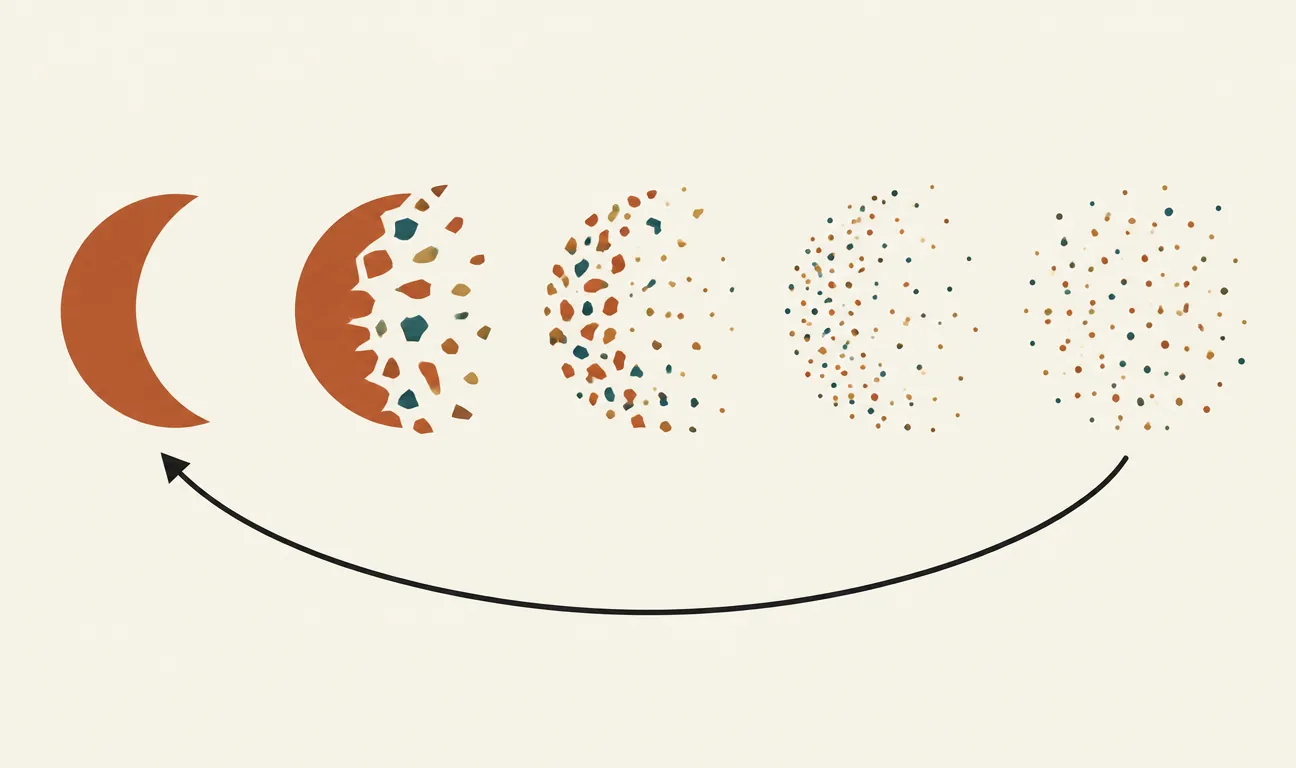
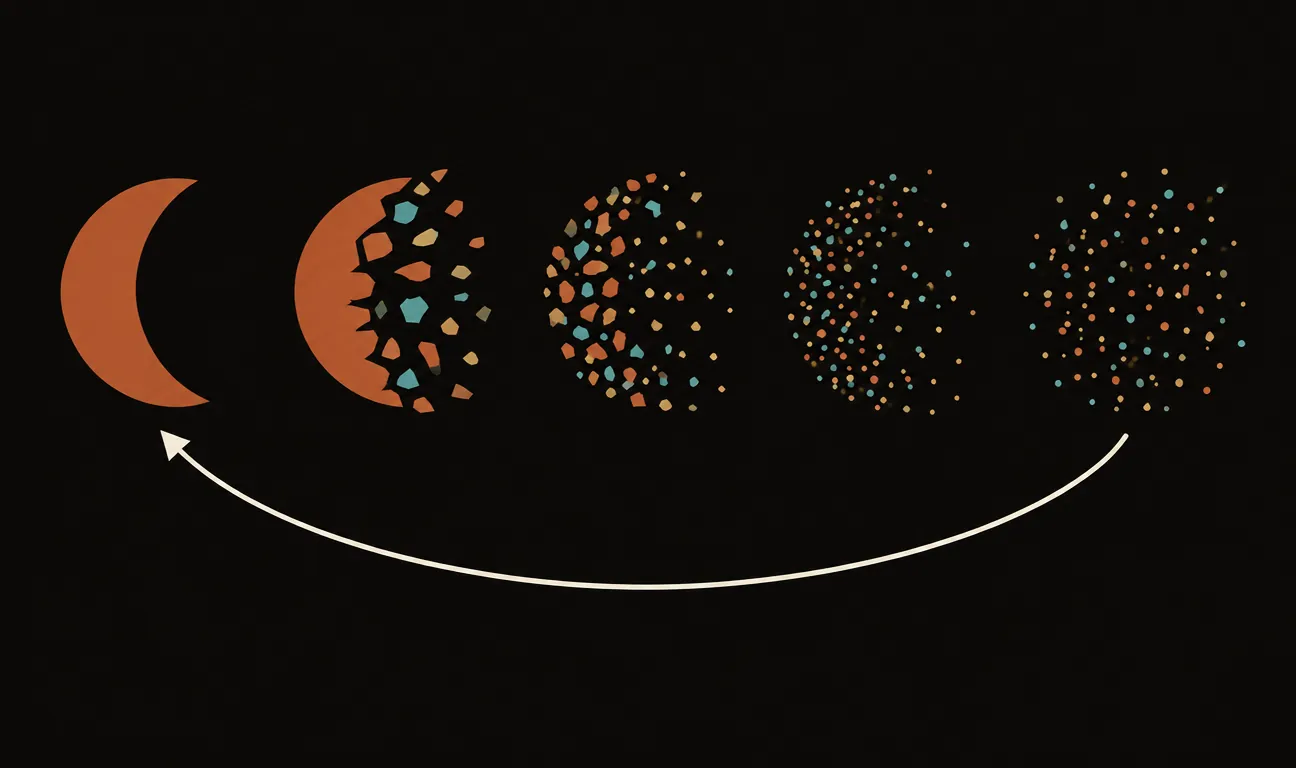
Prendi una fotografia nitida. Aggiungici un velo di disturbo casuale, come la grana di una vecchia pellicola. Fallo di nuovo. E ancora, mille volte. A un certo punto della foto non resta nulla: solo neve televisiva, rumore puro, indistinguibile da qualsiasi altra immagine trattata allo stesso modo. Fin qui è distruzione, e distruggere è facile.
L’andata che rovina con metodo, il ritorno che indovina il disturbo e il viaggio dal rumore all’immagine: nel libro.
Leggi «Rumore e ritorno: come funziona la diffusione» nel libro →
La domanda del paper Denoising Diffusion Probabilistic Models — Ho, Jain e Abbeel, Berkeley, 2020 — è l’inverso: e se addestrassimo una rete neurale a mandare indietro quel film, un fotogramma alla volta? Se sa togliere un pochino di rumore a ogni passo, allora può partire da neve pura e, denoise dopo denoise, far emergere un’immagine che non è mai esistita. Generare, insomma, come processo di restauro.
Mille piccoli passi verso il rumore
La prima metà del meccanismo si chiama processo diretto (forward), e non richiede alcun apprendimento: è una ricetta fissa. A ogni passo si prende l’immagine e le si somma un po’ di rumore gaussiano, secondo una tabella di intensità decisa in anticipo. Dopo un numero sufficiente di passi — nel paper, mille — il segnale originale è completamente sepolto e ciò che resta è, con ottima approssimazione, rumore gaussiano standard.
È come una goccia d’inchiostro in un bicchiere d’acqua. All’inizio è una macchia netta; poi diffonde, si sfilaccia, e dopo un po’ l’acqua è uniformemente grigia. Nessuno, guardando il bicchiere finale, saprebbe dire dove era caduta la goccia. Il processo diretto costruisce apposta questa amnesia, in modo graduale e controllato.
L’intuizione: imparare a tornare indietro
Il processo inverso (reverse) è dove entra in gioco la rete neurale. Se il forward smonta l’immagine di un passo, l’inverso deve rimontarla di un passo: dato un fotogramma un po’ rumoroso, produrne uno un po’ meno rumoroso. Ripetendo questa operazione mille volte a partire dal rumore puro, si arriva a un’immagine pulita e nuova di zecca.
Il pensiero da tenere a mente è questo: nessun singolo passo è difficile. Non chiediamo alla rete di inventare un capolavoro dal nulla in un colpo solo. Le chiediamo un compito modesto e ripetibile — «togli un filo di grana» — e lasciamo che sia la lunghezza della catena a fare il lavoro pesante. Un restauratore non ripulisce un affresco con una passata: lavora a strati sottilissimi, ognuno banale, ma cento strati rivelano il dipinto.
Il forward (in alto) è una ricetta fissa che distrugge l’immagine in rumore. Il reverse (in basso) è la rete addestrata che ripercorre la catena all’indietro, generando un’immagine nuova a partire dalla neve.
Il trucco: prevedi il rumore, non l’immagine
Qui sta il contributo tecnico che ha reso il metodo pratico. Si potrebbe chiedere alla rete di prevedere direttamente l’immagine pulita, o la media del passo precedente. Gli autori mostrano che conviene riformulare il compito: fai prevedere alla rete il rumore che è stato aggiunto. Conosci l’immagine pulita di partenza, sai quale rumore hai sommato, quindi hai la risposta giusta gratis; alleni la rete a indovinare quel rumore con un banale errore quadratico medio tra rumore vero e rumore previsto.
È la differenza tra dire a uno scultore «scolpisci un cavallo» e dirgli «ecco esattamente quali scaglie di marmo togliere». Il secondo compito è molto più concreto e stabile da apprendere. E c’è un bonus di comodità: grazie alla struttura del processo, si può saltare direttamente a un passo qualsiasi della catena senza percorrerla tutta, generando esempi di addestramento a caso su mille livelli di rumore diversi. Ogni immagine del dataset diventa migliaia di piccoli esercizi.
La rete che fa il lavoro è una U-Net: un’architettura a clessidra, con connessioni che scavalcano il collo di bottiglia, nata per la segmentazione medica e qui perfetta perché l’ingresso e l’uscita hanno la stessa forma dell’immagine.
Perché funziona, e perché è lento
Il risultato pratico del 2020 fu che questi campioni erano nitidi e vari quanto — o più di — quelli delle reti generative avversarie (GAN) che dominavano fino ad allora, ma senza la loro proverbiale instabilità di addestramento. Su un banco di prova classico come CIFAR-10, il modello raggiunse una qualità allo stato dell’arte per i generatori non condizionati (un punteggio FID di 3,17, dove più basso è meglio).
Il prezzo è il tempo. Generare una singola immagine richiede di attraversare l’intera catena inversa: se i passi sono mille, sono mille passaggi attraverso la rete per una foto. Le GAN sputano un’immagine in un colpo solo; la diffusione la costruisce con pazienza monastica. Questo è il grande limite dichiarato del paper, ed è onesto averlo messo in chiaro.
Vale la pena notare cosa si guadagna in cambio di quella lentezza. L’addestramento delle GAN è notoriamente capriccioso: due reti che si sfidano possono collassare, oscillare, dimenticare intere porzioni di ciò che dovrebbero saper generare. La diffusione, invece, allena una sola rete su un obiettivo semplice e stabile — indovina il rumore — che si comporta bene e scala con i dati senza sorprese. In pratica si baratta un addestramento fragile ma veloce con uno robusto ma lento. Per chi deve mettere un sistema in produzione, è spesso un ottimo affare: un modello che si allena in modo prevedibile vale più di uno che campiona in fretta ma di cui non ti fidi.
L’eredità
Quel limite di velocità è diventato il programma di ricerca degli anni successivi, e in buona parte è stato risolto: metodi di campionamento più furbi hanno ridotto i passi da mille a poche decine, e spostare la diffusione in uno spazio compresso (latente) invece che sui pixel grezzi ha reso l’intera faccenda economica. È la strada che porta dritta a Stable Diffusion e ai generatori testo-immagine che chiunque usa oggi. Quando scrivi un prompt e guardi un’immagine materializzarsi passo dopo passo, stai osservando, accelerata, la catena inversa di questo paper.
Il paper e chi l’ha scritto
Il lavoro originale è Denoising Diffusion Probabilistic Models di Jonathan Ho, Ajay Jain e Pieter Abbeel (UC Berkeley), presentato a NeurIPS 2020 e disponibile su arXiv con identificativo 2006.11239. Se vuoi capire da dove viene l’intera ondata dell’AI generativa visiva, è il punto giusto da cui partire: la matematica del processo inverso è impegnativa, ma l’idea centrale — imparare a restaurare invece che a inventare — si tiene in una frase.
I commenti sono riservati agli iscritti.
Accedi per commentare