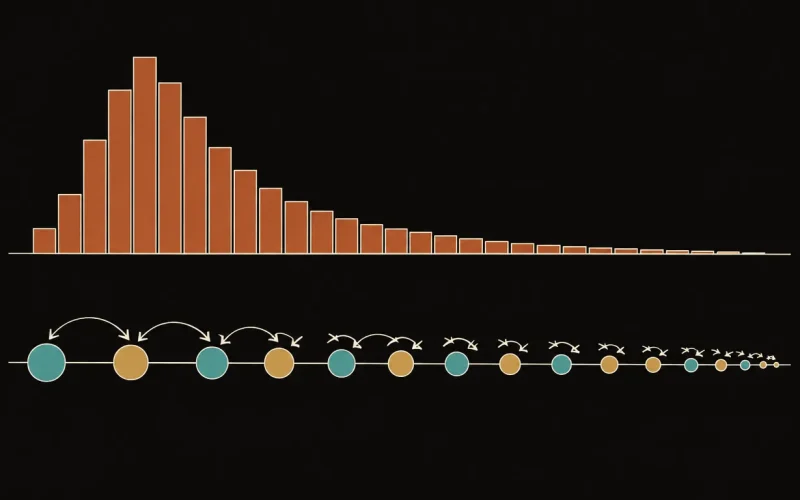
Dallo SGD agli spettri: la teoria dietro l’evoluzione dei pesi
Un gruppo di Caltech modella l'addestramento come un'equazione differenziale stocastica e mostra che i valori singolari dei pesi si comportano…
Un gruppo di Caltech modella l'addestramento come un'equazione differenziale stocastica e mostra che i valori singolari dei pesi si comportano…
Un agente di Google per la data science che non si ferma quando il codice gira, ma quando un giudice…

Un agente che affronta compiti lunghi affoga nel proprio contesto. Un paper di ottobre 2025 propone di rendere la potatura…

Il reinforcement learning premia di solito la risposta finale di un modello. Un gruppo tra Google, UC Davis e Princeton…

Gli agenti addestrati con reinforcement learning imparano per tentativi ed errori, senza fermarsi a capire perché hanno sbagliato. Un gruppo…

Nell'agosto e settembre 2025 tre ricercatori hanno intervistato venticinque esperti tra laboratori di frontiera e accademia sull'idea che l'AI possa…

Nell'RL per gli LLM si campiona un gruppo di risposte a un prompt e le si valuta. TPO separa due…

Da nove anni le parole di un prompt ricevono un numero di posizione fisso, 0, 1, 2, fino alla fine.…

Un gruppo di Stanford, NVIDIA e Berkeley riformula il contesto lungo come apprendimento continuo: invece di ricordare ogni token, il…

Rimuovere un oggetto da un video è la parte facile; togliere anche l'ombra e il riflesso che si lascia dietro…