Decomposizione bi-ortogonale: separare contenuto e posizione dentro un Vision Transformer
Le mappe di attenzione di un Vision Transformer dicono quali patch si guardano, non cosa si scambiano. Un gruppo di…
Le mappe di attenzione di un Vision Transformer dicono quali patch si guardano, non cosa si scambiano. Un gruppo di…
Un gruppo del MIT guidato da Kaiming He sposta la parte ripetitiva della generazione dal momento in cui si produce…

Da mesi si distribuiscono "skill" per gli agenti AI, schede di procedure che dovrebbero renderli più bravi. Un benchmark le…

Le reti ricorrenti sono efficienti ma dimenticano; i transformer ricordano tutto ma costano il quadrato. Un gruppo di Google propone…

François Fleuret aggiunge al decoder Transformer una variabile casuale latente, appresa senza supervisione con un autoencoder variazionale. Un ingranaggio in…

Un modello che comprime il passato in sintesi e vi presta attenzione, con una manopola per scegliere a inferenza quanto…

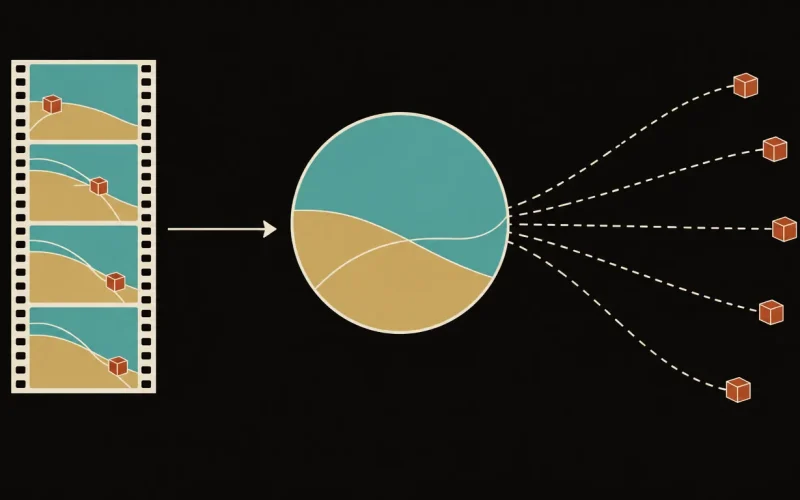
Un gruppo di Meta e New York University addestra un "modello del mondo" su oltre 900 ore di video, in…

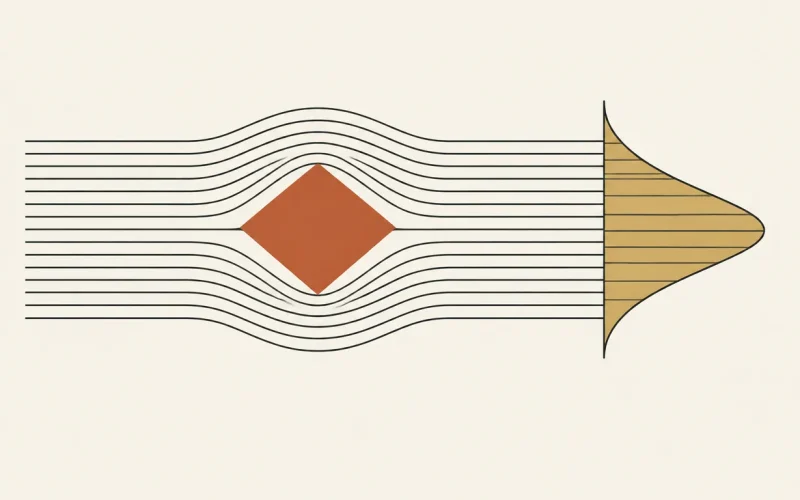
Tre ricercatori costruiscono "gallerie del vento" bayesiane, compiti dove la risposta esatta è nota in anticipo e la memorizzazione è…

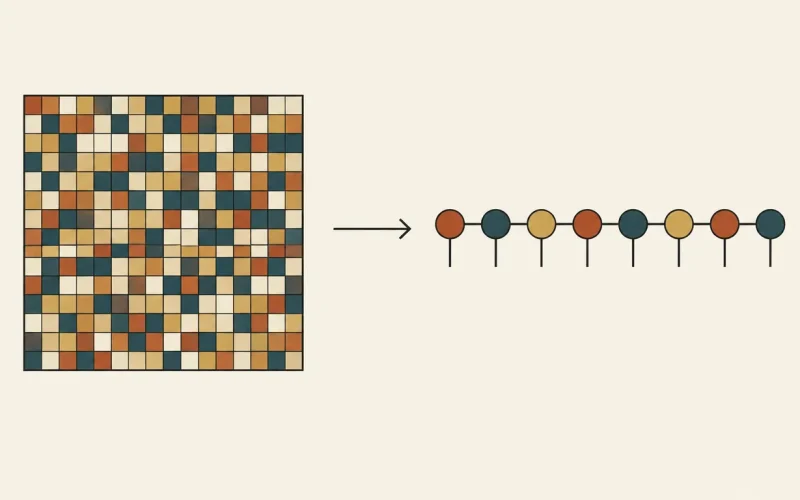
Un gruppo di fisici propone di rimpicciolire i modelli linguistici non tagliando neuroni, ma le correlazioni tra i loro pesi,…

Un commento di quattro pagine sostiene che il "collasso del ragionamento" misurato in uno studio molto discusso sia un artefatto…