
Immaginate una biblioteca con dieci milioni di libri, in cui ogni libro è collocato non per autore o argomento, ma in base al suo significato: due libri che parlano di cose simili stanno vicini sullo scaffale, due libri lontani per contenuto stanno agli antipodi dell’edificio. Ora entra un lettore con una domanda e chiede: «qual è il libro più vicino, per significato, a questa mia frase?». La risposta onesta richiederebbe di misurare la distanza dalla frase a tutti e dieci i milioni di libri, uno per uno, e tenere il minimo. Su un solo computer, per una sola domanda, sono frazioni di secondo che diventano un problema serio appena le domande arrivano a migliaia al minuto. Eppure un database vettoriale risponde in un paio di millisecondi. Il trucco non è andare più veloce a fare la stessa cosa: è smettere di controllarli tutti.
Il problema: la forza bruta non scala
Facciamo un passo indietro. Un modello di embedding trasforma un pezzo di testo in un vettore — una lista di numeri, tipicamente qualche centinaio o migliaio di dimensioni. La proprietà che rende utile tutto questo è che testi di significato simile finiscono in punti vicini di quello spazio. «Trovare il documento più pertinente a una domanda» diventa allora un problema geometrico preciso: trovare, tra milioni di punti, quello più vicino al punto della domanda. In gergo, nearest neighbor search.
La soluzione esatta è ovvia e si chiama forza bruta: calcola la distanza dalla domanda a ogni singolo vettore, ordina, prendi i primi. Il costo cresce linearmente con il numero di vettori — O(N) — e questo è esattamente il punto dolente. Con centomila vettori è istantaneo. Con dieci milioni, ripetuto per ogni domanda di ogni utente, diventa il collo di bottiglia di tutto il sistema. Serve un modo per rispondere senza guardare tutti i punti. E qui si accetta un compromesso che a prima vista sembra un tradimento.
Rinunciare all’esattezza (quasi senza accorgersene)
L’idea è passare dalla ricerca esatta alla ricerca approssimata — in inglese ANN, approximate nearest neighbor. Invece di garantire «ti do il punto più vicino in assoluto», il sistema promette «ti do quasi sempre uno dei punti più vicini, in un tempo enormemente minore». La qualità di questa promessa si misura con il recall: se i veri dieci più vicini sono dieci, e l’indice me ne restituisce nove tra i suoi dieci, il recall è del 90%.
Sembra una perdita grave e invece, nel contesto giusto, non lo è quasi mai. Ricordiamo a cosa serve tutto questo: recuperare documenti da dare in pasto a un modello linguistico. Se il decimo documento più pertinente viene sostituito dall’undicesimo, quasi identico per contenuto, la risposta finale non cambia. Gli embedding sono già un’approssimazione del significato; pretendere il vicino esatto in quello spazio approssimato è una precisione illusoria. Barattare un pugno di punti percentuali di recall per un sistema cento volte più veloce è, nella grande maggioranza dei casi, un ottimo affare.
Non serve trovare il punto matematicamente più vicino. Serve trovarne, molto in fretta, uno abbastanza vicino da essere indistinguibile ai fini della risposta.
Piccolo mondo: navigare invece di scandagliare
Come si trova un vicino senza guardarli tutti? La famiglia di indici oggi dominante — HNSW, di cui parleremo tra poco — parte da un’osservazione che viene dallo studio delle reti sociali. È l’idea dei «sei gradi di separazione»: in una rete sociale enorme puoi raggiungere una persona qualsiasi dall’altra parte del mondo con pochissimi passaggi, purché alcuni dei tuoi contatti abbiano legami a lungo raggio che scavalcano intere regioni. Sono grafi small world: prevalentemente locali, ma con qualche scorciatoia lunga.
Applichiamo l’idea ai vettori. Costruiamo un grafo in cui ogni punto è collegato ad alcuni dei suoi vicini. Per rispondere a una domanda partiamo da un nodo qualsiasi e usiamo una regola avida: guarda i vicini del nodo attuale, spostati su quello più vicino alla domanda, ripeti finché non riesci più a migliorare. È come attraversare una città chiedendo indicazioni: «il palazzo che cerco è in quella direzione?» e camminando sempre verso chi ti avvicina, senza mai possedere la mappa completa. Con i soli collegamenti locali però ci si muove a passettini. Servono le scorciatoie a lungo raggio per coprire subito grandi distanze — ed è precisamente ciò che HNSW organizza in modo sistematico.
Lo schema: la gerarchia di HNSW
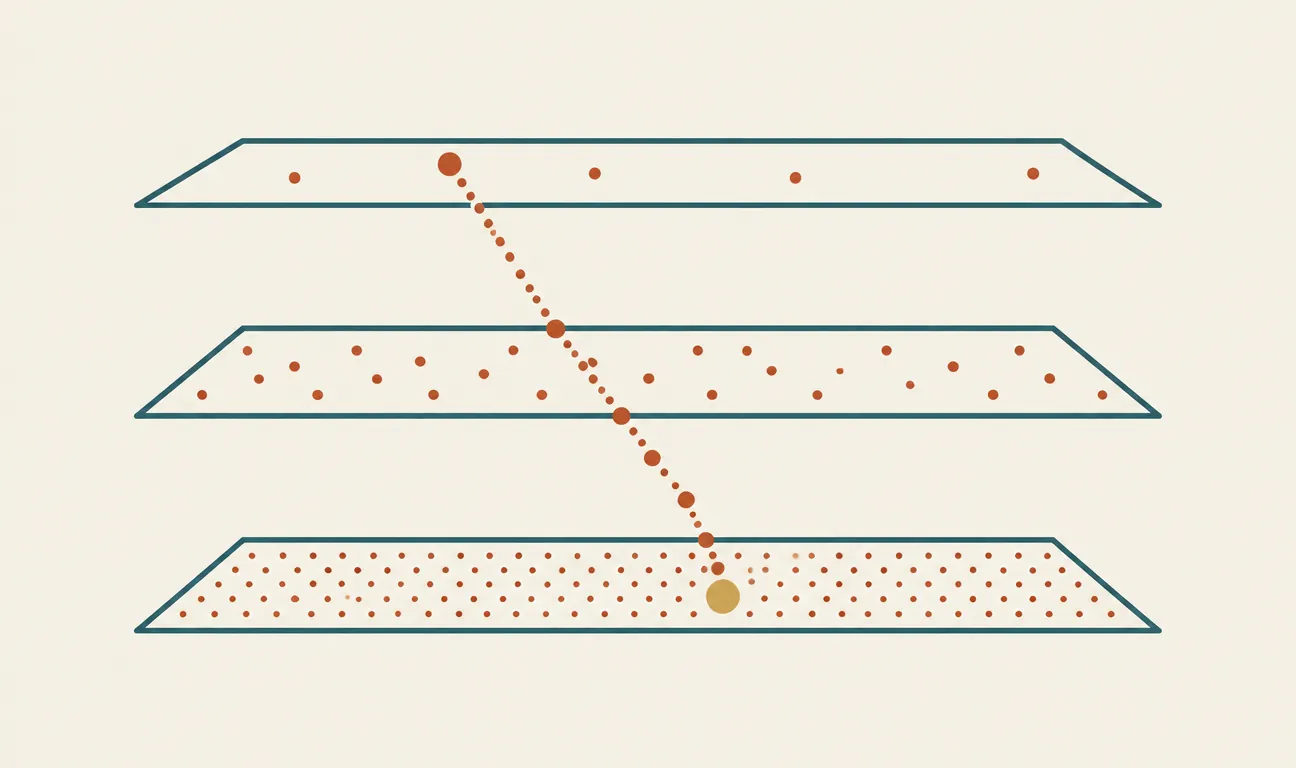
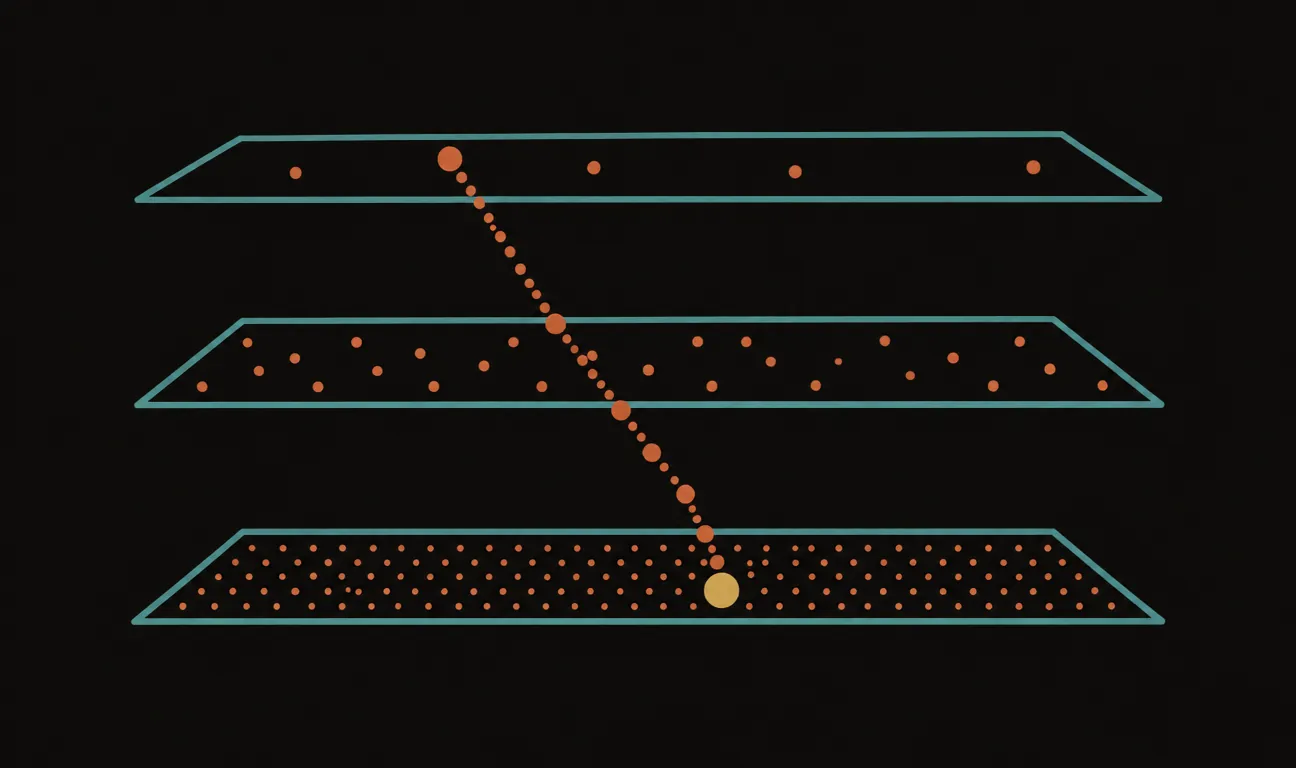
HNSW sta per Hierarchical Navigable Small World. La parola chiave è «hierarchical»: il grafo non è uno solo, sono più strati sovrapposti. In cima, pochi nodi con collegamenti lunghissimi. Scendendo, sempre più nodi con collegamenti sempre più corti e locali. La ricerca comincia in alto, copre grandi distanze a balzi, poi scende di strato in strato affinando la ricerca man mano che si avvicina alla meta.
HNSW impila più strati: in cima pochi nodi con collegamenti lunghi per coprire distanze in fretta, in basso molti nodi fitti per la precisione. La ricerca entra dall’alto, si avvicina a grandi balzi e scende affinando, come un aereo che perde quota mentre punta la pista.
I compromessi pratici (perché nessun indice è gratis)
HNSW è veloce e ha recall alto, ma va pagato in altre valute. La prima è la memoria: il grafo dei collegamenti va tenuto tutto in RAM per essere veloce, e su decine di milioni di vettori diventa un costo di infrastruttura concreto. La seconda è la manutenzione: aggiungere vettori è agevole, ma cancellarli e aggiornare il grafo in modo pulito è notoriamente scomodo, tanto che molti sistemi accumulano cancellazioni e periodicamente ricostruiscono l’indice da capo.
C’è poi una manopola che ogni sistema espone e che conviene conoscere: quanto a lungo lasciar esplorare la ricerca prima di fermarsi. Alzarla significa visitare più nodi, quindi recall più alto ma risposte più lente; abbassarla, l’opposto. Non esiste il valore giusto in assoluto: dipende da quanto vi costa una risposta imperfetta rispetto a una lenta. Un’ultima insidia riguarda i filtri: spesso non si vuole «il più vicino in assoluto» ma «il più vicino tra i documenti in italiano, degli ultimi due anni». Combinare il filtro con la navigazione del grafo è un problema tecnico serio, e il modo in cui un database lo risolve è spesso ciò che distingue un prodotto maturo da un prototipo.
Cosa portarsi a casa
Il database vettoriale è il motore silenzioso sotto quasi ogni sistema RAG, ogni ricerca semantica, ogni funzione «trova cose simili a questa». Capire che al suo cuore c’è una rinuncia deliberata all’esattezza — barattata per una velocità altrimenti irraggiungibile — cambia il modo in cui lo si usa. Spiega perché una ricerca può, di rado, «mancare» un documento che c’era: non è un bug, è il recall che scende sotto il 100% per costruzione, e se il caso lo richiede la manopola dell’esplorazione va alzata. Spiega perché la RAM è la risorsa da tenere d’occhio più dello spazio su disco, perché i filtri complicano la vita all’indice, e perché aggiornare grandi indici non è banale. La prossima volta che un assistente vi restituisce in un battito di ciglia il paragrafo giusto tra milioni, saprete che non li ha guardati tutti: ha navigato un piccolo mondo di scorciatoie, ha sceso i suoi strati come un aereo verso la pista, e si è fermato appena abbastanza vicino da non fare differenza.
I commenti sono riservati agli iscritti.
Accedi per commentare