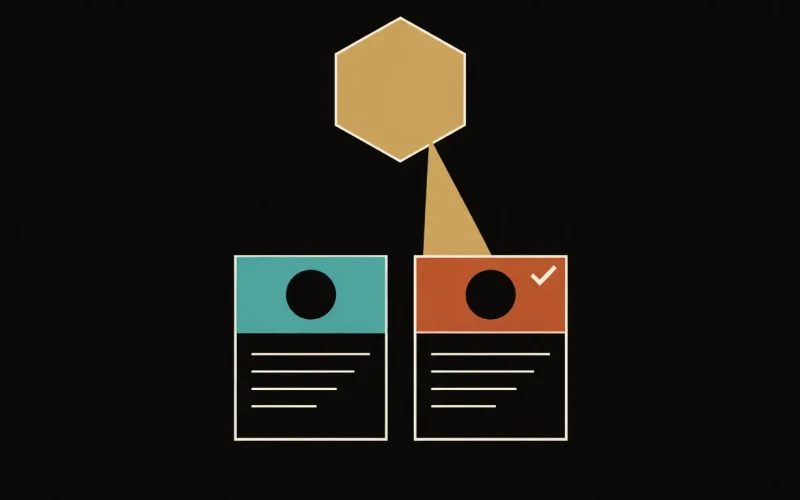
RLAIF (2024): feedback dall’AI invece che dall’uomo
Raccogliere le preferenze umane per allineare un modello linguistico è lento e costoso. Un paper di Google mostra che un…
Raccogliere le preferenze umane per allineare un modello linguistico è lento e costoso. Un paper di Google mostra che un…
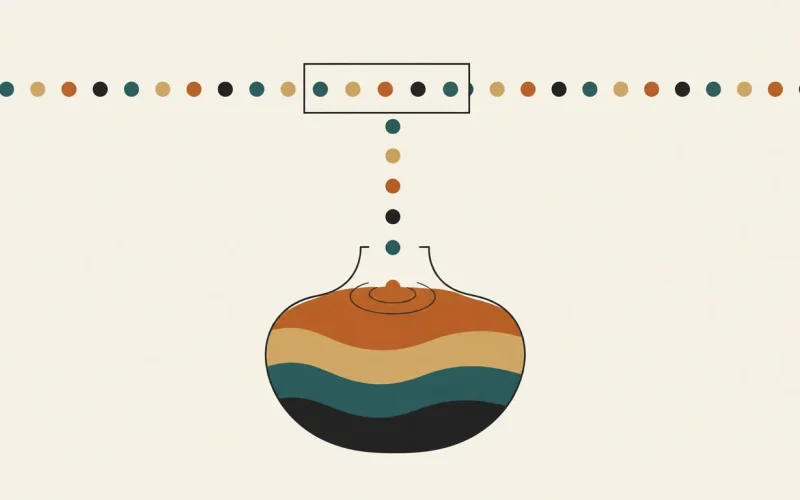
Prima di leggere anche una sola parola, ogni modello linguistico spezza il testo in token secondo un vocabolario fisso deciso…

Un transformer dimentica tutto ciò che esce dalla sua finestra di attenzione; una rete ricorrente comprime il passato in uno…

Nel 2023 un gruppo di ricercatori della Fudan University prova a mettere ordine nella parola più abusata dell'anno: "agente". Rileggiamo…

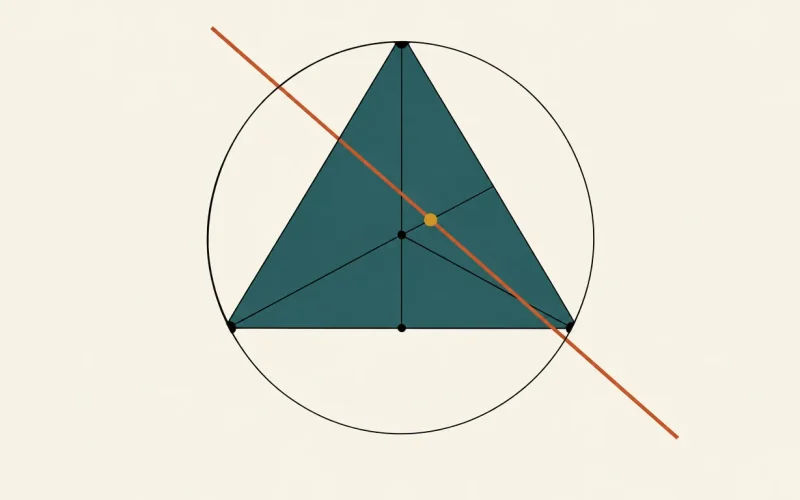
Molti problemi di geometria delle olimpiadi si sbloccano con un'unica idea, tracciare il punto o la linea giusta. AlphaGeometry unisce…

Nell'ottobre 2024 Meta presenta un modello che trasforma una frase in un video di sedici secondi. Il paper interessa meno…

Un lavoro di Google DeepMind del 2024 mostra che lasciar "ragionare" più a lungo un modello piccolo davanti a una…

Per anni abbiamo istruito i modelli con due o tre esempi nel prompt. Un lavoro di Google DeepMind del 2024…

Un modello linguistico può nascondere un comportamento dannoso che si attiva solo con un trigger preciso, e le tecniche standard…

DPO ha semplificato l'allineamento dei modelli linguistici, ma porta ancora con sé due pesi: un modello di riferimento da tenere…