
«Un’immagine vale 16×16 parole»: il titolo del paper che nell’ottobre 2020 ha introdotto il Vision Transformer non è una metafora, è la descrizione letterale del metodo. Un gruppo di ricercatori di Google Brain prese l’architettura transformer — nata per il linguaggio, dove macina sequenze di parole — e la applicò alle immagini quasi senza modifiche. Il trucco stava tutto nella preparazione dell’input: tagliare la fotografia in quadratini, metterli in fila e trattarli come se fossero le parole di una frase. Un’idea quasi sfacciata nella sua semplicità, che a molti sembrò destinata a fallire. Non fallì, e capire perché è uno dei modi migliori per capire la visione artificiale di oggi.
Il problema: i transformer mangiano sequenze, non griglie
Un transformer lavora su una sequenza di token: nel linguaggio, pezzi di parole trasformati in vettori. Il suo meccanismo centrale, la self-attention, confronta ogni token con tutti gli altri per decidere quali contano di più. Ma il costo di questo confronto cresce con il quadrato della lunghezza della sequenza — e qui le immagini creano un problema immediato. Una foto di 224×224 pixel contiene oltre 50.000 pixel: trattare ogni pixel come un token significherebbe miliardi di confronti per una singola immagine. Impraticabile.
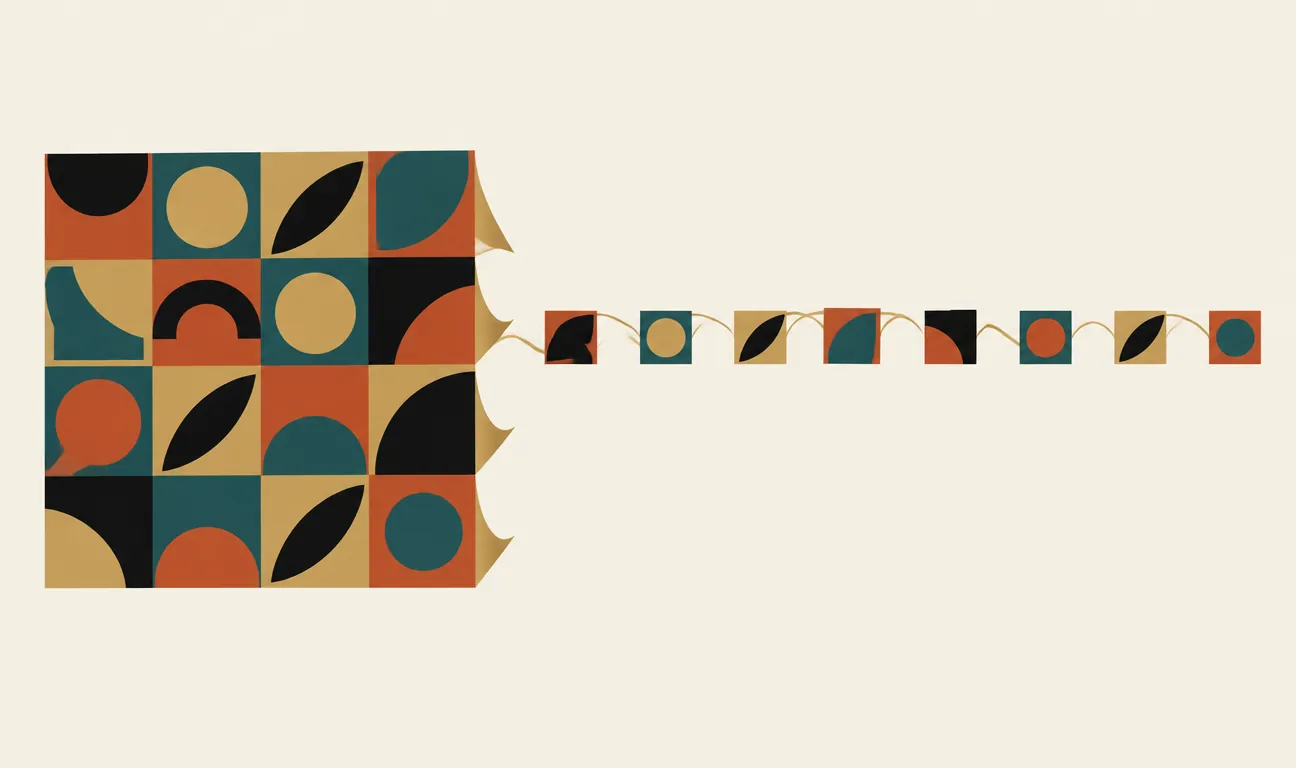
La soluzione del Vision Transformer (ViT) è cambiare la granularità: non pixel, ma patch. L’immagine viene divisa in quadratini di 16×16 pixel — per una foto di 224×224, sono 196 patch. Ogni patch viene «srotolata» in un vettore di numeri e proiettata linearmente in uno spazio di dimensione fissa: a quel punto è un token come un altro, indistinguibile per il transformer da quello di una parola. Da 50.000 elementi a 196: la sequenza torna a una lunghezza gestibile.
L’analogia più fedele è una cartolina tagliata a tessere di mosaico: invece di descrivere la scena granello per granello, descrivete ogni tessera con una scheda sintetica e poi ragionate sulle schede. Il contenuto fine di ogni tessera viene compresso, ma le relazioni tra le tessere — chi sta accanto a chi, che cosa si somiglia — restano tutte disponibili.
Il flusso del ViT: l’immagine viene divisa in patch, ogni patch diventa un token tramite una proiezione lineare, la sequenza (con un token CLS in testa e i position embedding) attraversa un transformer encoder e la classe si legge dal token CLS.
Due dettagli che fanno funzionare tutto
Il primo: la self-attention è indifferente all’ordine. Se mescolate i token di una frase, il transformer di per sé non se ne accorge — e per un’immagine sarebbe un disastro, perché la posizione delle patch è informazione essenziale. Il ViT risolve come nel linguaggio: a ogni token viene sommato un position embedding, un vettore appreso che codifica «tu sei la patch numero 37». È il numero stampato sul retro di ogni tessera del mosaico, che permette di ricostruire dove va.
Il secondo: alla sequenza viene aggiunto in testa un token speciale, chiamato [CLS], che non corrisponde a nessuna patch. Strato dopo strato, l’attention gli permette di raccogliere informazione da tutta l’immagine, e alla fine è dal suo stato che si legge la classificazione. Funziona come il relatore di un gruppo di lavoro: non porta contenuto proprio, ma ascolta tutti e alla fine riassume.
Che cosa perde rispetto a una CNN (e perché è interessante)
Per quasi un decennio la visione era stata dominio delle reti convoluzionali, che portano incorporate due assunzioni sulle immagini: i pixel vicini sono correlati (località), e un gatto è un gatto sia in alto a destra che in basso a sinistra (invarianza per traslazione). Sono i cosiddetti inductive bias: conoscenza pregressa cablata nell’architettura, che permette di imparare bene anche con dati relativamente pochi.
Il ViT butta via quasi tutto questo. La self-attention è globale fin dal primo strato: ogni patch può guardare ogni altra patch, senza privilegiare le vicine. È la differenza tra un lettore che scorre la pagina con una lente d’ingrandimento, riga per riga, e uno che vede l’intera pagina in un colpo solo: il secondo può cogliere relazioni a lunga distanza subito, ma deve imparare da zero anche le regolarità più ovvie — per esempio che, di solito, quello che conta per una patch sta nei suoi dintorni.
Il ViT non sa nulla delle immagini quando nasce. Con abbastanza dati, questo passa dall’essere il suo difetto all’essere il suo vantaggio.
La fame di dati, e come è stata domata
La conseguenza era prevedibile e il paper la documenta con onestà: addestrato solo su ImageNet (circa 1,3 milioni di immagini), il ViT perdeva dalle migliori reti convoluzionali. Le assunzioni che la CNN ha gratis, il transformer deve impararle dai dati — e per impararle gli servono molti dati. Pre-addestrato su JFT-300M, un dataset interno di Google con circa 300 milioni di immagini, il ViT superava lo stato dell’arte, con un costo di addestramento inferiore rispetto alle convoluzionali di pari livello.
Il messaggio sembrava scomodo: l’architettura funziona, ma solo per chi possiede centinaia di milioni di immagini. Nel giro di pochi mesi la comunità trovò contromisure. DeiT (Facebook AI, fine 2020) mostrò che con augmentation aggressive e la distillazione da una CNN insegnante si può addestrare un ViT competitivo con il solo ImageNet. In seguito, il pre-addestramento auto-supervisionato — da DINO al masked autoencoding, dove il modello impara ricostruendo patch nascoste — ha ridotto ulteriormente la dipendenza dalle etichette umane. La fame di dati non è sparita, ma è diventata fame di dati non annotati, che costano molto meno.
L’eredità: da esperimento a spina dorsale
A cinque anni di distanza, il ViT non è più un’alternativa esotica: è l’opzione di default per gran parte della visione ad alto livello. CLIP, il modello di OpenAI che allinea immagini e testo nello stesso spazio, usa un encoder ViT; lo stesso vale per il Segment Anything Model di Meta e per gli encoder visivi dei modelli multimodali che oggi «guardano» le immagini dentro i chatbot. La ragione è strategica, oltre che tecnica: usare la stessa architettura per testo e immagini rende naturale farle convivere nello stesso modello, con lo stesso hardware, le stesse ottimizzazioni, le stesse leggi di scala.
Le convoluzioni non sono morte — restano competitive dove i dati sono pochi, la risoluzione conta e il budget computazionale è stretto, come in molta visione embedded. Ma l’idea che serva un’architettura speciale per le immagini si è indebolita in modo che pochi avevano previsto.
Perché vi riguarda
Se lavorate con l’AI, il ViT vi riguarda anche se non addestrerete mai un modello di visione: ogni volta che caricate una foto in un assistente e questo la descrive, da qualche parte una griglia di patch sta diventando una sequenza di token. E c’è una lezione di metodo che vale oltre la vision: il ViT ha vinto non aggiungendo ingegneria specifica per le immagini, ma togliendola — sostituendo assunzioni cablate a mano con dati e scala. È lo stesso schema che si ripete in tutta la storia recente del deep learning, e conoscerlo aiuta a leggere le prossime «sorprese» prima che arrivino.
Il paper originale
Il Vision Transformer è stato presentato in An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale di Alexey Dosovitskiy e colleghi (Google Research, Brain Team), pubblicato a ICLR 2021 e disponibile su arXiv: arxiv.org/abs/2010.11929. Per l’addestramento efficiente senza dataset giganti, il riferimento è il paper di DeiT: Training data-efficient image transformers & distillation through attention (Touvron et al., arxiv.org/abs/2012.12877).
I commenti sono riservati agli iscritti.
Accedi per commentare