
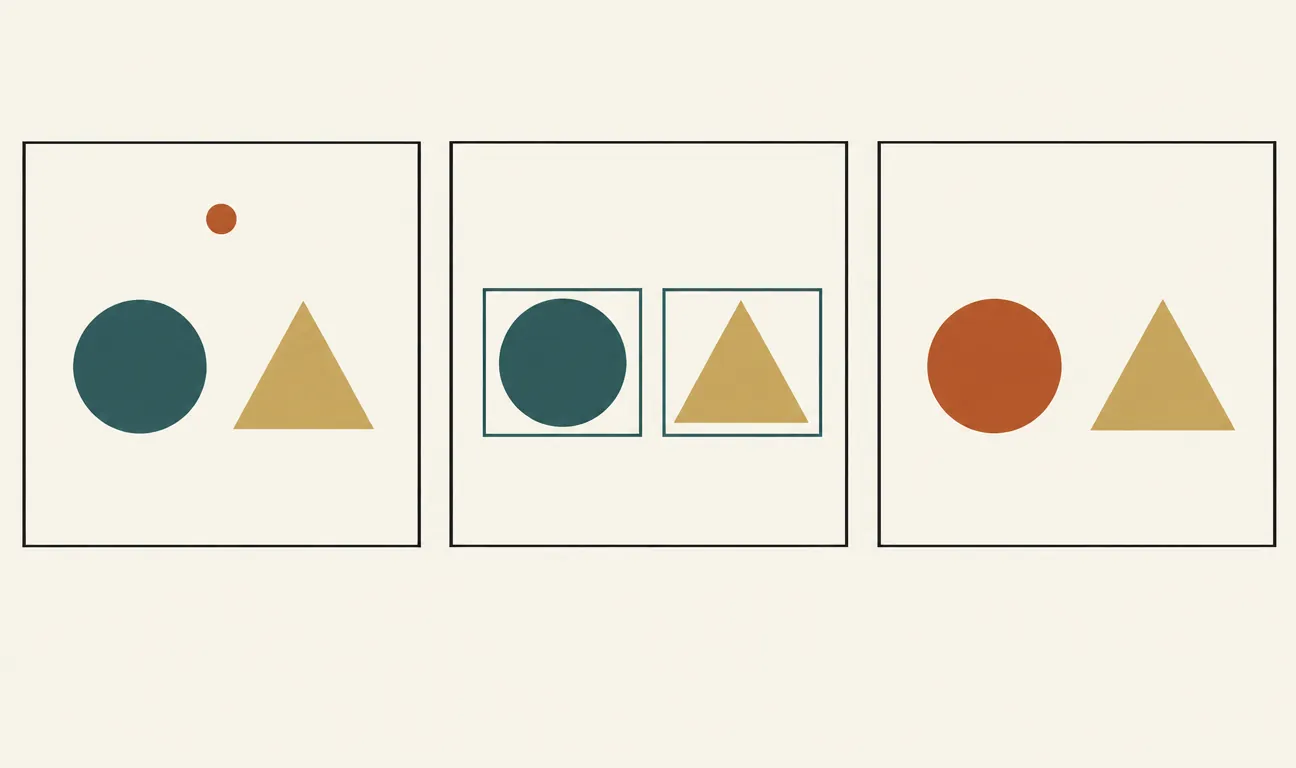
Un’auto con guida assistita frena perché ha visto un pedone. Un’app medica evidenzia il contorno esatto di una lesione su una TAC. Il vostro telefono ritrova in due secondi tutte le foto del gatto scattate negli ultimi cinque anni. Tre situazioni molto diverse, un’unica materia prima — un’immagine — e tre domande completamente distinte: che cosa c’è?, dove sta?, quali pixel occupa esattamente? La computer vision moderna si regge su questa distinzione, e chi la ignora finisce quasi sempre per costruire il sistema sbagliato, o per pagare un sistema più costoso del necessario.
Dal riquadro alla maschera, due stadi contro uno, le ancore e le metriche IoU e mAP: nel libro.
Tre domande alla stessa fotografia
Prendete una foto qualsiasi: un cane che rincorre una palla in un prato. La classificazione risponde alla domanda più semplice: che cosa contiene l’immagine? Il modello guarda tutta la foto e restituisce una singola etichetta con un punteggio di fiducia — «cane», 0.92. Niente coordinate, niente contorni: un giudizio globale.
La object detection fa un passo in più: non solo dice che cosa, ma anche dove. Restituisce una lista di riquadri rettangolari (le bounding box), ognuno con la sua etichetta e la sua fiducia: «cane» qui, «palla» là. È la domanda giusta quando gli oggetti possono essere più d’uno e la loro posizione conta.
La segmentazione arriva alla risposta più fine possibile: assegna una classe a ogni singolo pixel. Non un rettangolo attorno al cane, ma la sagoma esatta del cane, pixel per pixel — e attorno, il prato classificato come prato, il cielo come cielo.
La stessa scena, tre output: la classificazione dà un’etichetta globale, la detection disegna riquadri attorno agli oggetti, la segmentazione assegna una classe a ogni pixel.
Classificazione: il bibliotecario che sceglie lo scaffale
La classificazione è il compito più antico e più studiato della vision moderna: è quello su cui si misuravano le reti convoluzionali su ImageNet, il benchmark da un milione di immagini che ha acceso il decennio del deep learning. Il meccanismo è lineare: una rete (una CNN o, sempre più spesso, un vision transformer) comprime l’immagine in un vettore di caratteristiche, e un ultimo strato lo trasforma in una distribuzione di probabilità sulle classi possibili tramite una softmax.
L’analogia utile è il bibliotecario: gli consegnate un libro e lui vi dice su quale scaffale va — «narrativa», «saggistica», «gialli». Non vi dice a che pagina si trova la scena del delitto, né quante scene del delitto ci sono: giudica l’oggetto nel suo insieme. Per molti problemi reali basta e avanza: moderazione di contenuti, controllo qualità («pezzo difettoso sì/no»), smistamento di documenti scansionati. Ed è anche il compito più economico da addestrare, perché annotare i dati richiede solo un’etichetta per immagine.
Detection: trovare gli oggetti, uno per uno
La detection deve risolvere due problemi insieme: localizzare (dove sono gli oggetti) e classificare (che cosa sono). L’output non ha nemmeno una dimensione fissa: in una foto possono esserci zero oggetti o cinquanta. Per questo l’architettura è più elaborata: il modello propone molti riquadri candidati, li valuta, e poi una procedura chiamata non-maximum suppression elimina i duplicati che si sovrappongono troppo, tenendo per ogni oggetto solo il riquadro più convinto.
La qualità di un riquadro si misura con la Intersection over Union (IoU): quanto la scatola predetta si sovrappone a quella vera, in proporzione all’area totale che le due coprono insieme. È lo stesso criterio con cui giudichereste due evidenziature sulla stessa frase: perfette se coincidono, inutili se una evidenzia il paragrafo sbagliato.
Storicamente le famiglie di modelli sono due. Quelli a due stadi (come Faster R-CNN) prima propongono regioni interessanti e poi le classificano con cura: più precisi, più lenti. Quelli a uno stadio (la famiglia YOLO, «You Only Look Once») fanno tutto in un passaggio solo: meno raffinati sui casi difficili, ma abbastanza veloci da girare in tempo reale su una telecamera. Se il vostro problema è contare le persone in coda o rilevare caschi mancanti in cantiere, è quasi certamente un problema di detection.
Scegliere tra classificazione, detection e segmentazione non è un dettaglio tecnico: è decidere quanta verità vi serve — e quanto siete disposti a pagare per annotarla.
Segmentazione: il catasto dell’immagine
La segmentazione è il catasto: non si accontenta di dire «qui c’è un terreno agricolo», ma ne traccia i confini esatti, particella per particella. Tecnicamente il modello produce una mappa grande quanto l’immagine, dove ogni pixel porta la sua classe. Le architetture classiche hanno una forma a clessidra: un encoder comprime l’immagine in una rappresentazione astratta, un decoder la riespande fino alla risoluzione originale, spesso con «scorciatoie» tra i due lati (come nella U-Net, nata proprio per le immagini biomediche) per non perdere i dettagli fini dei bordi.
Attenzione a una distinzione che genera equivoci: la segmentazione semantica dice solo «questi pixel sono cane», senza distinguere tra due cani attaccati; la segmentazione di istanza separa cane numero uno da cane numero due; la panoptica combina le due cose, classificando anche lo sfondo. In radiologia, in agricoltura di precisione, nella guida autonoma — ovunque il confine esatto abbia valore — la segmentazione è l’unico compito che risponde alla domanda giusta.
Stesso tronco, teste diverse
La buona notizia è che i tre compiti condividono gran parte del lavoro. Le architetture moderne sono costruite come un albero: un backbone comune (il tronco) estrae le caratteristiche visive generali — bordi, texture, forme, parti di oggetti — e delle teste specializzate le trasformano nell’output richiesto: un vettore di classi, una lista di riquadri, una mappa di pixel. Lo stesso backbone pre-addestrato su milioni di immagini si ricicla per tutti e tre gli usi, ed è il motivo per cui oggi si parte quasi sempre da un modello pre-addestrato e lo si adatta al proprio dominio.
Quello che invece non si condivide è il costo dell’annotazione, e cresce brutalmente lungo la scala. Etichettare un’immagine per la classificazione richiede un click. Disegnare bounding box richiede decine di secondi a immagine. Tracciare maschere di segmentazione a mano può richiedere minuti per una singola foto complessa. Su dataset da decine di migliaia di immagini, questa differenza si traduce in settimane di lavoro umano e in budget molto diversi.
Perché vi riguarda
Se state valutando o commissionando un sistema di visione — per un magazzino, una linea di produzione, un’applicazione medicale — la prima domanda da fare non è «che modello usate?» ma «che compito state risolvendo?». Un problema che sembra richiedere segmentazione spesso si accontenta di detection; uno che sembra richiedere detection a volte è pura classificazione («c’è almeno un difetto in questa foto?»). Scendere di un gradino sulla scala significa dati più economici, modelli più semplici, meno errori da gestire. E quando leggete che un modello «capisce le immagini», ora sapete che dietro quella frase vaga ci sono tre domande precise — e che la differenza tra un’etichetta, un riquadro e una sagoma di pixel è la differenza tra tre prodotti diversi.
I commenti sono riservati agli iscritti.
Accedi per commentare