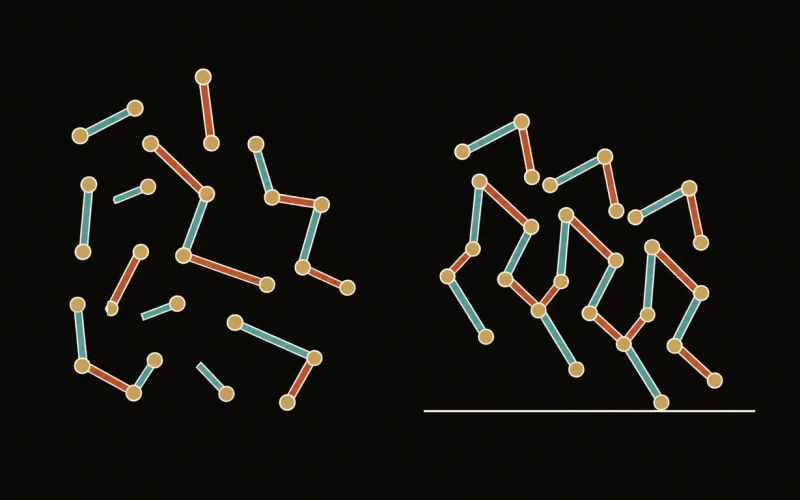
STEP, lo scheletro che non si rompe: anomalie nei video di sorveglianza cercate nello spazio delle componenti principali
Un gruppo di Graz rilegge il proprio metodo del 2024 per trovare comportamenti anomali nei video guardando solo le pose:…
Un gruppo di Graz rilegge il proprio metodo del 2024 per trovare comportamenti anomali nei video guardando solo le pose:…
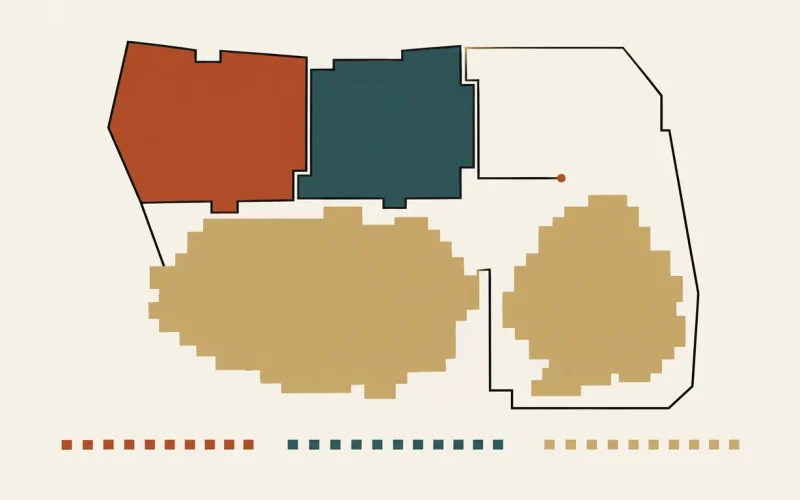
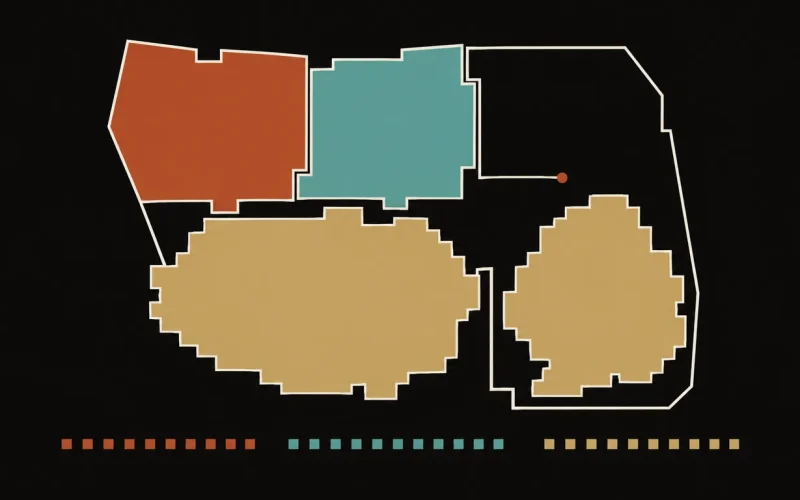
Le planimetrie nascono vettoriali nei programmi CAD e circolano come immagini, e l'immagine ha perso tutto quello che serviva a…

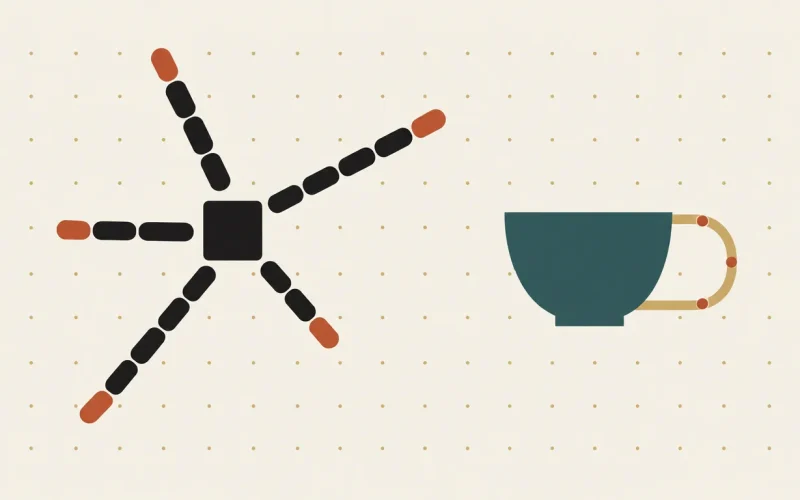
I pianificatori di presa per mani robotiche a più dita finiscono quasi sempre per stringere l'oggetto a pugno, perché è…

Trentacinque autori, guidati da un ricercatore dell'Università di Jilin, mettono in fila le «ingegnerie» degli ultimi anni e ne propongono…

Un gruppo dell'Università di Washington addestra un world-action model da 6 miliardi di parametri a prevedere non solo i prossimi…

Dire dove sta un oggetto nello spazio, quanto è grande e come è girato, a partire da una sola fotografia:…

Il test-time training promette modelli che si aggiornano mentre leggono, ma finora chiedeva architetture nuove da addestrare da zero. ByteDance…

I modelli visione-linguaggio indicano un oggetto dettando le coordinate del suo riquadro una alla volta, come si detta un numero…

Molti modelli che leggono documenti guardano la pagina con un occhio addestrato su foto di strade, gatti e automobili. Un…

Nei modelli che generano video l'attenzione è la voce di spesa più grande, e i metodi per sfoltirla pagano due…