
Nel 2015 allenare una rete neurale profonda somigliava a un lavoro artigianale: inizializzazioni calibrate al millimetro, learning rate microscopici, e la sensazione costante che tutto potesse divergere al prossimo passo. Poi due ricercatori di Google, Sergey Ioffe e Christian Szegedy, pubblicano un paper con un’idea quasi banale: dentro la rete, tra un layer e l’altro, normalizzare i dati — sottrarre la media, dividere per la deviazione standard. Nel paper riportano che la stessa rete per il riconoscimento di immagini raggiunge la stessa accuratezza con una frazione dei passi di training. La batch normalization diventa in pochi mesi un ingrediente standard, presente ancora oggi in quasi tutte le reti convoluzionali. Il bello è che perché funzioni così bene è rimasto controverso per anni — e la spiegazione del paper originale si è rivelata probabilmente sbagliata.
Segnale che svanisce o esplode, inizializzazione, batch normalization, dropout e gli ottimizzatori: il capitolo è nel libro.
Il problema: imparare da un capo che cambia idea ogni giorno
Una rete profonda è una catena: l’output del layer 3 è l’input del layer 4, e così via. Durante il training, però, tutti i layer cambiano contemporaneamente a ogni aggiornamento. Dal punto di vista del layer 4, i dati che riceve non sono stabili: la loro distribuzione — dove sono centrati, quanto sono dispersi — si sposta di continuo, perché i layer a monte continuano a modificarsi. Il layer 4 sta imparando a elaborare un segnale che nel frattempo cambia natura.
È la condizione dell’apprendista con un capo che cambia idea ogni giorno: lunedì gli si chiede una cosa, martedì i criteri sono già diversi, e ogni correzione arriva su un bersaglio che si è spostato. Si può imparare anche così, ma serve muoversi con estrema cautela — nel training, la cautela si traduce in learning rate piccoli e convergenza lenta. Ioffe e Szegedy battezzarono questo fenomeno internal covariate shift, e la loro proposta fu diretta: se il problema è che le distribuzioni si muovono, inchiodiamole.
Cosa fa esattamente: due righe di statistica
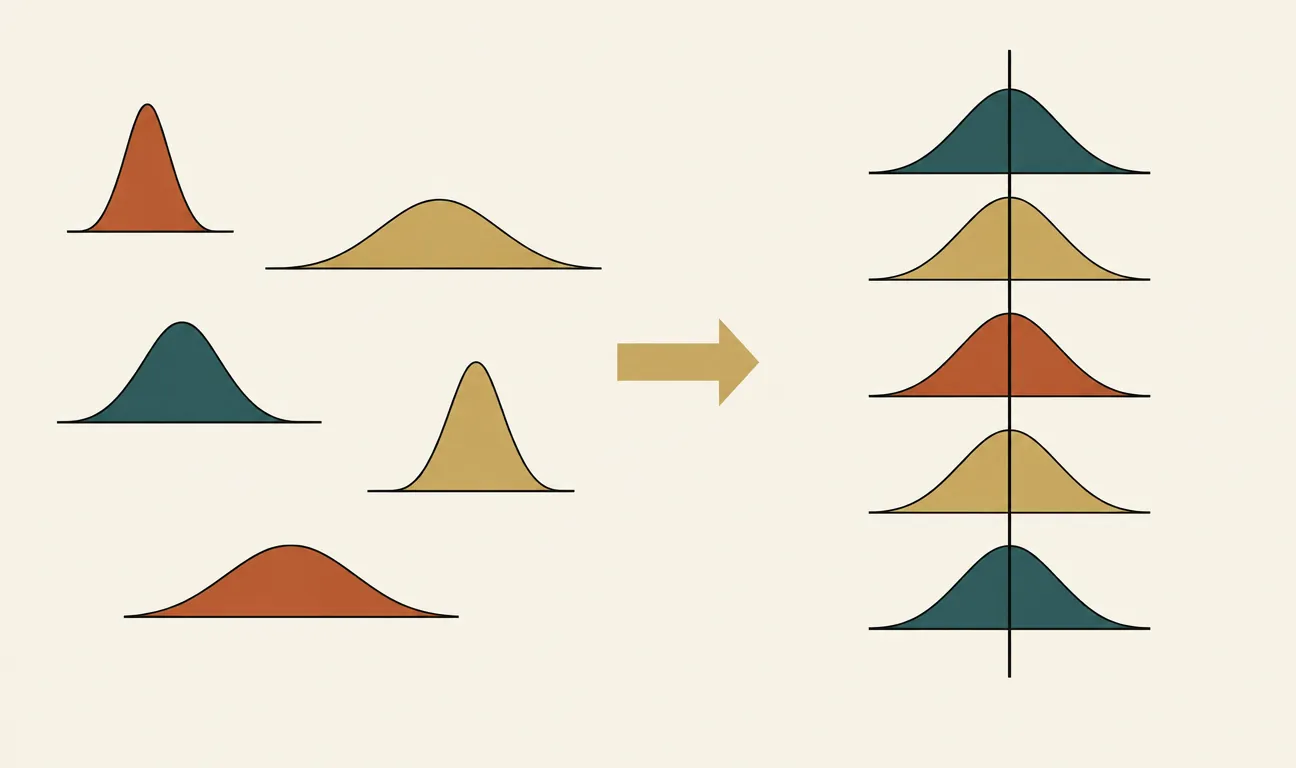
L’operazione è elementare. Durante il training la rete non elabora un esempio alla volta ma un mini-batch — poniamo 32 esempi insieme. Per ogni attivazione, la batch norm calcola media e deviazione standard su quei 32 esempi, poi sottrae la media e divide per la deviazione: x_norm = (x - media) / std. Il risultato è un segnale centrato in zero con dispersione uno, a ogni layer, a ogni passo, qualunque cosa stiano combinando i layer a monte.
È lo stesso gesto di chi deve confrontare voti provenienti da scuole con metri di giudizio diversi: prima di paragonarli, li riporta su una scala comune. Qui la scala comune non serve al confronto ma alla stabilità: il layer successivo riceve sempre dati «nella stessa valuta».
C’è però una finezza che distingue la batch norm da una normalizzazione ingenua: dopo aver standardizzato, la rete moltiplica per un parametro γ e somma un parametro β, entrambi appresi durante il training. Se per un certo layer la normalizzazione fosse controproducente, la rete può usarli per riscalarla o persino annullarla. La distribuzione non è imposta: è resa controllabile, spostata da effetto collaterale caotico a scelta esplicita del modello.
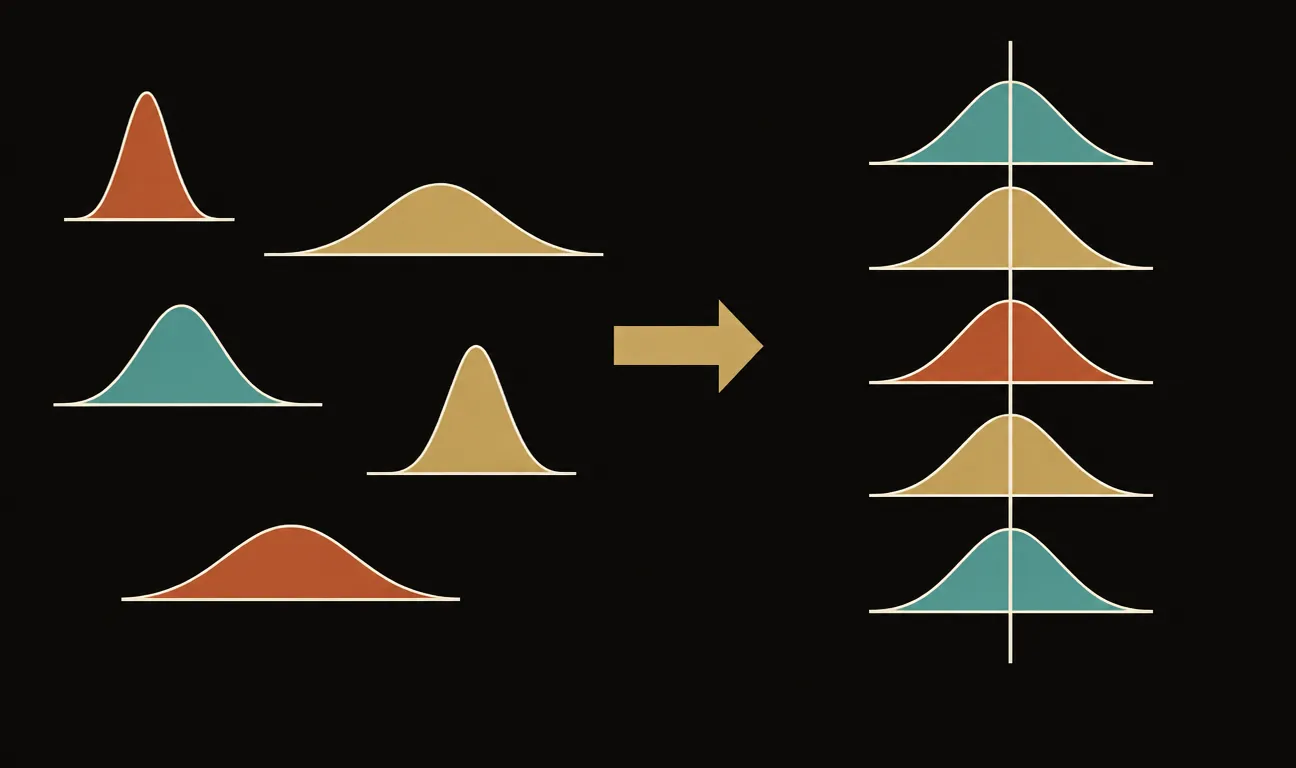
Prima della batch norm, la distribuzione delle attivazioni si sposta a ogni aggiornamento dei layer a monte; dopo, ogni layer riceve un segnale ri-centrato in zero con dispersione unitaria, che i parametri appresi γ e β possono poi riscalare.
Gli effetti: passi più lunghi, meno equilibrismi
I benefici pratici sono immediati e ben documentati. Con la batch norm si possono usare learning rate molto più alti senza divergere, il che accelera drasticamente la convergenza. La sensibilità all’inizializzazione dei pesi crolla: reti che prima richiedevano schemi di inizializzazione studiati apposta diventano tolleranti. E c’è un effetto collaterale curioso: un lieve potere regolarizzante. Poiché media e varianza sono calcolate sul mini-batch, ogni esempio viene normalizzato con statistiche leggermente diverse a seconda dei compagni di batch capitati per caso — un pizzico di rumore che, come il dropout, rende la rete meno incline a imparare a memoria.
La rete non impara meglio perché i dati sono diventati più belli: impara meglio perché il terreno su cui scende il gradiente è diventato più liscio.
Perché funziona davvero: la spiegazione è cambiata strada facendo
Qui la storia prende una piega istruttiva. Per anni la spiegazione ufficiale è stata quella del paper: la batch norm funziona perché riduce l’internal covariate shift. Poi, nel 2018, un gruppo del MIT guidato da Shibani Santurkar ha messo la spiegazione alla prova con un esperimento elegante: hanno preso una rete con batch norm e reintrodotto artificialmente lo shift delle distribuzioni, iniettando rumore dopo la normalizzazione. Se la teoria fosse stata giusta, i benefici sarebbero dovuti sparire. Non sono spariti: la rete continuava ad allenarsi bene.
La loro spiegazione alternativa: la batch norm rende il paesaggio della loss più liscio. I gradienti diventano più stabili e più predittivi — la direzione calcolata in un punto resta una buona indicazione anche qualche passo più in là. È la differenza tra scendere un sentiero sconnesso, dove ogni passo va verificato, e scendere un pendio erboso, dove si può allungare la falcata con fiducia: ecco da dove viene la tolleranza ai learning rate alti. La morale va oltre il caso specifico: nel deep learning capita spesso che una tecnica funzioni benissimo per ragioni diverse da quelle per cui era stata inventata, e che la spiegazione arrivi anni dopo la pratica.
I limiti: dove la batch norm non basta
La dipendenza dal batch, che è la fonte del suo effetto regolarizzante, è anche il suo tallone d’Achille. Con batch piccoli — 2, 4 esempi, situazione comune quando i modelli sono grandi e la memoria GPU è poca — media e varianza calcolate su così pochi campioni sono stime pessime, e le prestazioni degradano. C’è poi un’asimmetria scomoda tra training e inferenza: quando il modello risponde a una singola richiesta non esiste alcun batch su cui calcolare statistiche, quindi si usano medie mobili accumulate durante il training — una discrepanza tra i due regimi che è una classica sorgente di bug sottili.
Per questo esistono le alternative. La più importante è la layer normalization, che normalizza sulle attivazioni di un singolo esempio invece che sul batch: niente dipendenza dai compagni di batch, nessuna differenza tra training e inferenza. È la scelta adottata dai Transformer, ed è quindi la normalizzazione che gira dentro tutti i modelli linguistici che usate ogni giorno. La batch norm resta la regina delle reti convoluzionali; nel mondo LLM il testimone è passato.
Perché vi riguarda
Se leggete o scrivete codice di deep learning, la batch norm è ovunque, e conoscerne il funzionamento evita errori concreti: dimenticare di mettere il modello in modalità valutazione — model.eval() in PyTorch — significa usare le statistiche del batch invece delle medie mobili, e ottenere predizioni sbagliate in modo silenzioso. È probabilmente il bug da principiante più diffuso dell’ecosistema. Se invece vi interessa capire come progredisce il campo, questa storia è un caso di studio quasi perfetto: un’idea semplice che funziona subito, una spiegazione plausibile che si rivela sbagliata, e una comprensione vera che arriva solo anni dopo, per via sperimentale. Il deep learning avanza così — prima la pratica, poi la teoria.
Il paper originale
La tecnica è introdotta in Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift (2015) di Sergey Ioffe e Christian Szegedy. La rilettura critica sul perché funziona è How Does Batch Normalization Help Optimization? (2018) di Shibani Santurkar, Dimitris Tsipras, Andrew Ilyas e Aleksander Mądry. Per la layer normalization usata nei Transformer, il riferimento è Layer Normalization (2016) di Jimmy Lei Ba, Jamie Ryan Kiros e Geoffrey Hinton.
I commenti sono riservati agli iscritti.
Accedi per commentare