
C’è un esperimento che chiunque abbia addestrato una rete neurale ha fatto, volente o nolente: stesso modello, stessi dati, stesso codice, e due training che finiscono in modi opposti. Uno converge pulito, l’altro esplode in una loss che diventa NaN dopo trecento passi. La differenza? Un solo numero: 0.001 contro 0.01. Il learning rate è l’iperparametro con il rapporto più estremo tra quanto è piccolo da scrivere e quanto pesa sul risultato.
Segnale che svanisce o esplode, inizializzazione, batch normalization, dropout e gli ottimizzatori: il capitolo è nel libro.
Che cosa regola davvero
A ogni passo di training, il gradiente dice in che direzione muovere i pesi per ridurre l’errore. Il learning rate decide di quanto muoversi in quella direzione: w = w - lr * gradiente. Tutto qui. Ma da questo «quanto» dipende l’intero comportamento dell’ottimizzazione.
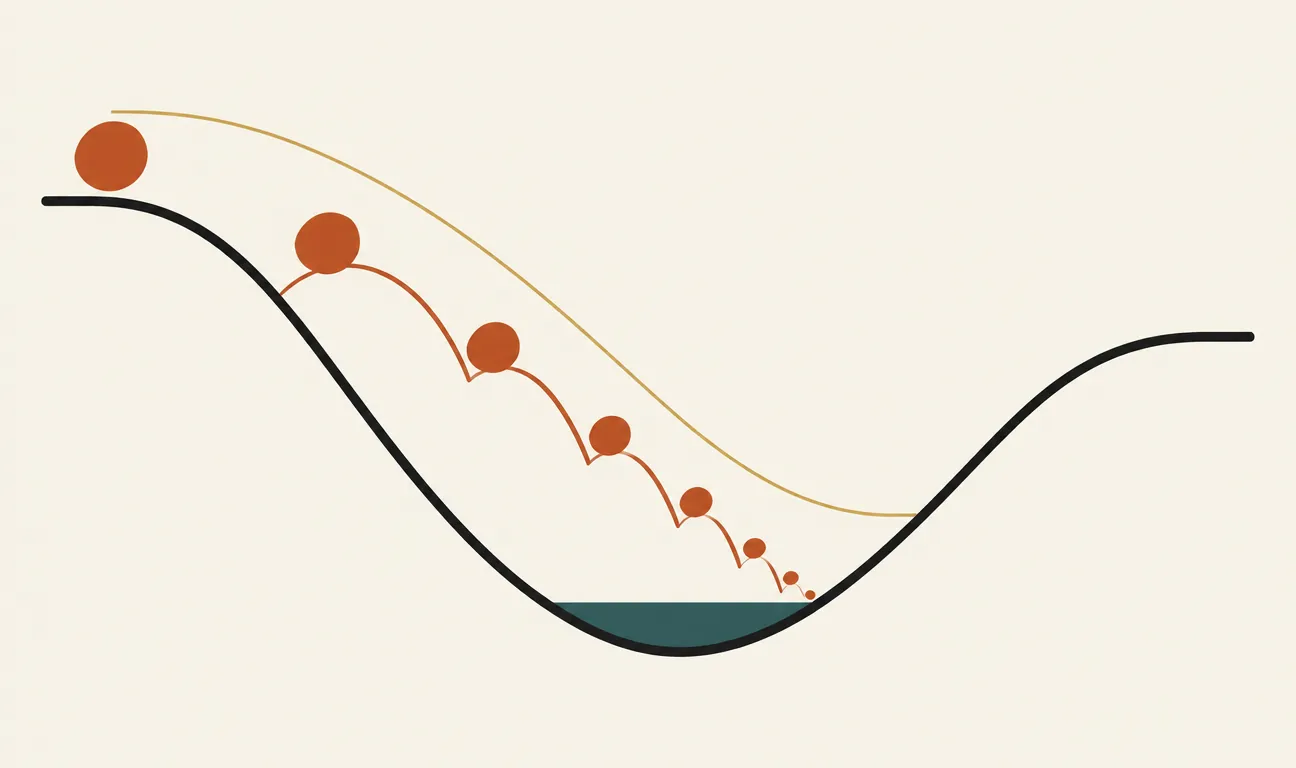
L’analogia classica è la discesa da una montagna nella nebbia: il gradiente è la pendenza sotto i piedi, il learning rate è la lunghezza del passo. Passi troppo corti e impieghi una vita ad arrivare a valle — o peggio, ti fermi nella prima conca che incontri. Passi troppo lunghi e scavalchi la valle, atterrando sul versante opposto più in alto di prima; nei casi estremi ogni salto ti porta più in alto del precedente, e la loss diverge.
C’è anche un effetto meno intuitivo: il learning rate regola quanto «rumore» entra nel percorso. Con batch piccoli e passi grandi, la traiettoria è irregolare, e questa irregolarità non è solo un difetto: aiuta a scavalcare i minimi stretti e a finire in zone larghe e piatte della superficie di loss, che tendono a generalizzare meglio. Un learning rate non è solo una velocità: è anche una temperatura.
Perché un valore fisso non basta
Se il learning rate ideale esistesse, sarebbe un numero solo e la storia finirebbe qui. Il punto è che il valore giusto cambia durante il training. All’inizio i pesi sono casuali e si è lontani da qualsiasi soluzione: conviene muoversi in fretta. Verso la fine si è vicini a un buon minimo e servono aggiustamenti fini: lo stesso passo che prima faceva progredire ora fa solo oscillare attorno alla soluzione senza mai fermarsi.
Da qui l’idea dello scheduler: una funzione che fa variare il learning rate nel tempo secondo un programma prestabilito. Le ricette storiche sono lo step decay (dividi per 10 ogni tot epoche, il classico dell’era ImageNet) e l’exponential decay. Ma la combinazione che ha vinto nell’era dei transformer è un’altra: warmup lineare seguito da cosine decay.
Warmup: partire piano per andare lontano
Il warmup è controintuitivo: nei primi passi — tipicamente qualche centinaio o qualche migliaio — il learning rate parte da quasi zero e sale linearmente fino al valore massimo. Perché rallentare proprio all’inizio, quando si è più lontani dalla meta?
Perché l’inizio è il momento più fragile del training. I pesi sono casuali, i gradienti dei primi batch sono enormi e poco rappresentativi, e gli ottimizzatori adattivi come Adam hanno statistiche interne ancora inaffidabili, calcolate su una manciata di campioni. Un passo pieno in queste condizioni può spingere la rete in una regione da cui non si riprende più: attivazioni sature, gradienti esplosi, training compromesso nei primi minuti. Il warmup è la rampa di accelerazione dell’autostrada: non entri in corsia a tutta velocità da fermo, ti allinei gradualmente al flusso. Per i transformer, in particolare, il warmup non è un’ottimizzazione ma quasi un requisito: senza, il training spesso diverge.
Cosine decay: la discesa morbida
Dopo il picco, il cosine decay fa scendere il learning rate seguendo mezza curva del coseno: una discesa che parte lenta, accelera nella fase centrale e rallenta di nuovo verso la fine, avvicinandosi dolcemente al valore minimo. Rispetto allo step decay, che procede a gradini bruschi, la transizione continua evita gli assestamenti improvvisi a ogni scalino e ha un solo parametro davvero importante: la durata totale del training, che va decisa in anticipo.
Il programma tipico dei transformer moderni: il learning rate sale linearmente durante il warmup, tocca il massimo, poi scende seguendo mezza curva del coseno fino a un valore minimo.
Questa accoppiata — warmup lineare più cosine decay — è oggi il programma standard nel pre-training dei grandi modelli di linguaggio. Non perché sia teoricamente ottimale (non c’è una dimostrazione che lo sia), ma perché è semplice, robusta e ha funzionato ripetutamente su scala.
Il learning rate non è un numero: è una traiettoria. Chi lo tratta come una costante sta usando lo scheduler più povero di tutti.
Come si sceglie, in pratica
Qualche criterio operativo, distillato dalla pratica comune:
- Ordine di grandezza prima, cifre poi. La differenza tra 0.001 e 0.003 è rifinitura; quella tra 0.001 e 0.01 è spesso la differenza tra convergere e divergere. Esplora in scala logaritmica: 1e-4, 3e-4, 1e-3, 3e-3.
- Il learning rate massimo dipende dal batch size. Batch più grandi producono gradienti meno rumorosi e tollerano passi più lunghi; una regola empirica diffusa è scalare il learning rate insieme al batch size, con le dovute cautele.
- Leggi i sintomi. Loss che esplode o oscilla violentemente: learning rate troppo alto. Loss che scende con lentezza esasperante e in modo quasi perfettamente liscio: probabilmente troppo basso.
- Il warmup serve soprattutto con Adam e con i transformer. Per una piccola rete convoluzionale con SGD si può spesso omettere; per un transformer, no.
- Fine-tuning: tutto più piccolo. Partendo da un modello pre-addestrato, i pesi sono già buoni: learning rate da 10 a 100 volte più basso del pre-training, altrimenti si distrugge quello che il modello sa già.
Un’ultima nota su un equivoco comune: «uso Adam, quindi il learning rate si regola da solo». No. Adam adatta il passo relativo tra i parametri, ma la scala complessiva resta governata dal learning rate globale, che va comunque scelto e schedulato. Tutti i grandi training con AdamW usano warmup e decay: se il learning rate si regolasse da solo, non lo farebbero.
Perché ti riguarda
Se una sola cosa dovesse restarti di questa serie sul deep learning, è questa gerarchia pratica: prima di toccare l’architettura, prima di aggiungere dati, prima di cambiare ottimizzatore, controlla il learning rate e il suo scheduler. È il singolo intervento con il miglior rapporto tra sforzo e impatto. Un training che «non funziona» ha, più spesso di quanto l’orgoglio ammetta, un learning rate sbagliato di un fattore dieci. E quando leggerai il report tecnico di un modello — dove learning rate massimo, passi di warmup e tipo di decay sono sempre dichiarati, al contrario di molti altri dettagli — saprai che quelle tre righe non sono burocrazia: sono la parte della ricetta senza la quale il piatto non riesce.
I commenti sono riservati agli iscritti.
Accedi per commentare