
Aprite un repository qualsiasi di deep learning su GitHub e cercate la riga in cui viene creato l’ottimizzatore. Nella grande maggioranza dei casi troverete torch.optim.Adam o AdamW, spesso con gli iperparametri lasciati ai valori di fabbrica. Adam è diventato la scelta che non si discute, il tasto «avvia» del training. Eppure il paper che lo ha introdotto, nel 2014, proponeva un compromesso preciso, con vantaggi misurabili e difetti altrettanto misurabili. Vale la pena capire che cosa firma chi scrive quella riga.
Segnale che svanisce o esplode, inizializzazione, batch normalization, dropout e gli ottimizzatori: il capitolo è nel libro.
Il problema: un solo passo per pesi molto diversi
La discesa del gradiente classica (SGD) aggiorna ogni peso della rete con la stessa regola: sottrai il gradiente moltiplicato per il learning rate. Un solo learning rate per milioni, o miliardi, di parametri.
Il problema è che i parametri non si somigliano affatto. In una rete reale ci sono pesi che ricevono gradienti grandi e frequenti (per esempio quelli legati a parole comuni, in un modello di linguaggio) e pesi che ricevono segnali rari e deboli (quelli legati a parole che compaiono una volta ogni diecimila frasi). Con un learning rate unico, o si va troppo piano sui primi o si strattonano troppo i secondi.
È come regolare il volume di un’orchestra con una sola manopola: se la alzi per sentire il triangolo, gli ottoni ti assordano. Servirebbe un mixer, una manopola per strumento. Adam è esattamente questo: un learning rate effettivo diverso per ogni singolo peso, calcolato automaticamente.
I due momenti: media e varianza del gradiente
Il nome Adam viene da Adaptive Moment Estimation. Per ogni parametro, l’algoritmo mantiene due statistiche aggiornate a ogni passo con una media mobile esponenziale:
- il primo momento
m: una media dei gradienti recenti. È la stessa idea del momentum: se il gradiente punta a lungo nella stessa direzione, accumula inerzia; - il secondo momento
v: una media dei gradienti al quadrato. Misura quanto il gradiente di quel peso è tipicamente grande o rumoroso.
L’aggiornamento del peso è, in sostanza, m / (sqrt(v) + ε) moltiplicato per il learning rate globale. La divisione per la radice del secondo momento è il cuore del meccanismo: se un peso ha gradienti abitualmente grandi, il denominatore cresce e il passo effettivo si riduce; se i gradienti sono piccoli e rari, il denominatore resta minuscolo e il passo effettivo si amplifica. Il mixer dell’orchestra, appunto: ogni manopola si autoregola in base a quanto quello strumento ha suonato forte di recente.
C’è un dettaglio spesso ignorato: la bias correction. Le due medie mobili partono da zero, quindi nei primi passi sottostimano sistematicamente i valori veri. Adam le corregge dividendo per un fattore che dipende dal numero di passi fatti. Senza questa correzione, i primi aggiornamenti sarebbero distorti proprio nel momento più delicato del training.
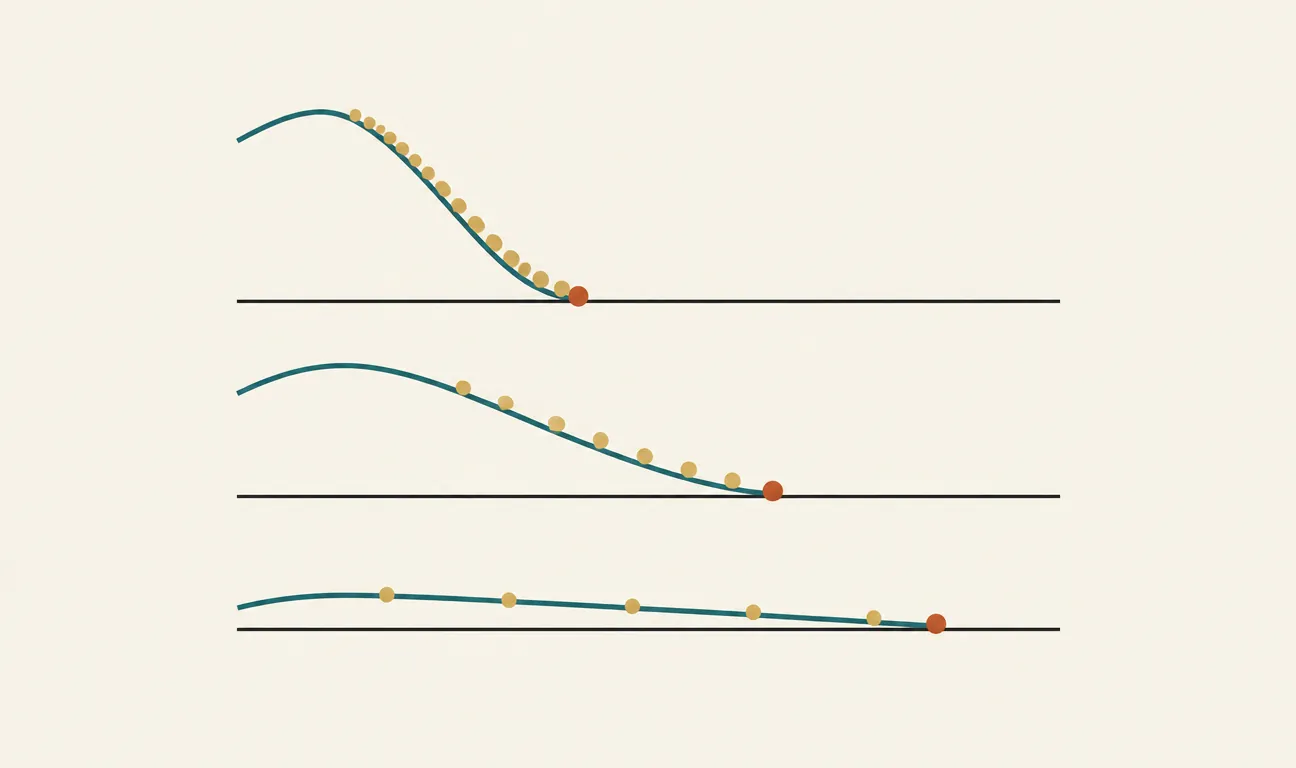
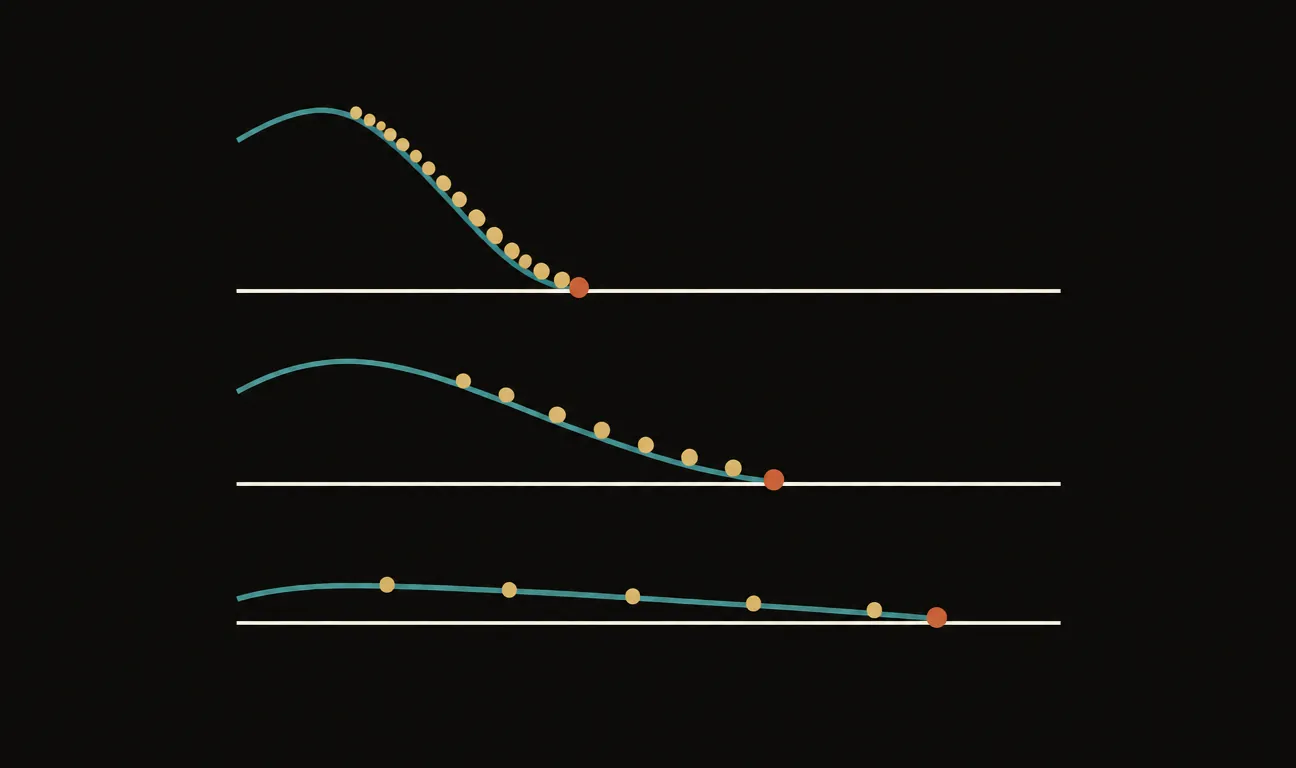
SGD applica lo stesso passo a tutti i parametri; Adam lo scala peso per peso, accorciandolo dove i gradienti sono grandi e allungandolo dove sono rari.
Perché è diventato il default
La forza di Adam è pragmatica: funziona decentemente quasi subito, quasi ovunque. Con SGD puro, il learning rate va cercato con pazienza, e un valore sbagliato di un fattore dieci può fare la differenza tra convergere e divergere. Adam è molto più tollerante: i suoi valori di fabbrica (learning rate 0.001, β₁ = 0.9, β₂ = 0.999) producono un training ragionevole su una gamma sorprendente di architetture e dataset.
Per chi prototipa, questo conta più di ogni teorema. Un ricercatore che prova dieci idee a settimana non può permettersi una ricerca di iperparametri per ciascuna: gli serve un ottimizzatore che «parta», e Adam parte. È il motivo per cui è diventato lo standard de facto nel training dei transformer, dove SGD fatica notevolmente a convergere.
Adam non è l’ottimizzatore migliore. È l’ottimizzatore che sbaglia meno quando non hai tempo di sceglierne uno.
I difetti: generalizzazione e weight decay
Il primo difetto è emerso empiricamente su compiti di visione: modelli addestrati con Adam raggiungono spesso una loss di training più bassa, ma generalizzano peggio di modelli addestrati con SGD con momentum ben regolato. Su ImageNet, per anni, i risultati migliori delle reti convoluzionali sono arrivati da SGD. Una delle spiegazioni proposte è che i passi adattivi portino il modello verso minimi «più stretti» della superficie di loss, che si comportano peggio su dati mai visti. Il dibattito teorico non è chiuso, ma il fenomeno pratico è stato replicato molte volte.
Il secondo difetto è più sottile ed è un vero errore di design: l’interazione con la regolarizzazione L2. Nell’implementazione classica, la penalità sui pesi viene sommata al gradiente prima della divisione per sqrt(v). Risultato: i pesi con gradienti grandi ricevono meno regolarizzazione, quelli con gradienti piccoli ne ricevono di più. La penalità, che dovrebbe essere uniforme, viene distorta dal meccanismo adattivo. AdamW, proposto da Loshchilov e Hutter, corregge il problema «sganciando» il weight decay dal gradiente e applicandolo direttamente ai pesi. È per questo che oggi, nel training dei modelli di linguaggio, il default reale non è Adam ma AdamW.
C’è infine una questione di memoria: Adam conserva due statistiche per ogni parametro. Per un modello da 7 miliardi di parametri significa gigabyte aggiuntivi di stato dell’ottimizzatore, un costo che ha motivato varianti a memoria ridotta come Adafactor e le versioni quantizzate a 8 bit.
Quando non usarlo
La regola pratica che emerge da un decennio di esperienza collettiva è più sfumata di «usa sempre Adam»:
- Transformer e NLP: AdamW è lo standard, con warmup del learning rate. Qui SGD non è competitivo.
- Reti convoluzionali su visione: SGD con momentum e uno scheduler ben scelto resta un avversario serio, spesso superiore in generalizzazione a parità di budget.
- Fine-tuning: AdamW con learning rate molto basso è la scelta comune; la robustezza agli iperparametri conta più dell’ultimo punto percentuale.
- Budget di memoria stretto: valutare Adafactor o gli ottimizzatori a stato quantizzato.
Perché ti riguarda
Se lavori con il deep learning, la riga optimizer = AdamW(model.parameters()) è probabilmente la più copiata e meno letta di tutto il tuo codice. Sapere che cosa fa — un mixer di learning rate governato da due medie mobili, con una correzione di bias e un weight decay che va tenuto fuori dal meccanismo adattivo — ti dà tre cose concrete: la capacità di diagnosticare un training che non converge, il criterio per decidere quando provare SGD, e la consapevolezza che «default» è una parola che descrive un’abitudine, non un ottimo. Gli ottimizzatori sono uno dei pochi punti del deep learning dove una scelta da una riga cambia il risultato finale. Vale la pena farla da svegli.
I commenti sono riservati agli iscritti.
Accedi per commentare