
Guardate la curva della loss di una rete addestrata con discesa del gradiente pura: non scende, trema. Sale un po’, riscende, oscilla intorno a un valore per centinaia di passi, poi crolla senza preavviso. Chi la vede per la prima volta pensa a un bug. Non lo è: è la firma di un algoritmo che sta scendendo lungo un canyon sbattendo da una parete all’altra. E la soluzione, sorprendentemente, non è un algoritmo nuovo: è una riga di codice in più, un’idea presa dalla fisica delle palle che rotolano. Si chiama momentum, ha più di sessant’anni, ed è ancora dentro ogni ottimizzatore che usate oggi.
Segnale che svanisce o esplode, inizializzazione, batch normalization, dropout e gli ottimizzatori: il capitolo è nel libro.
La S di SGD: perché il gradiente è «stocastico»
Prima l’inerzia, però, serve capire il rumore. La discesa del gradiente da manuale calcola il gradiente della loss su tutto il dataset a ogni passo. Con dieci milioni di esempi significa dieci milioni di calcoli per fare un singolo aggiornamento dei pesi: come chiedere il parere a ogni abitante d’Italia prima di ogni decisione. Accurato, ma non arrivate mai a decidere.
La versione stocastica (SGD, stochastic gradient descent) fa un sondaggio: prende un mini-batch — 32, 128, 512 esempi estratti a caso — e usa il gradiente calcolato solo su quelli. È una stima rumorosa della direzione vera, ma costa mille volte meno, e in media punta dalla parte giusta. Il patto è esplicito: accettiamo passi imprecisi in cambio di molti più passi.
Il rumore, va detto, non è solo un difetto. C’è una letteratura consistente che suggerisce come quel tremolio aiuti a non fermarsi nelle zone piatte e a preferire minimi «larghi», che tendono a generalizzare meglio. Ma il rumore ha un costo visibile: la traiettoria diventa una passeggiata da ubriaco, e in certe geometrie della loss il problema si amplifica.
Il canyon: dove SGD va in crisi
Immaginate la superficie della loss come una valle molto più lunga che larga: un canyon. Lungo l’asse del canyon la pendenza è dolce; sulle pareti laterali è ripidissima. È una situazione comune: succede ogni volta che parametri diversi hanno effetti di scala molto diversa sulla loss.
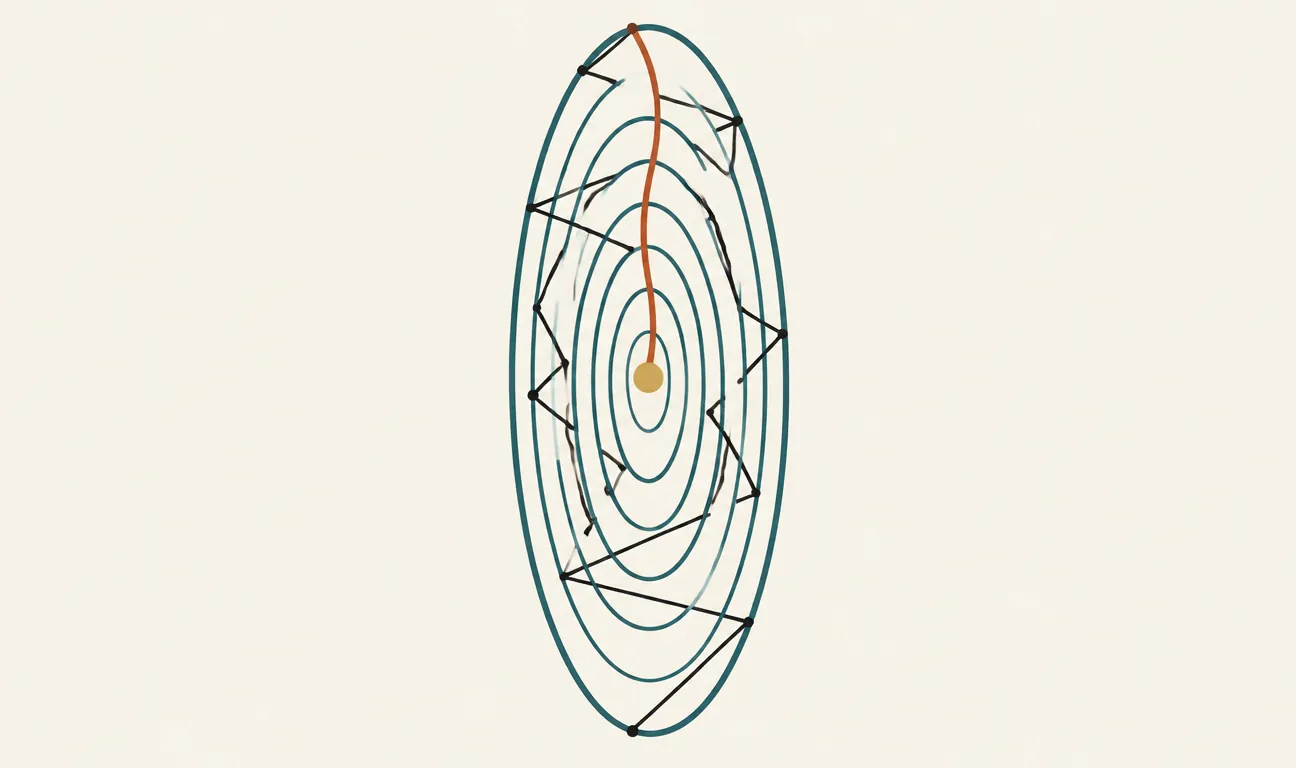
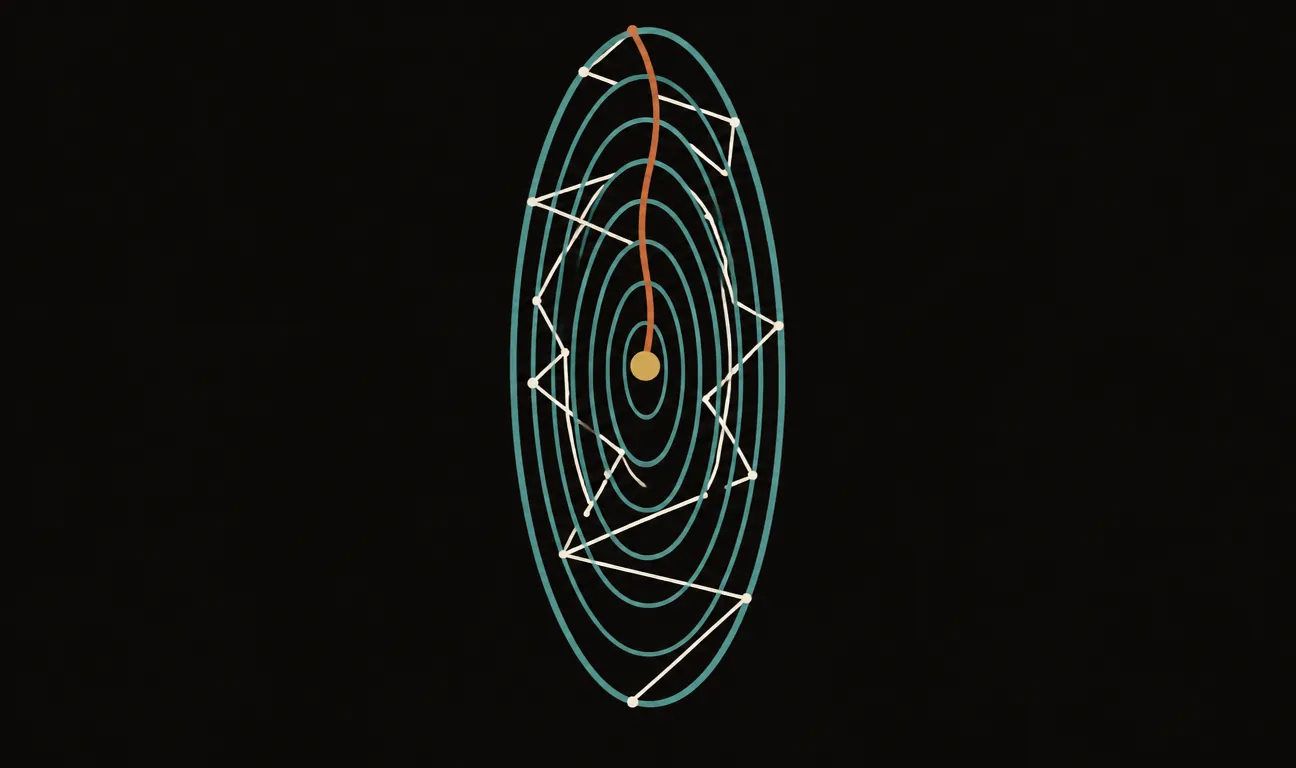
Il gradiente punta sempre nella direzione di massima pendenza locale — cioè quasi perpendicolare alle pareti, quasi mai lungo il fondovalle. Il risultato è lo zigzag: l’algoritmo attraversa il canyon, sbatte sulla parete opposta, torna indietro, e intanto avanza pochissimo nella direzione che conta. Se alzate il learning rate per andare più veloci, le oscillazioni si amplificano fino a divergere; se lo abbassate per calmarle, il progresso lungo il fondovalle diventa glaciale. Siete incastrati tra due learning rate sbagliati.
Momentum: la palla da bowling
La soluzione viene da un’osservazione fisica: una palla pesante che rotola in quel canyon non zigzaga. Le spinte laterali — verso una parete, poi verso l’altra — si annullano a vicenda, mentre la spinta costante lungo il fondovalle si accumula. La palla ha inerzia: la sua velocità è la storia di tutte le forze che ha ricevuto, non solo dell’ultima.
Il momentum traduce l’inerzia in due righe. Invece di aggiornare i pesi direttamente col gradiente, si mantiene una «velocità» v che è una media mobile esponenziale dei gradienti passati: v = β·v + g, poi w = w − lr·v. Il coefficiente β (tipicamente 0.9) decide quanta memoria tenere: con 0.9, il passo di oggi è fatto per il 10% dal gradiente corrente e per il 90% dall’eredità dei passi precedenti.
L’effetto sul canyon è esattamente quello della palla: le componenti laterali del gradiente cambiano segno a ogni passo e nella media si elidono; la componente lungo il fondovalle ha sempre lo stesso segno e nella media si rinforza, fino a un fattore 1/(1−β) — dieci volte, con β a 0.9. Stesso learning rate, oscillazioni smorzate, avanzamento decuplicato dove serve. E come bonus, la media mobile filtra anche il rumore dei mini-batch: due piccioni con un’inerzia sola.
La scelta di β è un compromesso tra reattività e stabilità, come la sospensione di un’auto. Un valore basso (0.5) dà una memoria corta: l’algoritmo resta nervoso, segue da vicino ogni gradiente, filtra poco. Un valore molto alto (0.99) dà una palla pesantissima: bellissima nei rettilinei, ma quando la valle curva continua dritta per inerzia e supera il minimo, oscillandoci intorno prima di assestarsi. Il default 0.9 è il punto di equilibrio trovato empiricamente in trent’anni di pratica; raramente c’è motivo di toccarlo, ma se il vostro training oscilla vistosamente dopo una discesa pulita, l’inerzia in eccesso è tra i primi sospettati.
Il gradiente dice dove andare adesso; il momentum ricorda dove stavate andando. Nei canyon della loss, la memoria vale più della vista.
Nesterov: guardare prima di saltare
Esiste una variante più furba, dovuta a Yurii Nesterov: invece di calcolare il gradiente dove siete, lo si calcola dove l’inerzia sta per portarvi. Se la palla sta per superare il fondovalle e risalire la parete opposta, il gradiente «anticipato» lo segnala un passo prima, e la correzione arriva in tempo invece che in ritardo. È la differenza tra frenare guardando il cruscotto e frenare guardando la strada. Nel codice è un parametro (nesterov=True in PyTorch); nella pratica dà spesso un miglioramento piccolo ma gratuito, e in ottimizzazione convessa ha garanzie teoriche dimostrabilmente migliori.
Le traiettorie a confronto
Curve di livello di una valle allungata. Senza momentum il gradiente punta quasi sempre contro le pareti e la traiettoria zigzaga; con momentum le componenti laterali si cancellano nella media e il percorso segue il fondovalle.
Cosa cambia per voi
Se addestrate modelli, il momentum non è un’opzione esotica: è il default silenzioso dentro quasi tutto. Adam, l’ottimizzatore più usato al mondo, ha il momentum incorporato come «primo momento»; l’SGD con momentum a 0.9 resta lo standard con cui si addestrano molte reti di visione, spesso con generalizzazione migliore delle alternative adattive. Quando vedete momentum=0.9 in un file di configurazione, adesso sapete cosa state regolando: quanta memoria ha la palla.
E se non addestrate nulla, resta una lezione di metodo che vale fuori dal machine learning: quando i segnali sono rumorosi e contraddittori, inseguire l’ultimo dato è il modo migliore per zigzagare. Una media mobile delle direzioni passate — nella discesa del gradiente come nelle decisioni — cancella il rumore e lascia emergere la tendenza. L’inerzia, dosata bene, non è testardaggine: è filtraggio.
I commenti sono riservati agli iscritti.
Accedi per commentare