
Due meteorologi sbagliano la previsione dello stesso giorno. Il primo aveva annunciato pioggia con il 99 per cento di probabilità; il secondo con il 60. Non è caduta una goccia. Hanno sbagliato entrambi, ma non allo stesso modo: il primo era sicurissimo e aveva torto, il secondo aveva lasciato spazio al dubbio. Qualsiasi sistema sensato di valutazione dovrebbe punire il primo molto più del secondo.
Questa intuizione — errori uguali in apparenza, gravità diverse — è esattamente ciò che una loss function formalizza. Ed è il punto in cui si decide, prima ancora di scegliere l’architettura, che cosa un modello imparerà davvero.
La loss è il contratto tra te e il modello
L’addestramento di una rete neurale è un meccanismo sorprendentemente semplice: il modello fa una previsione, una funzione — la loss — assegna a quella previsione un punteggio di errore, e l’ottimizzatore aggiusta i pesi nella direzione che riduce quel punteggio. Tutto qui. Il modello non sa nulla di «riconoscere gatti» o «tradurre frasi»: sa solo minimizzare un numero.
La loss è quindi un contratto: definisce che cosa significa sbagliare, e quanto. È come il regolamento di un esame: se il docente toglie punti solo per gli errori di calcolo, gli studenti cureranno i calcoli e trascureranno il ragionamento. Il modello fa lo stesso, con una diligenza spietata: ottimizza esattamente ciò che la loss misura, incluse le scorciatoie che non avevi previsto.
MSE: l’errore al quadrato
Per i problemi di regressione — prevedere un numero: un prezzo, una temperatura, una domanda di energia — la scelta classica è l’errore quadratico medio, MSE: si prende la differenza tra valore previsto e valore vero, la si eleva al quadrato, si fa la media su tutti gli esempi.
Il quadrato ha due conseguenze. La prima: il segno sparisce, sbagliare per eccesso o per difetto pesa uguale. La seconda, più importante: gli errori grandi vengono amplificati in modo più che proporzionale. Sbagliare di 2 costa 4; sbagliare di 10 costa 100. È una multa progressiva per eccesso di velocità: 10 km/h oltre il limite sono una contravvenzione, 60 km/h oltre sono il ritiro della patente. Il modello, di conseguenza, dedica la sua attenzione soprattutto a evitare gli sbagli clamorosi.
Questa proprietà è un’arma a doppio taglio. Se i dati contengono outlier — valori anomali, magari errori di misura — l’MSE li tratta come emergenze assolute e distorce il modello per accontentarli. Per questo esiste l’alternativa MAE, l’errore assoluto medio, che cresce linearmente ed è più tollerante verso le anomalie: la scelta tra i due è già una dichiarazione su come vuoi che il modello tratti i casi estremi.
Cross-entropy: misurare la sorpresa
Per la classificazione il gioco cambia. Il modello non produce un numero ma una distribuzione di probabilità: «gatto al 70 per cento, cane al 25, volpe al 5». La loss standard è la cross-entropy, che nella sua forma essenziale è brutalmente semplice: si guarda quanta probabilità il modello ha assegnato alla classe giusta, e si prende -log(p) di quel valore.
Il logaritmo negativo è una macchina per misurare la sorpresa. Se il modello assegnava alla risposta corretta il 99 per cento, la loss è quasi zero: nessuna sorpresa. Se le assegnava il 50 per cento, la loss è moderata. Ma se le assegnava l’1 per cento — cioè era molto sicuro di un’altra risposta — la loss esplode. È il nostro meteorologo arrogante: la cross-entropy non punisce l’errore in sé, punisce la sicurezza malriposta. Un bookmaker che ragionasse così manderebbe in rovina chi spara quote estreme a caso e premierebbe chi calibra onestamente le proprie probabilità.
La cross-entropy non chiede al modello di avere ragione. Gli chiede di essere onesto su quanto è sicuro.
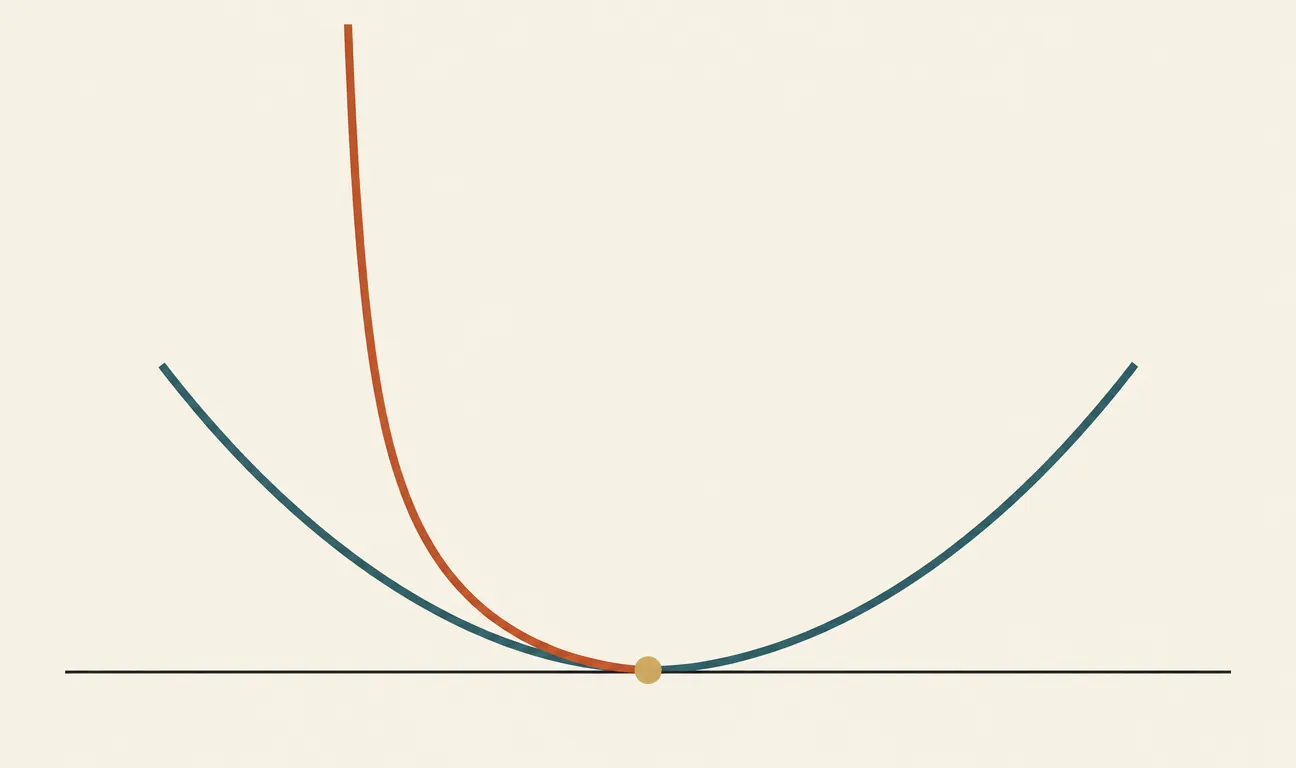
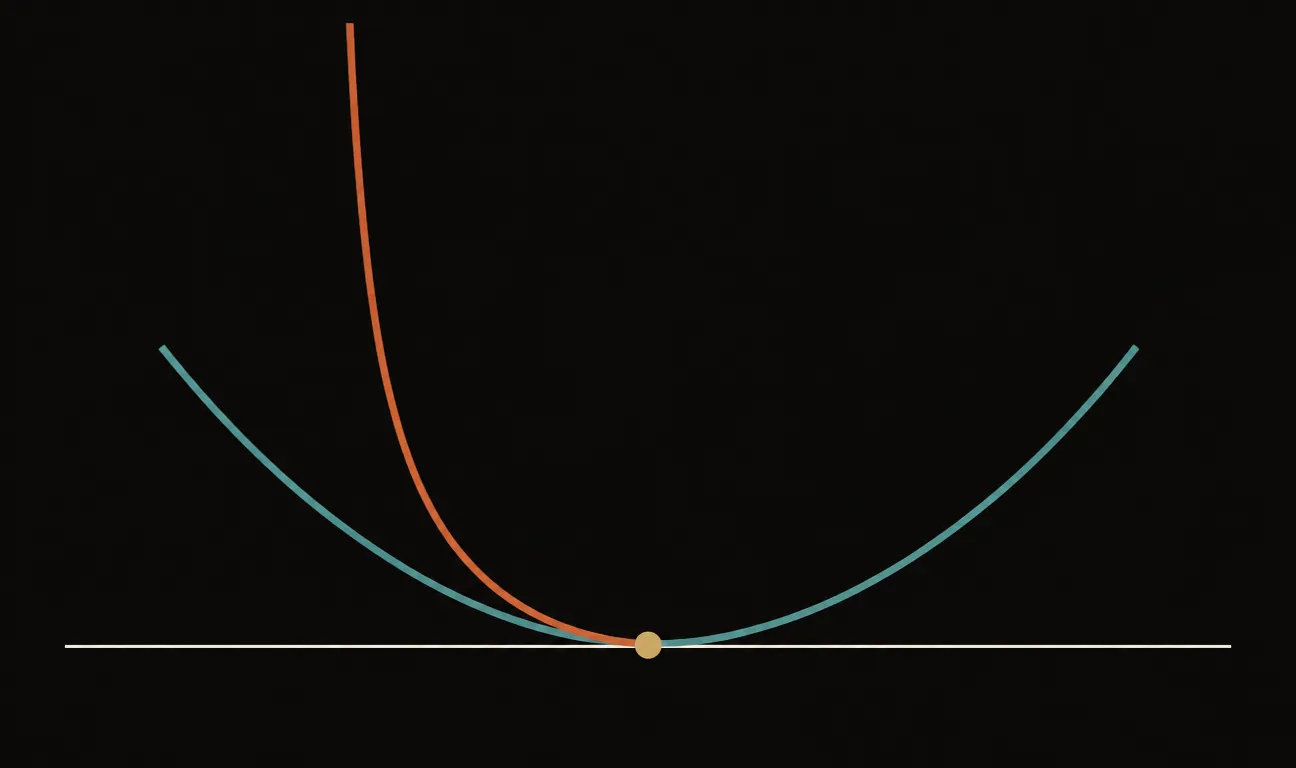
Due modi di punire l’errore. A sinistra l’MSE: una parabola che cresce col quadrato dello scarto, simmetrica attorno allo zero. A destra la cross-entropy: quasi nulla quando il modello assegna alta probabilità alla classe corretta, ma divergente verso l’infinito quando la sicurezza è malriposta.
Perché non usare l’MSE per classificare
Verrebbe da chiedersi: non si potrebbe usare l’MSE anche per la classificazione, trattando le probabilità come numeri qualunque? Si può, ma funziona male, e il motivo è istruttivo. Combinato con le funzioni sigmoide o softmax in uscita, l’MSE produce gradienti che si affievoliscono proprio quando il modello sbaglia con più convinzione: la curva è troppo piatta nelle zone in cui servirebbe la correzione più energica. La cross-entropy, per come si incastra matematicamente con la softmax, genera invece un gradiente proporzionale alla differenza tra probabilità prevista e verità: più l’errore è grave, più forte è lo strattone correttivo. È la differenza tra un maestro che alza la voce quando serve e uno che sussurra sempre allo stesso volume.
Ottimizziamo la misura, non l’obiettivo
C’è però una verità scomoda che nessuna formula elimina: la loss è quasi sempre un surrogato. Quello che ci interessa davvero — diagnosi corrette, utenti soddisfatti, traduzioni fedeli — raramente si lascia scrivere come funzione derivabile. Ottimizziamo ciò che possiamo misurare e speriamo che sia allineato con ciò che vogliamo.
Non sempre lo è. Un classificatore medico addestrato sulla pura accuratezza, con il 99 per cento di pazienti sani nel dataset, scopre presto la scorciatoia perfetta: dire sempre «sano» garantisce il 99 per cento di risposte corrette e zero utilità clinica. La correzione passa di nuovo dalla loss: pesare di più gli errori sulla classe rara, o usare funzioni pensate apposta per lo sbilanciamento, come la focal loss. È la legge di Goodhart applicata al machine learning: quando una misura diventa l’obiettivo, smette di essere una buona misura — e il modello è il più zelante degli esecutori.
Perché ti riguarda
Se lavori con modelli, la loss è il posto giusto dove guardare quando qualcosa non torna: un modello che «impara la cosa sbagliata» quasi sempre sta imparando esattamente quello che la loss gli chiede. E anche se i modelli li usi soltanto, questa lente rimane preziosa: ogni sistema di AI incorpora, nella sua funzione di costo, una definizione precisa e silenziosa di che cosa conta come errore e quanto. Chiedersi «che cosa minimizza davvero questo sistema?» è spesso il modo più rapido per capirne i comportamenti strani — e per prevedere dove sbaglierà la prossima volta.
I commenti sono riservati agli iscritti.
Accedi per commentare