
Nel paper che nel 2012 presentò AlexNet — la rete che vinse la competizione ImageNet e riaccese l’interesse mondiale per il deep learning — c’è un grafico poco appariscente, piazzato prima ancora dei risultati principali. Confronta due versioni della stessa rete: una con la funzione di attivazione tradizionale, la tangente iperbolica, e una con una funzione così semplice da sembrare uno scherzo, max(0, x). La seconda raggiunge lo stesso errore di addestramento circa sei volte più in fretta. Gli autori la chiamano ReLU e ci costruiscono sopra tutto il resto.
Perché serve una non linearità, e come si passa da sigmoide e tanh alla ReLU — gradienti che svaniscono compresi — è nel libro.
Quel grafico racconta una storia più grande di AlexNet: come una famiglia di funzioni eleganti e ben motivate abbia perso contro una spezzata di due segmenti, e perché quella sconfitta fosse scritta nella matematica dell’addestramento.
A che cosa serve «accendere» un neurone
Ogni neurone artificiale calcola una somma pesata dei suoi ingressi. Quella somma è un’operazione lineare, e le operazioni lineari hanno un difetto fatale: comporle non produce nulla di nuovo. Una catena di trasformazioni lineari, lunga quanto vuoi, equivale sempre a un’unica trasformazione lineare — come sommare tra loro tante rette: ottieni ancora una retta. Una rete a cento strati puramente lineari ha esattamente la stessa capacità di una a uno strato.
La funzione di attivazione è il gesto che rompe questa linearità: dopo la somma pesata, il risultato passa attraverso una curva non lineare, e solo allora prosegue verso lo strato successivo. È il pizzico di lievito nell’impasto: senza, puoi impilare tutta la farina che vuoi, ma la struttura non cresce. Con la non linearità, ogni strato aggiunge davvero potere espressivo, e la profondità comincia a contare.
La sigmoide: elegante, biologica, problematica
Per decenni la scelta di default è stata la sigmoide: una S morbida che schiaccia qualunque numero nell’intervallo tra 0 e 1. Le ragioni erano buone. Ricorda la frequenza di scarica di un neurone biologico, che non può essere negativa né infinita. Il suo output si legge come una probabilità. Ed è derivabile ovunque, con una derivata che si scrive in modo compatto: proprietà preziosa, perché l’addestramento per retropropagazione è fatto di derivate.
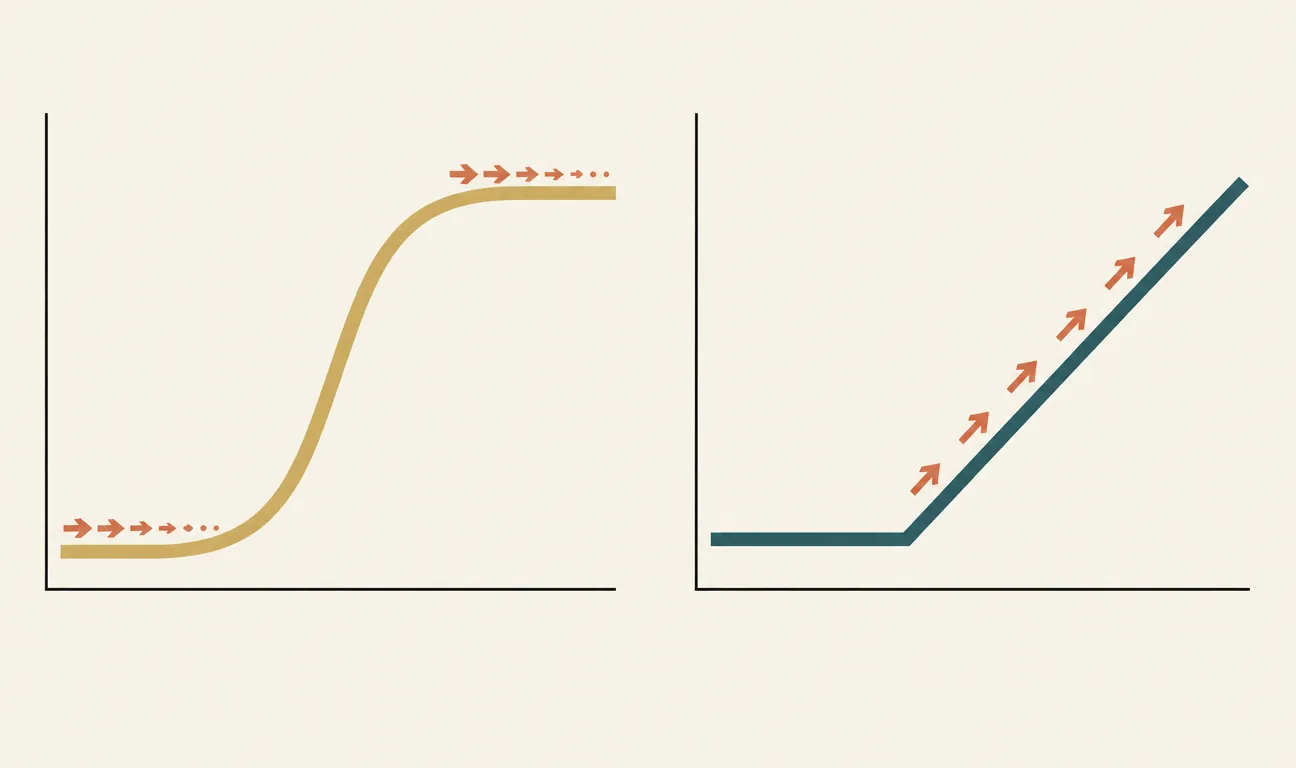
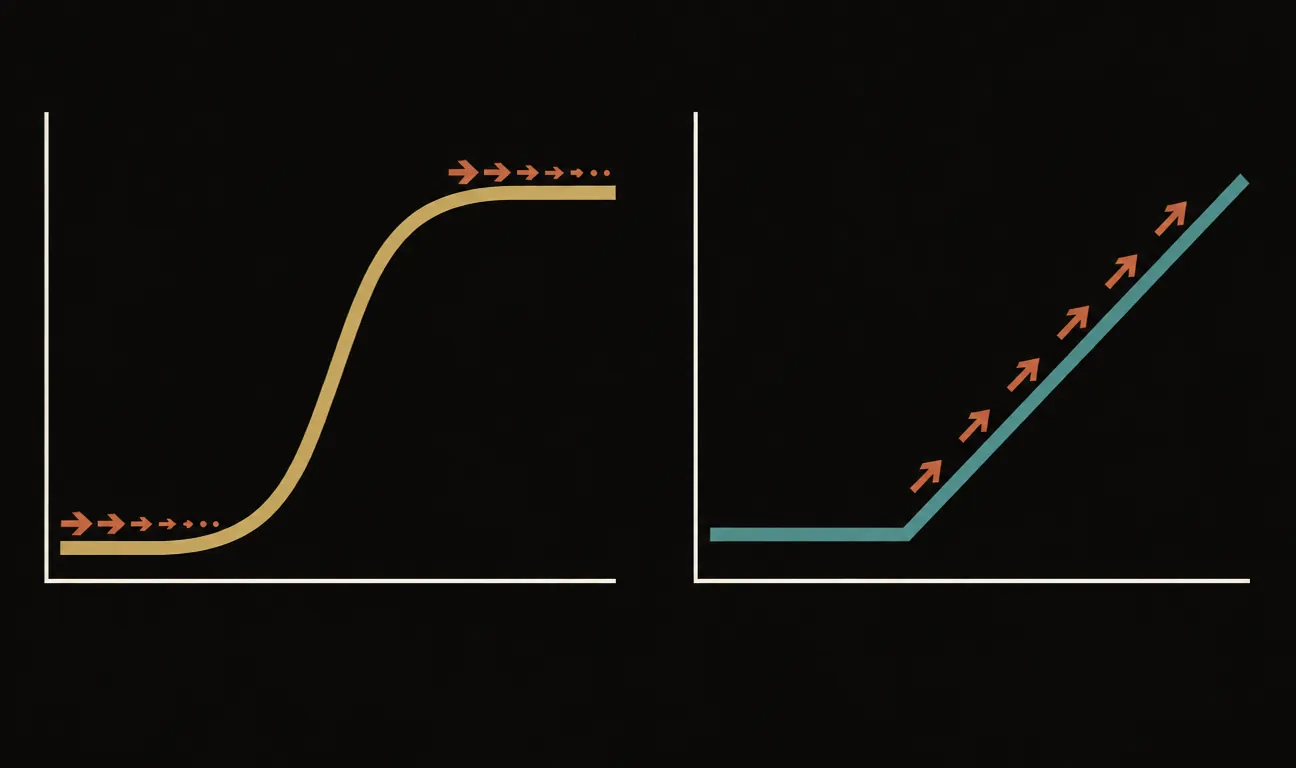
Il problema è nascosto nelle code della S. Lontano dallo zero, la sigmoide diventa piatta: input molto positivi finiscono tutti vicino a 1, input molto negativi tutti vicino a 0. Si dice che il neurone satura. E dove la curva è piatta, la derivata è quasi nulla.
Durante l’addestramento, il segnale di errore risale la rete moltiplicandosi, strato dopo strato, per queste derivate. È un telefono senza fili in cui ogni passaggio sussurra un po’ più piano: con derivate al massimo di 0,25 — e spesso molto minori — dopo pochi strati il messaggio è impercettibile. È il vanishing gradient: gli strati profondi ricevono correzioni così deboli che, in pratica, smettono di imparare. Più la rete è profonda, più il fenomeno morde. La sigmoide, perfetta per reti basse, era una zavorra proprio nella direzione in cui il campo voleva andare.
Tanh: una correzione di rotta
La tangente iperbolica è una sigmoide riscalata: stessa forma a S, ma output tra −1 e 1, centrato sullo zero. Sembra un dettaglio e invece aiuta: se un’attivazione emette solo valori positivi, come la sigmoide, spinge sistematicamente le somme dello strato successivo da una parte, e la discesa del gradiente procede a zig-zag. Con output centrati sullo zero l’addestramento è più stabile, e per anni la tanh è stata la raccomandazione standard. Ma le code piatte sono rimaste tali: la saturazione, e con lei il gradiente evanescente, non erano risolte. Era la stessa medicina con un dosaggio migliore.
Curve a confronto: sigmoide e tanh si appiattiscono alle estremità (dove il gradiente si spegne), la ReLU è nulla per input negativi e cresce indefinitamente per quelli positivi, con pendenza costante.
ReLU: la scorciatoia che ha vinto
La ReLU — rectified linear unit — fa questo: se l’input è negativo restituisce zero, altrimenti lo lascia passare invariato. max(0, x), fine. Niente esponenziali da calcolare, niente curve: due segmenti di retta incollati nell’origine.
Eppure risolve il problema giusto. Per tutti gli input positivi la pendenza è costante e pari a 1: il gradiente attraversa il neurone senza attenuarsi, per quanti strati debba risalire. Il telefono senza fili smette di sussurrare. In più è quasi gratuita da calcolare — un confronto con zero, contro l’esponenziale della sigmoide — e produce attivazioni sparse: in ogni momento una parte dei neuroni emette esattamente zero, e la rete lavora con rappresentazioni più asciutte.
La storia delle funzioni di attivazione è la storia di un compromesso: quanta eleganza matematica siamo disposti a sacrificare in cambio di gradienti che arrivano a destinazione.
Il prezzo esiste, e ha un nome evocativo: dying ReLU. Se durante l’addestramento un neurone finisce per ricevere sempre input negativi, il suo output è sempre zero — e zero è anche il suo gradiente. Nessun segnale di correzione lo raggiunge più: è morto, e non c’è modo di rianimarlo. Con learning rate aggressivi, una frazione non trascurabile della rete può spegnersi così. Non è un difetto teorico raffinato come il vanishing gradient: è un guasto meccanico, brutale, che però si gestisce con inizializzazioni e learning rate ragionevoli.
Dopo la ReLU: rattoppi e raffinamenti
Le varianti nate dopo sono, in gran parte, risposte al neurone morto. La Leaky ReLU concede agli input negativi una piccola pendenza invece dello zero secco, così il gradiente non si azzera mai del tutto. ELU e softplus ammorbidiscono il gomito nell’origine. La GELU — oggi standard nei transformer, da BERT ai modelli GPT — pesa l’input con la probabilità di tenerlo, ottenendo una curva liscia che vicino allo zero sfuma invece di scattare.
È giusto dire, però, che nessuna variante ha ripetuto il salto del 2012. Il grosso del guadagno stava nel passaggio dalle curve saturanti alla rettificazione; il resto sono percentuali, importanti su modelli da miliardi di parametri ma non decisive. La lezione di fondo è rimasta quella: nella scelta di un’attivazione, il comportamento del gradiente conta più della bellezza della formula.
Perché ti riguarda
Se addestri modelli, la funzione di attivazione è una di quelle scelte che fai una volta e poi dimentichi — finché qualcosa non va storto. Una loss che non scende su una rete profonda, neuroni che si spengono in blocco, un addestramento che diverge al primo learning rate ambizioso: sono tutti sintomi che si leggono meglio conoscendo questa storia. E se i modelli li usi soltanto, c’è comunque una morale che vale oltre il deep learning: la soluzione più sofisticata non è detto sia quella che funziona su larga scala. Tra una curva elegante con una teoria alle spalle e una spezzata di due segmenti che lascia passare il segnale, il campo ha scelto la spezzata. Non per anti-intellettualismo: perché l’addestramento è un fenomeno idraulico, fatto di segnali che devono scorrere, e vince ciò che non li strozza.
I commenti sono riservati agli iscritti.
Accedi per commentare