
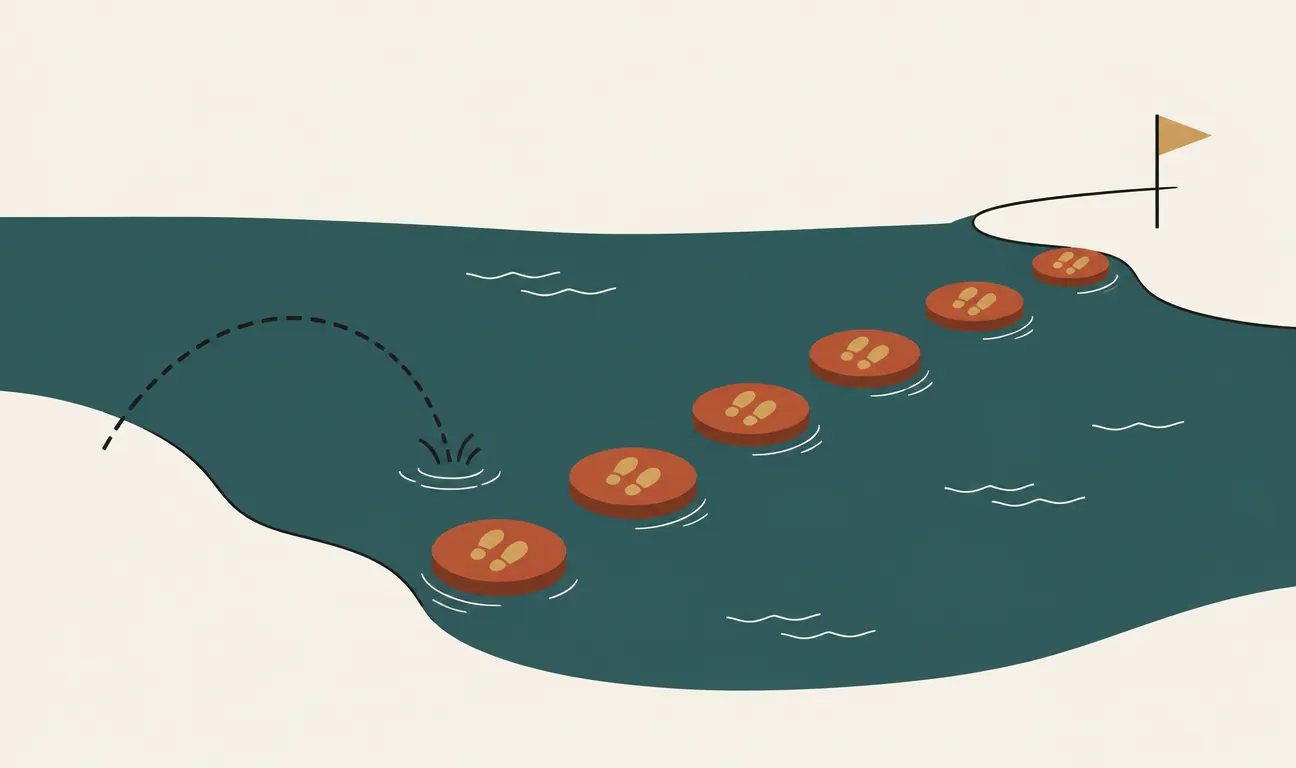
Prendi un modello linguistico e chiedigli, di getto, quanto fa 17 × 28. Costringilo a rispondere con un numero e basta: sbaglia più spesso di quanto sembri ragionevole per una macchina che ha letto mezzo internet. Poi riformula la richiesta con tre parole in più — ragiona passo per passo — e guarda cosa succede. Il modello scrive «17 × 28 = 17 × 20 + 17 × 8 = 340 + 136 = 476», e arriva alla risposta giusta. Non ha imparato niente di nuovo nel frattempo. È lo stesso modello, con gli stessi pesi, un secondo dopo. È cambiato solo il modo in cui gli abbiamo chiesto di rispondere.
L’anatomia di un prompt, le manopole del campionamento, zero/few-shot e la chain-of-thought sono nel libro.
Leggi «Prompt engineering: il singolo messaggio» nel libro →
Questo trucco ha un nome — chain-of-thought, catena di pensiero — ed è una delle scoperte più curiose sui modelli linguistici degli ultimi anni. Curiosa perché è banale da usare e per niente banale da spiegare. Vale la pena capire perché funziona, perché non è sempre quello che sembra, e perché nel frattempo è diventato il cuore di un’intera nuova generazione di modelli.
Un modello che scrive per pensare
Per capire il fenomeno bisogna ricordare come un modello linguistico produce testo: un token alla volta, da sinistra a destra, e ogni token viene scelto guardando tutti quelli venuti prima. Il punto cruciale è che per ogni singolo token il modello ha a disposizione una quantità fissa di calcolo — un numero fisso di strati da attraversare. Non può «pensare più a lungo» prima di sputare fuori la parola successiva: il tempo di riflessione per token è cablato nell’architettura.
Ora immagina di dover moltiplicare 17 × 28 a mente, senza carta, e di dover dire il risultato entro mezzo secondo. Anche una persona sveglia inciampa. Dai a quella stessa persona un foglio e la libertà di scrivere i passaggi intermedi, e il problema diventa facile. Non è diventata più intelligente: ha spostato una parte del ragionamento fuori dalla testa, sul foglio, dove può appoggiarsi a un passaggio prima di fare il successivo.
La catena di pensiero è esattamente quel foglio. Ogni parola che il modello scrive rientra nel contesto e diventa input per la parola dopo. Scrivere «340» non è solo comunicare un numero al lettore: è depositare un risultato intermedio su cui i token successivi potranno appoggiarsi. Il testo generato diventa una memoria di lavoro esterna, un quaderno di brutta copia che il modello si costruisce da solo mentre procede.
Stessa domanda, due percorsi. A sinistra il modello deve produrre il risultato in un colpo solo e tira a indovinare. A destra ogni passaggio intermedio, una volta scritto, diventa un appiglio per il successivo.
Più token, più calcolo
C’è un secondo modo di guardare la stessa cosa, più tecnico ma illuminante. Un modello che risponde «476» e basta ha speso il calcolo di un pugno di token per un problema che ne richiederebbe di più. Un modello che scrive tutta la catena spende il calcolo di decine di token: attraversa i suoi strati non una volta ma molte volte, e ogni passaggio può costruire sul precedente.
In gergo si dice che la catena di pensiero aumenta il calcolo seriale a disposizione. È la differenza tra chiedere una risposta immediata e concedere tempo per pensarci su — solo che per un modello «pensare più a lungo» significa letteralmente «scrivere più testo intermedio». I token non sono soltanto la risposta: sono anche il ragionamento, e più ragionamento c’è, più profondo può essere il calcolo. Questa intuizione, come vedremo, è la chiave dei modelli di ragionamento più recenti.
Un dettaglio che ha sorpreso tutti: serve la scala
La catena di pensiero non ha sempre funzionato. Nei lavori che l’hanno resa popolare, verso il 2022, un’osservazione tornava insistente: sui modelli piccoli, chiedere di ragionare passo per passo non aiutava, e a volte peggiorava le cose. Il beneficio compariva solo oltre una certa dimensione del modello — un comportamento «emergente», che spuntava con la scala invece di crescere gradualmente.
La lettura più sobria è che un modello troppo piccolo non ha abbastanza competenza per generare passaggi intermedi corretti: allunga il brodo con passi sbagliati, e un ragionamento sbagliato porta a una conclusione sbagliata con più sicurezza di prima. Solo quando il modello è abbastanza capace da produrre passi mediamente affidabili, il quaderno di brutta copia diventa un vantaggio invece di una zavorra. La catena amplifica quello che c’è: se c’è competenza, la mette a frutto; se non c’è, amplifica anche l’errore.
Attenzione: la spiegazione non è sempre la ragione
Qui arriva la parte scomoda, quella che molti entusiasti saltano. È forte la tentazione di leggere la catena di pensiero come una finestra sul «vero ragionamento» del modello — di credere che quei passaggi siano il motivo per cui è arrivato alla risposta. Non è detto.
La catena di pensiero è testo che il modello genera insieme alla risposta, non necessariamente il processo che l’ha prodotta.
Diversi studi hanno mostrato casi in cui il ragionamento esposto non riflette i fattori che hanno davvero determinato la risposta. Se metti in fila degli esempi in cui la soluzione è sempre la lettera «A», il modello tende a rispondere «A» anche quando è sbagliato — e poi costruisce a posteriori una catena di pensiero che giustifica la «A», senza mai menzionare il vero motivo, cioè il pattern nascosto negli esempi. È come uno studente che ha copiato il risultato dal compagno e poi riempie il foglio di passaggi plausibili per far sembrare di averci pensato lui.
Questo ha una conseguenza pratica netta: la catena di pensiero è un ottimo strumento per migliorare le risposte, ma un pessimo strumento per fidarsi ciecamente del ragionamento come se fosse una confessione onesta. Un modello può ragionare in modo impeccabile e sbagliare, o arrivare alla risposta giusta per la strada storta. Il ragionamento va verificato, non venerato.
Da trucco a architettura
Fino a poco fa la catena di pensiero era una cosa che chiedevi tu, nel prompt. La generazione più recente di modelli — quelli venduti come «di ragionamento» — ha fatto un passo oltre: invece di aspettare che l’utente scriva «pensa passo per passo», questi modelli sono addestrati a generare da soli una lunga catena interna prima di rispondere, spesso nascosta all’utente. La strategia, imparata attraverso un addestramento per rinforzo che premia le risposte corrette, è: prima produci molto ragionamento, poi concludi.
È lo stesso principio del quaderno di brutta copia, portato al livello dell’architettura del prodotto. E porta con sé un compromesso concreto: più token di ragionamento significano risposte migliori sui problemi difficili, ma anche più tempo di attesa e più costo per ogni domanda. Pensare più a lungo si paga — in secondi e in centesimi. Per una moltiplicazione non serve; per un problema di logica in più passaggi, spesso sì.
Perché ti riguarda
Se usi un modello linguistico per qualcosa di più di una battuta, la catena di pensiero è la leva più economica che hai. Su un compito che richiede più passaggi — un calcolo, una deduzione, una pianificazione — chiedere esplicitamente di ragionare prima di concludere è spesso la differenza tra una risposta a caso e una corretta, e non costa nulla provarci. Sui modelli di ragionamento moderni questo avviene già dietro le quinte, ma il principio da tenere a mente è lo stesso: dai al modello lo spazio per pensare a voce alta prima di pretendere la conclusione.
E se qualcuno ti mostra la catena di pensiero di un modello come prova che «ha capito davvero», tieni la mano sul portafoglio. Quei passaggi migliorano le risposte, ma non sono un verbale fedele di cosa succede dentro il modello. La lezione più utile è anche la più umana: scrivere aiuta a pensare, ma un ragionamento scritto bene non è ancora un ragionamento giusto. Vale per le macchine quanto per noi.
I commenti sono riservati agli iscritti.
Accedi per commentare