
Scrivi la firma di una funzione e un commento che spiega cosa deve fare — «restituisci la lista dei numeri primi minori di n» — poi ti fermi. Un istante dopo, sotto il commento, compare il corpo: un ciclo, un test di primalità, un return. Non l’hai scritto tu. L’ha proposto un modello che ha letto una quantità enorme di codice altrui e ha imparato a continuare il tuo. È il gesto quotidiano di chiunque oggi usi un assistente di programmazione, e la sua prima descrizione sistematica sta in un articolo del 2021 firmato da Mark Chen, Jerry Tworek e altri ricercatori di OpenAI: Evaluating Large Language Models Trained on Code. Il modello si chiama Codex, ed è la tecnologia che di lì a poco avrebbe alimentato GitHub Copilot.
Da GPT al codice: cosa cambia davvero
Codex non è un’architettura nuova. È un modello GPT — lo stesso tipo di rete che completa il testo prevedendo il token successivo — a cui è stata data una dieta diversa: grandi quantità di codice sorgente pubblico raccolto da GitHub, in aggiunta al linguaggio naturale. L’analogia più onesta è quella di un traduttore madrelingua che passa qualche anno a leggere solo manuali tecnici e repository: la grammatica di base non cambia, ma il vocabolario e le convenzioni sì. Il modello impara che dopo def viene un nome, che una parentesi aperta va chiusa, che un docstring descrive ciò che segue.
Il punto interessante è che il codice è un dominio strano per un modello linguistico. Da un lato è più rigido del linguaggio naturale: una virgola fuori posto e il programma non gira. Dall’altro è profondamente ambiguo, perché la stessa specifica in parole ammette infinite implementazioni corrette. Codex vive in questa tensione: continua un testo come farebbe con la prosa, ma quel testo, per essere utile, deve anche funzionare.
HumanEval: misurare se il codice gira, non se sembra giusto
Qui arriva il contributo che, a distanza di anni, è invecchiato meglio del modello stesso. Come si valuta il codice generato? La tentazione facile è confrontarlo con una soluzione di riferimento, carattere per carattere, come si fa con la traduzione automatica. Ma due programmi possono essere scritti in modo completamente diverso e fare esattamente la stessa cosa. Confrontare il testo è la domanda sbagliata.
Gli autori propongono invece la correttezza funzionale: si esegue il codice generato e si guarda se supera una batteria di test. Per farlo pubblicano HumanEval, un insieme di 164 problemi di programmazione scritti a mano, ciascuno con una firma di funzione, un docstring che descrive il compito in inglese, una soluzione canonica e in media 7,7 test unitari. Il metro non è «il codice assomiglia alla soluzione?» ma «il codice passa i test?».
La domanda non è se il programma sembri corretto a un lettore umano, ma se sopravviva all’esecuzione. È un cambio di metro che sposta tutto il resto.
Da questa scelta nasce anche la metrica che avreste poi incontrato ovunque: pass@k. Si lascia il modello generare k tentativi per ogni problema, e il problema conta come risolto se almeno uno dei k supera tutti i test. Gli autori stimano questo valore campionando molte soluzioni e correggendo la stima per non gonfiarla — un dettaglio statistico che sembra pignolo ma evita di dichiarare capacità che il modello non ha in modo affidabile.
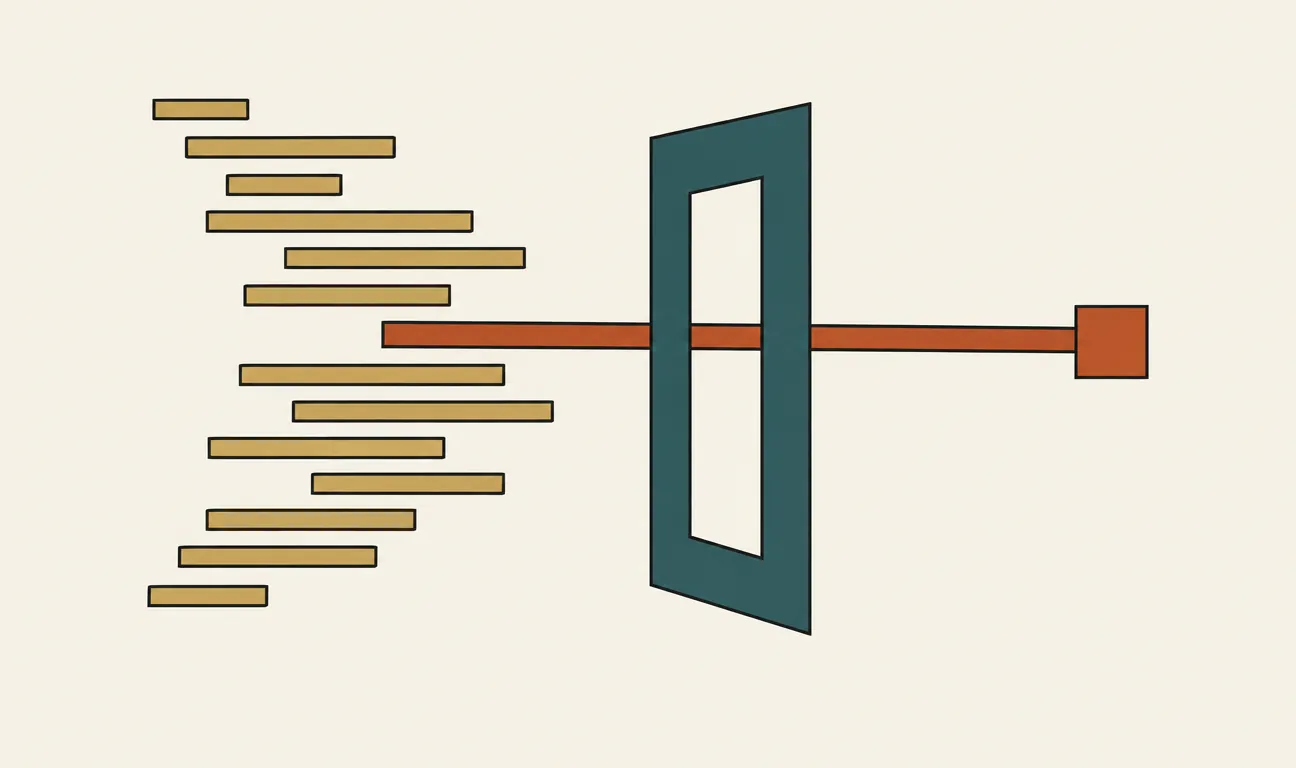
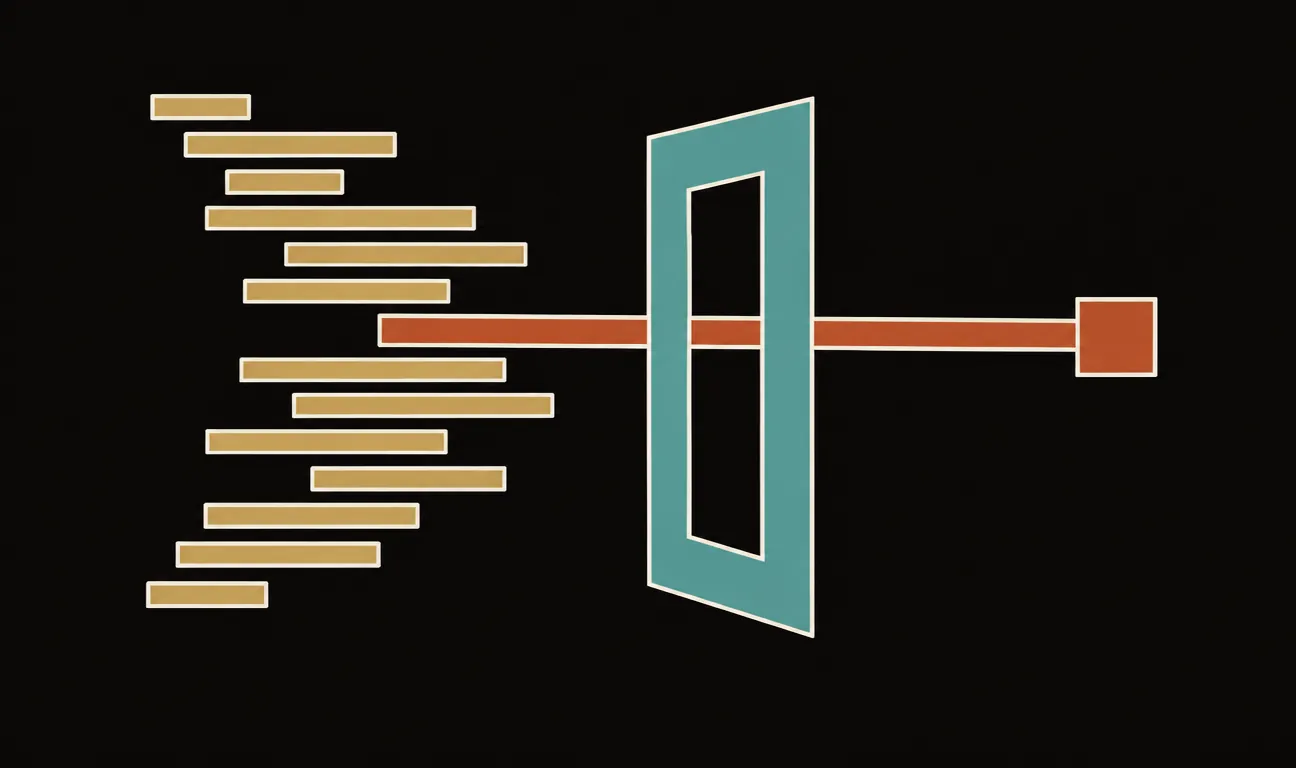
Lo schema: dalla descrizione al programma verificato
Vale la pena fissare il flusso. A sinistra la descrizione in parole, al centro il modello, a destra il codice — che però non è la fine del percorso: viene eseguito contro i test, e solo lì si decide se conta.
Dalla specifica in parole al programma verificato: il codice generato non è la meta, lo è il suo superare i test. È questa esecuzione a definire la correttezza, non la somiglianza con una soluzione di riferimento.
Il numero che conta: 28,8%
Sul benchmark HumanEval, Codex risolve il 28,8% dei problemi al primo tentativo (pass@1). Per dare un’idea del salto: GPT-3, che non aveva ricevuto quella dieta di codice, risolve lo 0% degli stessi problemi, mentre GPT-J, un modello aperto dell’epoca, si ferma all’11,4%. La specializzazione sul codice, insomma, non è un dettaglio: è ciò che rende il modello anche solo utilizzabile.
C’è però un secondo numero, più suggestivo. Se invece di un solo tentativo si lascia il modello generare 100 candidati per problema, e si conta risolto ogni problema in cui almeno uno dei cento funziona, la percentuale sale al 70,2%. È un risultato ambivalente, e gli autori lo trattano con onestà: il modello sa produrre la soluzione giusta molto più spesso di quanto sappia produrla al primo colpo. Il collo di bottiglia non è la conoscenza, ma la selezione. Generare tanto e poi filtrare — con i test, o con un modello che ordina i candidati — diventa una strategia di prima classe. È lo stesso schema «genera e verifica» che oggi ritroviamo negli agenti di programmazione.
Quello che il paper non nasconde
La parte dell’articolo che vale la pena leggere per intero è quella sui limiti, insolitamente franca per un lavoro che presenta un prodotto. Gli autori misurano il disallineamento: Codex a volte produce codice che sembra rispondere alla richiesta ma è sottilmente sbagliato, e più il prompt contiene errori sottili, più il modello tende a imitarli invece di correggerli — perché ha imparato a continuare il testo, non a giudicarlo. Segnalano che può generare codice insicuro, riprodurre bias presenti nei dati di addestramento, ed essere inefficiente nell’uso dei campioni. Dedicano una sezione agli effetti economici e alla sicurezza: chi genera codice a comando genera anche codice malevolo a comando.
Nessuna di queste osservazioni ha fermato l’adozione — Copilot è arrivato lo stesso — ma averle messe nero su bianco nel documento fondativo ha dato al campo un vocabolario per discuterne. È il tipo di onestà intellettuale che rende un paper utile anche quando i suoi numeri sono superati.
Perché riguarda anche te
Se scrivi codice, con ogni probabilità usi già un discendente diretto di Codex, e capire come è stato valutato ti dà una lente per usarlo meglio. Il 28,8% al primo tentativo contro il 70,2% su cento tentativi spiega perché conviene chiedere più varianti e sceglierne una, invece di fidarti della prima. La correttezza funzionale spiega perché i test — quelli veri, che eseguono il codice — restano la tua difesa migliore: sono esattamente il metro con cui questi modelli vengono giudicati, e l’unico che non si lascia ingannare da un programma che «sembra giusto». E il disallineamento spiega perché un prompt confuso produce codice confuso: il modello continua ciò che gli dai, comprese le tue imprecisioni. Codex, in fondo, non ha risolto la programmazione. Ha reso misurabile quanto una macchina sappia scriverla — e questo, per chi vuole controllarla anziché subirla, è il punto di partenza giusto.
Il paper
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan e altri, Evaluating Large Language Models Trained on Code, OpenAI, 2021. Disponibile su arXiv: arxiv.org/abs/2107.03374. Il benchmark HumanEval è rilasciato pubblicamente come parte del lavoro.
I commenti sono riservati agli iscritti.
Accedi per commentare