
Provate a chiedere a un assistente linguistico come si costruisce una bomba. Se è stato addestrato male, avete due esiti entrambi mediocri: risponde davvero, oppure si chiude in un «non posso aiutarti» muto e paternalistico che non spiega niente. Rendere un modello innocuo senza renderlo anche inutile o evasivo è uno dei problemi centrali dell’allineamento. E fino al 2022 il modo standard per affrontarlo aveva un costo nascosto: persone in carne e ossa che leggevano migliaia di risposte tossiche per etichettarle una a una.
Il problema dell’allineamento, come si allineano gli LLM, come se ne valuta la sicurezza e chi fa le regole: nel libro.
Leggi «Allineamento e governance: dai valori umani alle regole» nel libro →
Il paper Constitutional AI: Harmlessness from AI Feedback, pubblicato da un gruppo di Anthropic guidato da Yuntao Bai e Jared Kaplan nel dicembre 2022, propone un modo per togliere gli esseri umani da quel ciclo. L’idea, riassunta in una riga: invece di mostrare al modello migliaia di esempi etichettati a mano, gli si dà una breve lista di principi scritti in linguaggio naturale — una «costituzione» — e lo si mette a giudicare e correggere sé stesso alla luce di quei principi.
Il problema con l’etichetta umana
La tecnica dominante per allineare un assistente si chiama RLHF, apprendimento per rinforzo da feedback umano. Nella parte che riguarda l’innocuità funziona così: si generano coppie di risposte, degli annotatori indicano quale delle due è meno dannosa, e da queste preferenze si addestra un «modello di ricompensa» che poi guida il modello vero.
Funziona, ma ha due debolezze. La prima è di scala: ogni volta che cambiano le regole o si scopre un nuovo modo di aggirarle, servono nuove etichette umane. La seconda è più scomoda da dire ad alta voce: per insegnare a un modello a riconoscere il contenuto tossico, qualcuno deve prima leggerne a tonnellate. Delegare a delle persone il compito di immergersi in ciò che di peggio un modello sa produrre non è un dettaglio operativo, è un problema etico e pratico insieme. Constitutional AI nasce da questa doppia frustrazione.
La costituzione: mettere le regole nero su bianco
Il cuore del metodo è banale e per questo interessante: le regole di comportamento non restano implicite dentro migliaia di esempi, ma vengono scritte esplicitamente come una lista di principi in linguaggio naturale. Frasi del tipo «scegli la risposta meno dannosa e meno tossica», oppure «preferisci la risposta che scoraggia comportamenti illegali senza fare la morale». Poche righe, leggibili, discutibili, modificabili.
È un cambiamento di prospettiva più profondo di quanto sembri. In RLHF classico i valori del modello vivono sparsi in un dataset opaco: se volete sapere perché rifiuta una certa richiesta, non c’è un documento da consultare, solo statistiche. Con una costituzione, invece, i criteri sono un testo che un redattore o un giurista possono leggere e criticare. L’analogia più onesta è il codice di condotta di una redazione: non elimina il giudizio, ma lo rende ispezionabile.
Fase uno: il modello che si corregge da solo
La costituzione entra in gioco in due fasi. La prima è supervisionata. Si parte da un modello già addestrato a essere utile e gli si pongono apposta domande scomode — le stesse che un «red team» userebbe per farlo scivolare. Il modello, all’inizio, risponde spesso in modo problematico.
A questo punto scatta il meccanismo: al modello si chiede di criticare la propria risposta alla luce di un principio estratto a caso dalla costituzione («questa risposta viola il principio X? in che modo?»), e poi di riscriverla per rimuovere il problema. Il processo si può ripetere più volte, come un autore che rilegge la propria bozza con in mano una guida di stile e la sistema paragrafo per paragrafo. Alla fine si prendono solo le risposte rivedute e ci si riaddestra sopra il modello. Il risultato è un assistente che già parte molto più prudente, avendo imparato dalle correzioni prodotte da sé stesso.
Fase due: il giudice è un altro modello (RLAIF)
La seconda fase sostituisce l’annotatore umano nel giudizio di preferenza. Per ogni domanda si generano più risposte, e non è una persona a dire quale è migliore: è un modello che le confronta chiedendosi quale rispetta meglio un principio della costituzione. Da queste preferenze generate dall’AI si addestra il modello di ricompensa, e da lì si procede con l’apprendimento per rinforzo come nel RLHF tradizionale. Gli autori chiamano questo passaggio RLAIF — apprendimento per rinforzo da feedback dell’AI.
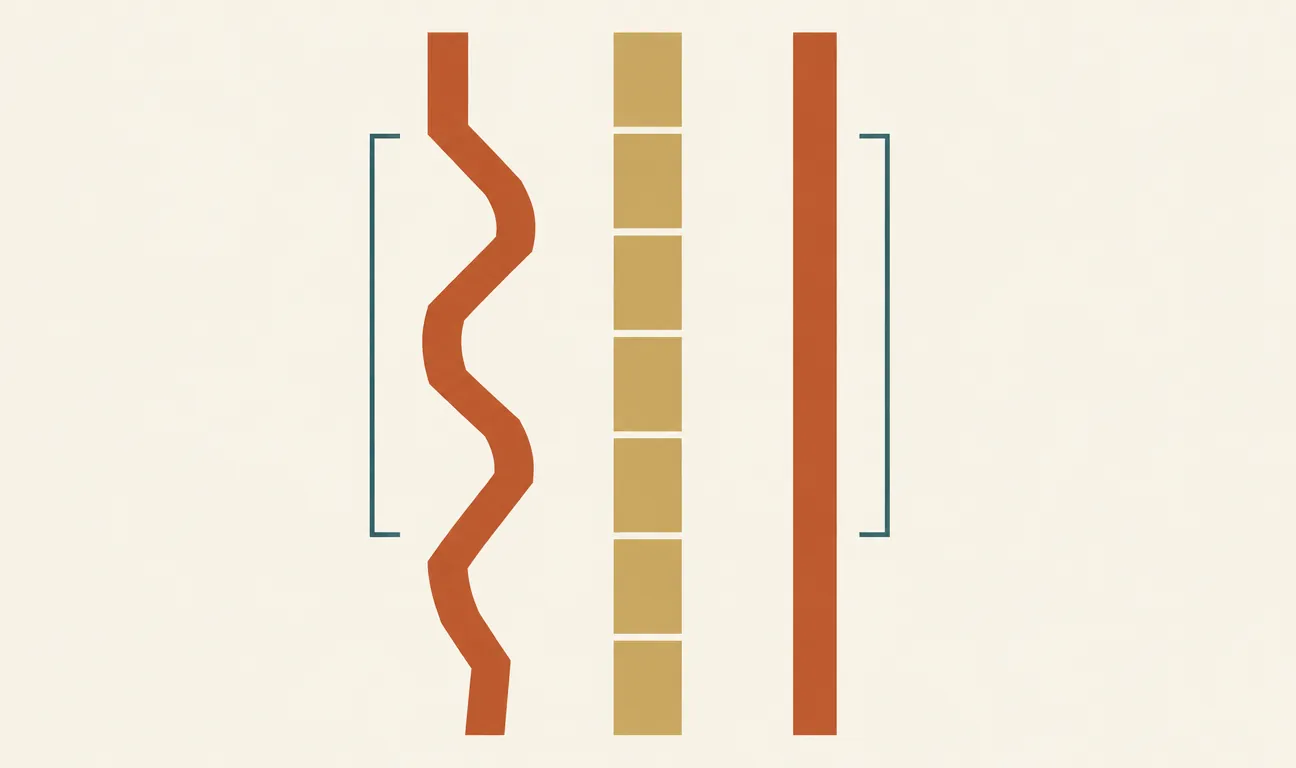
Il ciclo di Constitutional AI. Una lista di principi (in ocra) alimenta il modello, che critica la propria risposta iniziale e la riscrive: la versione riveduta diventa il feedback su cui il modello si riaddestra. Nella fase supervisionata l’umano non etichetta contenuti dannosi; scrive solo i principi.
Un ingrediente tecnico rende il tutto più solido: prima di esprimere il giudizio, al modello valutatore si chiede di ragionare passo passo — la cosiddetta catena di ragionamento — spiegando perché una risposta rispetta o viola il principio. Non è cosmesi: esplicitare il ragionamento tende a rendere le valutazioni più coerenti e, non secondario, lascia una traccia leggibile di come è stata presa la decisione.
Il contributo di Constitutional AI non è un modello più buono: è spostare le regole da un dataset opaco a un testo che si può leggere, discutere e correggere.
Cosa promette e cosa no
Vale la pena essere precisi su cosa il paper rivendica. La supervisione umana non sparisce del tutto: gli autori tolgono le etichette umane sull’innocuità, non tutto il feedback umano — la parte che riguarda l’utilità del modello continua a poggiare su preferenze raccolte da persone. Il risultato dichiarato è un assistente al tempo stesso meno dannoso e meno evasivo: invece di rifiutare in silenzio, tende a spiegare le proprie obiezioni a una richiesta problematica. È una differenza di tono che chiunque abbia usato un chatbot troppo timido apprezza subito.
E i limiti sono altrettanto onesti. Un modello che giudica sé stesso può ereditare i propri punti ciechi: se la costituzione tace su un tema, o è ambigua, l’AI non ha nessun umano che la corregga in quel punto. Spostare le regole in un testo esplicito è un guadagno di trasparenza enorme, ma sposta anche la responsabilità: adesso conta moltissimo chi scrive la costituzione e cosa ci mette. Il metodo non risolve la domanda «quali valori», la rende solo visibile.
Perché vi riguarda
Constitutional AI è la tecnica alla base delle prime versioni di Claude, e da allora l’idea di «governare un modello con un documento di principi» è diventata parte del vocabolario comune dell’allineamento. Ma il motivo per cui conviene conoscerla va oltre un singolo prodotto. Ci dice che le regole di comportamento di un sistema di AI non devono per forza restare sepolte in pesi e dataset: possono essere scritte, pubblicate, criticate come qualsiasi altro testo normativo. In un momento in cui si discute di AI Act e di trasparenza, è una direzione che riguarda chiunque userà — o dovrà fidarsi di — questi modelli.
Il paper originale
Yuntao Bai et al., Constitutional AI: Harmlessness from AI Feedback, Anthropic, dicembre 2022. Disponibile su arXiv: arxiv.org/abs/2212.08073. Consigliata la lettura delle sezioni sul processo di critica-revisione e sull’elenco dei principi usati, riportato in appendice.
I commenti sono riservati agli iscritti.
Accedi per commentare