
In una rete addestrata a riconoscere immagini, i ricercatori isolano un singolo neurone e lo guardano lavorare. Si accende per i musi dei gatti. Ma anche per il frontale di certe automobili. E per le zampe, di nuovo, dei gatti. Tre cose che, per un ingegnere abituato a pensare in circuiti, non hanno nulla in comune. Non è un caso isolato: è la regola. La gran parte dei neuroni di una rete profonda risponde a un miscuglio di concetti che non c’entrano niente tra loro. Per anni questo è stato un imbarazzo per chi vuole capire come i modelli decidono. Nel settembre 2022 un gruppo di Anthropic pubblica Toy Models of Superposition, un lavoro che prova a spiegare il fenomeno con la matematica di reti minuscole — e a dire cosa possiamo farci.
Mappe di salienza, Grad-CAM, Integrated Gradients e l’interpretabilità meccanicistica sono nel libro.
Leggi «Dentro le reti profonde: attribuzione e interpretabilità meccanicistica» nel libro →
Un neurone che significa troppe cose
La speranza ingenua, quella con cui tutti partiamo, è che dentro una rete ci sia ordine: un neurone per «gatto», uno per «ruota», uno per «ironia». Se fosse così, ispezionare un modello sarebbe come leggere l’etichetta dei cassetti di uno schedario. Un neurone che rappresenta una cosa sola si dice monosemantico, e sarebbe il sogno di chiunque voglia verificare cosa un modello ha imparato.
La realtà è più scomoda. I neuroni reali sono polisemantici: lo stesso neurone partecipa a concetti che non hanno alcun legame apparente. Guardarne uno alla volta non spiega niente, perché ogni neurone è un condominio in cui abitano inquilini che non si conoscono. La domanda del paper è precisa: perché l’addestramento sceglie questa soluzione confusa invece di quella ordinata?
Un modello giocattolo per capire
La mossa metodologica è quella che dà il titolo al lavoro. Invece di aprire un modello vero — miliardi di parametri, impossibili da controllare — gli autori costruiscono reti minuscole di cui conoscono tutto. Decidono a tavolino quanti concetti (chiamiamoli feature) il modello deve gestire, quante dimensioni interne ha a disposizione per farlo, quanto è importante ciascuna feature e quanto spesso è presente. Poi addestrano la rete a comprimere e ricostruire questi concetti, e osservano cosa fa.
È il principio della galleria del vento: non si smonta un jumbo in volo per capire l’aerodinamica, si studia un modellino in scala in condizioni controllate. Il punto chiave è che qui si conosce la verità di partenza — quali concetti ci sono davvero — e quindi si può misurare esattamente come il modello li dispone dentro di sé.
La superposizione e il ruolo della sparsità
Il risultato centrale è che il comportamento del modello dipende da una variabile sola: quanto spesso i concetti sono attivi contemporaneamente. Quando le feature sono dense, cioè quasi sempre presenti, il modello può rappresentarne al massimo quante sono le sue dimensioni, sistemandole ordinatamente su assi separati e buttando via le meno importanti. Niente magia: se hai due assi, tieni le due cose che contano di più.
Quando invece le feature sono sparse, cioè rare e di rado attive nello stesso momento, succede qualcosa di diverso. Il modello ne stipa più di quante siano le dimensioni, assegnandole a direzioni che si sovrappongono parzialmente. Questa è la superposizione: più concetti che condividono lo stesso spazio, accettando di pestarsi i piedi ogni tanto.
Funziona per la stessa ragione per cui un ufficio con cento dipendenti se la cava con venti linee telefoniche: quasi mai chiamano tutti insieme.
Il modello sta facendo un calcolo di convenienza: tollerare una piccola interferenza — due concetti rari che, nel raro caso si accendano insieme, si disturbano — in cambio della capacità di rappresentarne molti di più. La polisemanticità dei neuroni non è disordine: è compressione ottimale, la stessa idea che in ingegneria dei segnali si chiama compressed sensing.
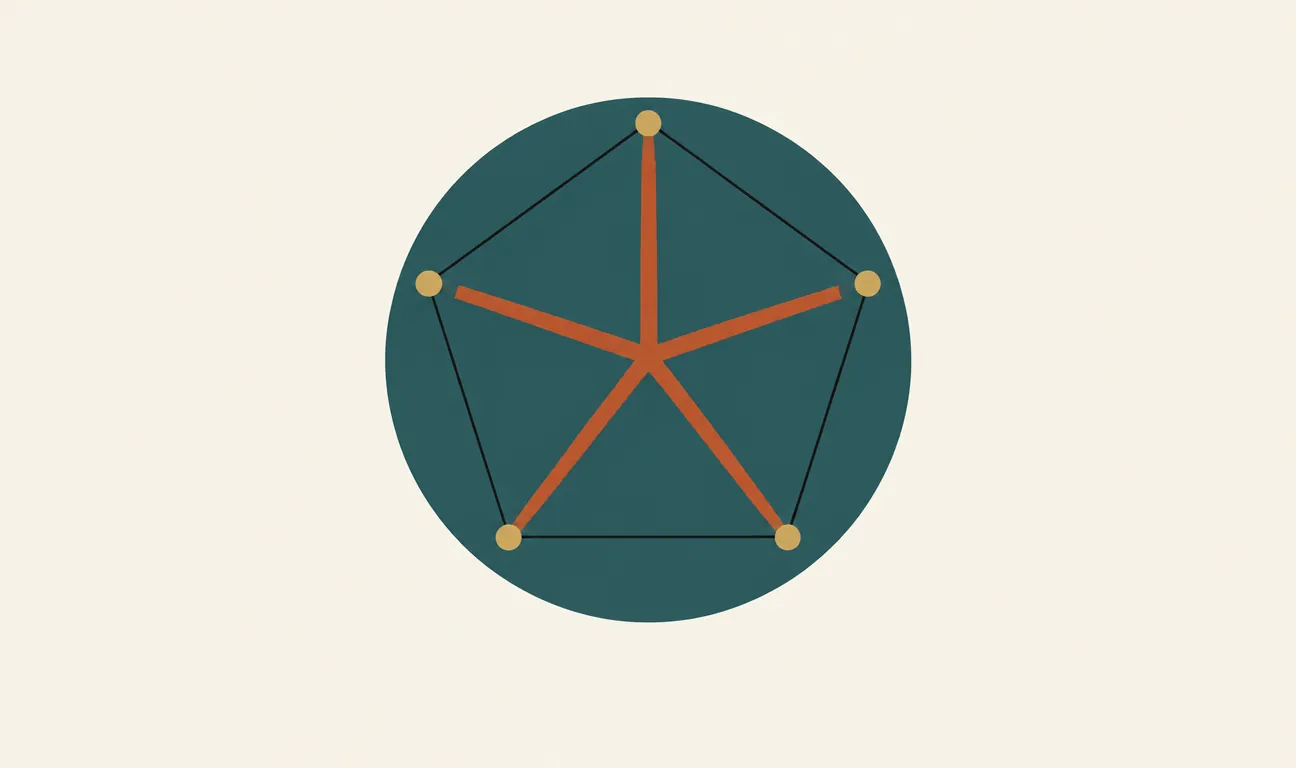
Con concetti densi, in due dimensioni ne entrano due, su assi ortogonali. Con concetti sparsi ne entrano di più, disposti ad angoli regolari che li tengono il più lontano possibile: è la superposizione.
La geometria dei concetti
La parte più elegante del paper riguarda come il modello dispone i concetti quando li sovrappone. Non a caso: le direzioni si distribuiscono per stare il più lontano possibile le une dalle altre, formando figure regolari — coppie contrapposte, triangoli, pentagoni, tetraedri. È lo stesso problema di come sistemare alcune cariche elettriche su una sfera perché si respingano al massimo, un rompicapo classico della fisica. I concetti, dentro la rete, si comportano come particelle che cercano equilibrio.
C’è anche un secondo fenomeno controintuitivo: il passaggio non è graduale. Al variare dell’importanza e della sparsità di una feature, il modello passa di scatto da «la ignoro del tutto» a «la rappresento da sola» a «la comprimo insieme ad altre». Sono transizioni di fase, come l’acqua che non si addensa piano ma a un certo punto gela di colpo. Piccoli cambiamenti nelle condizioni producono salti netti nel modo in cui il modello organizza la sua conoscenza.
Perché conta per la sicurezza
Qui il modellino da laboratorio dice qualcosa di serio sui sistemi veri. Se i neuroni sono polisemantici per costruzione — perché la superposizione è la strategia che l’addestramento trova conveniente — allora ispezionare un modello neurone per neurone è senza speranza per principio, non per pigrizia degli strumenti. Non stiamo guardando male: stiamo guardando la cosa sbagliata.
La conseguenza operativa è che, per leggere un modello, bisogna prima disfare la superposizione: ritrovare le direzioni vere, i concetti separati che il modello ha compresso. È esattamente il programma di ricerca che parte da qui e arriva agli sparse autoencoder — Towards Monosemanticity nel 2023 su un modello giocattolo, Scaling Monosemanticity nel 2024 su un modello di produzione. Toy Models è la teoria che spiega perché quegli strumenti sono necessari. Sul fronte sicurezza c’è anche un avvertimento: se comportamenti e capacità possono nascondersi nelle sovrapposizioni, un audit superficiale rischia di non vederli.
Cosa dice a chi legge
C’è una parte rassicurante e una inquietante, e sono la stessa. La ragione per cui un modello riesce a fare tantissimo con relativamente poco — comprimere migliaia di concetti in poche dimensioni — è la stessa ragione per cui è difficile leggerlo dall’interno. Ma difficile non vuol dire magico: la superposizione ha una matematica precisa e una geometria descrivibile. Sapere che dentro c’è compressione, e non caos, è il primo passo per costruire strumenti che la sappiano invertire. Ogni volta che sentite dire che i modelli sono «scatole nere per natura», tenete a mente che qualcuno, partendo da reti grandi come un foglio di calcolo, ha cominciato a smontare quella frase.
Per approfondire
Il paper: Elhage, Hume, Olsson et al. (Anthropic), Toy Models of Superposition, Transformer Circuits Thread, settembre 2022 — transformer-circuits.pub/2022/toy_model. Il seguito diretto è la linea di lavoro sugli sparse autoencoder: Towards Monosemanticity (2023) e Scaling Monosemanticity (2024), stessa collana.
I commenti sono riservati agli iscritti.
Accedi per commentare