
Il modello raggiunge il 94% di accuratezza. La cella del notebook lo conferma, il grafico della confusion matrix è pulito, il collega annuisce. Poi arriva la domanda che gela la stanza: «Ok, e adesso come lo usiamo?». Silenzio. Perché tra un notebook Jupyter che gira sul portatile e un servizio che risponde a richieste vere, ogni giorno, senza supervisione, c’è un fosso. Questo articolo racconta il ponte più corto per attraversarlo.
Il divario ricerca–produzione, i tre artefatti da versionare e il debito tecnico dei modelli stanno nel libro.
Il notebook è un laboratorio, non una fabbrica
Un notebook è pensato per esplorare: esegui le celle in ordine sparso, tieni variabili in memoria per ore, sovrascrivi risultati senza accorgertene. È il suo pregio in fase di ricerca e il suo difetto letale in produzione. Lo stato nascosto — quella variabile definita in una cella che hai poi cancellato — è il motivo per cui un notebook che «funziona» oggi può non rieseguirsi domani.
L’analogia utile è quella della cucina di casa contro la cucina di un ristorante. A casa assaggi, improvvisi, lasci le pentole dove capita. Un ristorante che serve duecento coperti a sera ha bisogno di ricette scritte, porzioni misurate e una brigata che replica lo stesso piatto in modo identico. Il piatto è lo stesso; il processo è un altro mestiere.
Il primo passo del percorso minimo è quindi banale ma non negoziabile: estrarre il codice dal notebook e trasformarlo in script Python ordinari, con funzioni pure, un punto di ingresso chiaro e zero stato implicito. Se lo script train.py non produce lo stesso modello a ogni esecuzione con gli stessi dati, il problema va risolto qui, non dopo.
Versionare tutto: codice, dati, modello
In produzione la domanda ricorrente non è «quanto è bravo il modello?» ma «quale modello sta rispondendo, addestrato su quali dati, con quale codice?». Senza una risposta precisa, ogni bug diventa un’indagine archeologica.
Il minimo indispensabile è a tre livelli. Il codice va su Git, ovviamente. I dati di training vanno congelati: basta uno snapshot con un hash o una data nel nome, non serve subito un sistema sofisticato. Il modello addestrato va salvato come artefatto con un identificativo che lega insieme le tre cose: commit del codice, versione dei dati, metriche ottenute. Un file JSON accanto al modello, con questi campi, è già un registro dei modelli in miniatura.
Un modello di cui non sai ricostruire la provenienza non è un asset: è un debito che ancora non ha presentato il conto.
Dal modello al servizio: un’API davanti a tutto
Il modello salvato su disco non serve a nessuno. Il modo standard per renderlo utilizzabile è incapsularlo dietro un’API HTTP: un piccolo servizio che riceve una richiesta con i dati di input e restituisce la predizione. In Python, FastAPI è diventato la scelta di default per questo compito: poche righe, validazione degli input inclusa, documentazione generata automaticamente.
Il punto architetturale importante è la separazione: il servizio di inferenza carica il modello una volta all’avvio e poi risponde alle richieste, senza mai riaddestrare nulla. Training e inferenza sono due programmi diversi, con cicli di vita diversi — il primo gira ogni tanto, il secondo sempre. Confonderli è l’errore più comune di chi arriva dal notebook, dove tutto convive nella stessa sessione.
Qui vale la pena resistere alla tentazione di aggiungere funzionalità. Niente code di messaggi, niente cache distribuite, niente autoscaling al primo giorno. Un endpoint /predict e un endpoint /health che dice «sono vivo» coprono il 90% dei casi iniziali.
Il container: stessa scatola ovunque
Il classico «sul mio computer funziona» ha una causa precisa: l’ambiente. Versioni di Python diverse, librerie di sistema mancanti, una dipendenza aggiornata nel frattempo. Docker risolve il problema impacchettando applicazione e ambiente in un’unica immagine: la stessa scatola sigillata gira identica sul portatile, sul server di staging e in produzione.
Per il percorso minimo basta un Dockerfile essenziale: immagine base Python, installazione delle dipendenze da un requirements.txt con versioni bloccate, copia del codice, comando di avvio del servizio. Il modello può stare dentro l’immagine (semplice, ma immagini pesanti) o essere scaricato all’avvio da uno storage esterno (più flessibile). Per iniziare, dentro l’immagine va benissimo.
Monitorare: il modello invecchia, il servizio no
Una volta in produzione, un software tradizionale o funziona o si rompe rumorosamente. Un modello di machine learning ha un terzo stato, più subdolo: continua a rispondere con sicurezza, ma le sue risposte diventano progressivamente peggiori perché il mondo è cambiato rispetto ai dati di training. È il fenomeno del drift, e non genera nessun errore nei log.
Il monitoraggio minimo ha due strati. Il primo è operativo: latenza delle risposte, tasso di errori, richieste al secondo — quello che monitoreresti per qualunque servizio web. Il secondo è statistico: la distribuzione degli input che arrivano e delle predizioni che escono. Se il modello di scoring clienti riceveva età medie di 40 anni e ora riceve 25, qualcosa a monte è cambiato e le performance vanno riverificate. Anche solo loggare input e output su file, e guardarli con uno script settimanale, è infinitamente meglio di niente.
Il percorso, tutto insieme
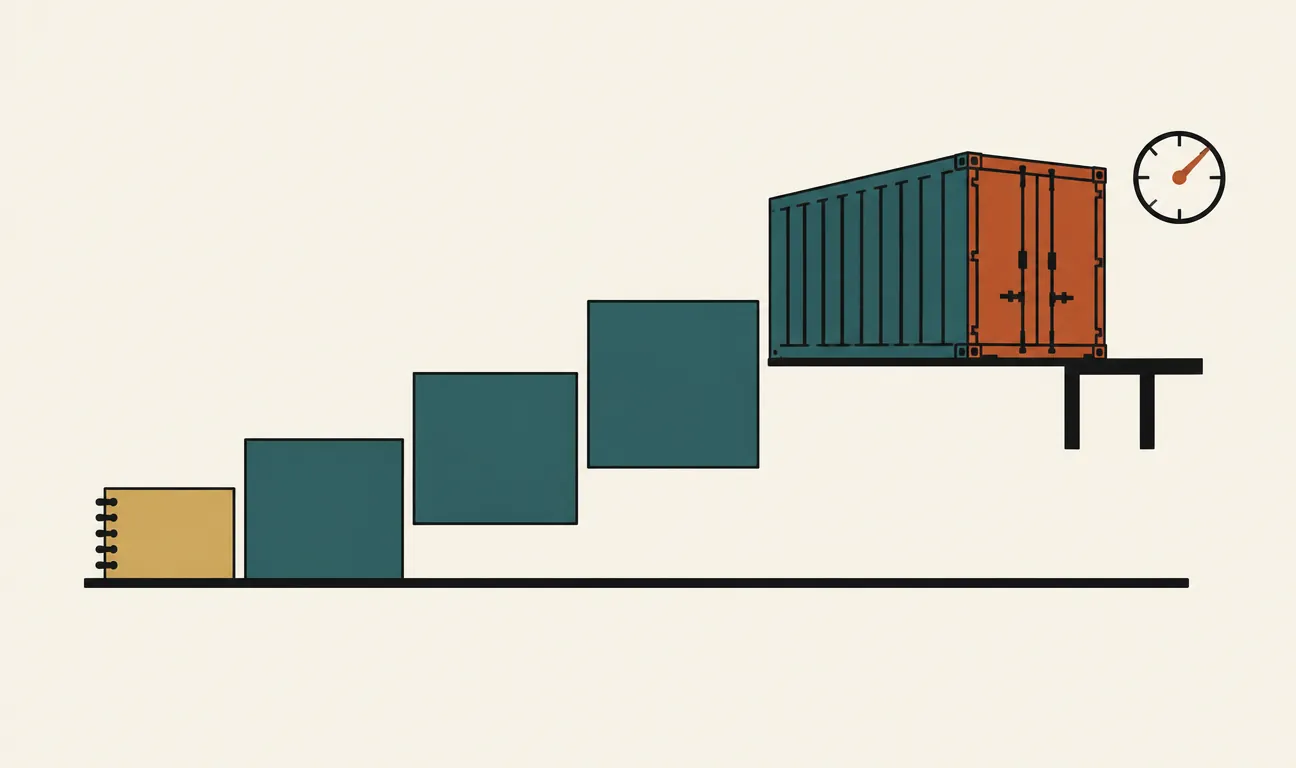
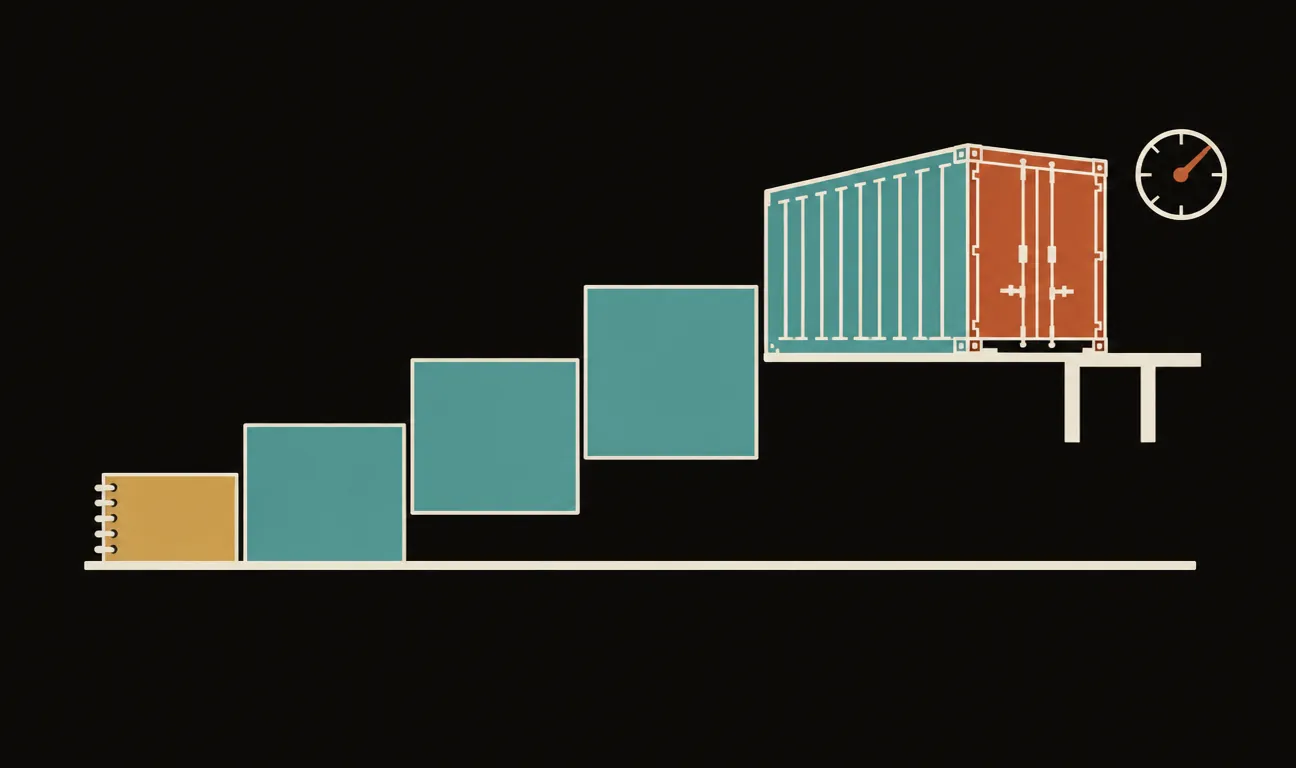
Il percorso minimo dev→prod: dal notebook agli script versionati, poi API, container e produzione monitorata. La linea tratteggiata è il ciclo di feedback che riporta all’esplorazione.
Notare cosa manca dallo schema: Kubernetes, feature store, orchestratori di pipeline, piattaforme MLOps enterprise. Non perché siano inutili — a una certa scala diventano necessari — ma perché adottarli prima di averne bisogno significa mantenere infrastruttura invece di risolvere il problema. Ogni tappa del percorso minimo, invece, ripaga da subito.
Perché ti riguarda
Se lavori con i dati, la distanza tra «il modello funziona» e «il modello è in produzione» è la distanza tra un esercizio e un risultato. Le aziende sono piene di notebook con ottime accuratezze che non hanno mai preso una decisione reale. Saper percorrere queste cinque tappe — script, versionamento, API, container, monitoraggio — è una competenza più rara, e spesso più pagata, dell’ennesimo punto percentuale di accuratezza. E se sei dall’altra parte, e devi valutare un progetto di machine learning, la domanda giusta non è «quanto è bravo il modello?» ma «qual è il piano per fargli attraversare il fosso?».
I commenti sono riservati agli iscritti.
Accedi per commentare