
Prendete un manuale di machine learning stampato prima del 2019 e cercate il capitolo sull’overfitting. Troverete sempre lo stesso grafico: una curva a U. Modello troppo piccolo, errore alto; modello della taglia giusta, errore minimo; modello troppo grande, errore che risale, perché la rete impara a memoria il rumore invece della regola. Da quel grafico discende un consiglio pratico ripetuto per decenni: fermatevi al fondo della U. Poi qualcuno ha fatto la cosa che il manuale sconsigliava — ha continuato a ingrandire il modello, oltre il punto in cui memorizza perfettamente ogni esempio di training — e ha visto l’errore sul test set scendere di nuovo. Non un artefatto, non un caso fortunato: un fenomeno riproducibile, oggi noto come double descent, la doppia discesa. E la teoria classica non lo aveva previsto.
Il patto classico: bias contro varianza
Per capire perché la doppia discesa è sorprendente, serve prima il patto che infrange. La statistica classica descrive l’apprendimento come un compromesso tra due errori. Il bias è l’errore di un modello troppo rigido: come un sarto che confeziona tutte le giacche nella stessa taglia, sbaglia su quasi tutti i clienti perché la sua regola è troppo semplice. La varianza è l’errore opposto: il sarto che cuce una giacca aderente al millimetro su un singolo cliente, comprese le pieghe della camicia che indossava quel giorno. Su quel cliente, quel giorno, la giacca è perfetta; su chiunque altro è inservibile.
Il modello ideale, dice la teoria, sta nel mezzo: abbastanza flessibile da catturare la regola, non così flessibile da cucirsi addosso il rumore. Aumentando la capacità del modello — più parametri, più libertà — il bias scende e la varianza sale, e la loro somma disegna la famosa U. Il punto critico è quello in cui il modello diventa capace di interpolare: azzerare l’errore di training memorizzando ogni singolo esempio, rumore incluso. Oltre quella soglia, sosteneva il manuale, c’è solo memorizzazione sterile.
La curva che riscende
Nel 2019 Mikhail Belkin e colleghi pubblicano su PNAS un articolo dal titolo programmatico: «Reconciling modern machine-learning practice and the classical bias–variance trade-off». La loro osservazione: se si continua ad aumentare la capacità del modello oltre la soglia di interpolazione, l’errore di test smette di salire e ricomincia a scendere. La U classica è solo la prima metà del disegno. La curva completa sale fino a un picco proprio in corrispondenza della soglia — il punto peggiore in assoluto — e poi digrada in un secondo regime, quello sovraparametrizzato, dove modelli enormi generalizzano bene pur avendo errore di training pari a zero.
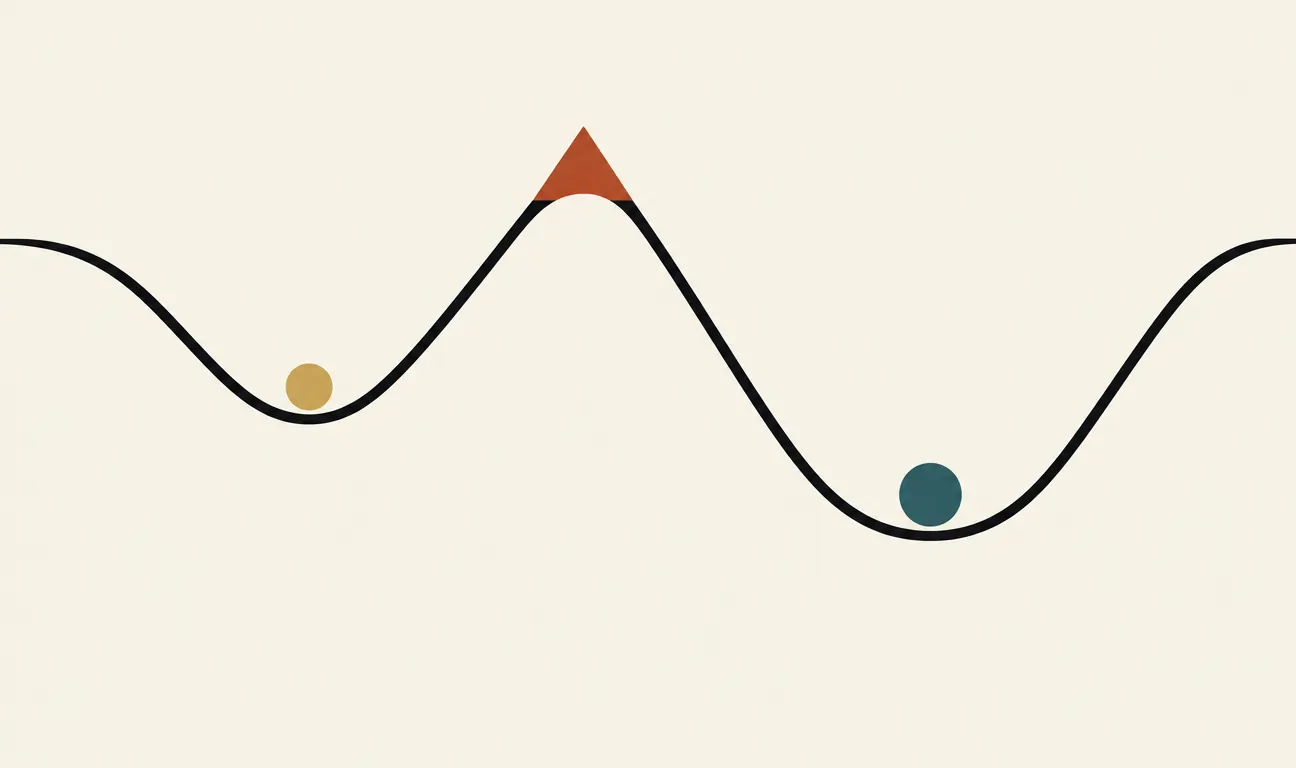
La curva del double descent. Nel regime classico l’errore di test disegna la U dei manuali; alla soglia di interpolazione — dove l’errore di training tocca lo zero — il test tocca il suo massimo; oltre, nel regime sovraparametrizzato, l’errore di test riscende, spesso sotto il minimo classico.
Il picco alla soglia ha una spiegazione intuitiva. In quel punto il modello ha esattamente la capacità che serve per memorizzare i dati: non un grammo di più. Per riuscirci è costretto a contorsioni estreme, come un ospite che deve far entrare tutto il guardaroba in una valigia della misura esatta: ci riesce, ma solo comprimendo, piegando e forzando ogni cosa. Il risultato è una funzione che passa per tutti i punti di training con oscillazioni selvagge tra un punto e l’altro — e su dati nuovi quelle oscillazioni sono errore puro.
Perché la seconda discesa: l’interpolazione gentile
Il vero enigma non è il picco, è la discesa che segue. Se memorizzare i dati è male, perché un modello che li memorizza con margine abbondante generalizza bene?
La risposta emersa dalla ricerca ruota attorno a un’idea: quando i modi di interpolare i dati sono tantissimi, il modello può scegliere il più semplice. Immaginate di dover far passare una striscia di metallo attraverso una serie di chiodi piantati su una tavola. Se la striscia è lunga appena quanto basta, dovete piegarla con violenza a ogni chiodo: il percorso risultante è pieno di angoli bruschi. Se la striscia è molto più lunga del necessario, può attraversare tutti i chiodi con curve dolci e ampie. Più capacità non significa più contorsioni: significa libertà di non contorcersi.
Nei modelli sovraparametrizzati esiste un intero spazio di soluzioni che azzerano l’errore di training, e l’algoritmo di ottimizzazione non le sceglie a caso. La discesa del gradiente, per come è fatta, tende a fermarsi sulle soluzioni a «norma minima» — le più piatte, le meno oscillanti tra i punti. È una forma di regolarizzazione implicita: nessuno l’ha programmata, è una proprietà emergente della dinamica di training. Il modello gigante memorizza sì ogni esempio, ma lo fa nel modo più liscio possibile, e la lisciezza è proprio ciò che serve per generalizzare.
Il double descent non dice che l’overfitting non esiste. Dice che tra «memorizzare a fatica» e «memorizzare con eleganza» c’è una differenza che la teoria classica non misurava.
Non solo la taglia del modello
La storia si complica — e si fa più interessante — con il lavoro di Preetum Nakkiran e colleghi («Deep Double Descent», 2019), che mostra come il fenomeno non riguardi solo il numero di parametri. Esiste un double descent rispetto alle epoche: a parità di modello, l’errore di test può scendere, risalire e riscendere man mano che il training procede. Ed esiste, in certe condizioni, un effetto controintuitivo legato ai dati: vicino alla soglia di interpolazione, aggiungere esempi di training può temporaneamente peggiorare l’errore di test, perché sposta la soglia e può riportare il modello proprio sul picco.
Quest’ultimo punto merita di essere riletto due volte: più dati che fanno peggio. Non sempre, non di molto, e solo in una finestra precisa di regime — ma abbastanza da demolire l’idea che «più dati è sempre meglio» sia una legge senza eccezioni. Lo stesso studio mostra che il rumore nelle etichette amplifica il picco: più i dati sono sporchi, più il passaggio per la soglia di interpolazione è doloroso, perché memorizzare rumore con capacità appena sufficiente è il peggior compito possibile.
Quello che ancora non torna
Onestà intellettuale: il double descent è un fenomeno osservato e riprodotto, non un fenomeno pienamente spiegato. Per i modelli lineari e per alcune architetture semplificate esistono derivazioni matematiche precise di quando e perché la curva riscende. Per le reti profonde reali, le spiegazioni — regolarizzazione implicita, soluzioni a norma minima, «benign overfitting» — sono convincenti ma parziali: descrivono meccanismi plausibili senza costituire una teoria predittiva completa. Non sappiamo ancora calcolare in anticipo dove cadrà la soglia per una data architettura su un dato problema, né quanto profonda sarà la seconda discesa.
È una situazione scientificamente scomoda e affascinante: la pratica ha superato la teoria. I modelli linguistici con centinaia di miliardi di parametri vivono stabilmente nel regime sovraparametrizzato, e funzionano — mentre la teoria che dovrebbe spiegare perché funzionano sta ancora recuperando terreno.
Perché ti riguarda
Se addestri modelli, il double descent cambia due riflessi pratici. Primo: un modello che sembra «troppo grande per i tuoi dati» non è automaticamente condannato all’overfitting — può darsi che tu stia guardando il picco della curva, e che la strada giusta sia più capacità, non meno. Secondo: quando confronti architetture di taglia diversa, sappi che vicino alla soglia di interpolazione i risultati sono instabili per costruzione; è la zona peggiore dove trarre conclusioni.
E se i modelli li usi soltanto, il double descent spiega una cosa che altrimenti resterebbe un paradosso: perché l’industria costruisca modelli sempre più grandi invece di fermarsi alla taglia «giusta» dei manuali. Non è forza bruta irrazionale — è che oltre il picco, contro ogni intuizione classica, la strada torna in discesa. Chi vuole approfondire parta dai due lavori citati: l’articolo di Belkin, Hsu, Ma e Mandal su PNAS (2019) e «Deep Double Descent: Where Bigger Models and More Data Hurt» di Nakkiran, Kaplun, Bansal, Yang, Barak e Sutskever (arXiv:1912.02292).
I commenti sono riservati agli iscritti.
Accedi per commentare