
Nel 2012 due studenti di Toronto, Alex Krizhevsky e Ilya Sutskever, addestrano una rete neurale su due schede grafiche da videogiochi comprate al prezzo di un computer portatile. La rete — che oggi conosciamo come AlexNet — stravince la competizione di riconoscimento immagini ImageNet, con un margine sul secondo classificato così ampio da sembrare un errore di misura. La parte curiosa è che l’architettura non conteneva quasi nulla di concettualmente nuovo: reti convoluzionali simili esistevano da quindici anni. Quello che era cambiato non era la matematica. Era il silicio.
Perché il parallelismo conta più della velocità del singolo core, e perché il collo di bottiglia è muovere i dati: nel libro.
La storia del deep learning è spesso raccontata come una successione di intuizioni geniali. È una lettura incompleta. È anche — forse soprattutto — la storia di un’idea rimasta in frigorifero per decenni, in attesa che l’hardware la raggiungesse.
Un’idea vecchia di settant’anni
Il perceptron di Frank Rosenblatt è del 1958: un neurone artificiale che impara a classificare aggiustando pesi numerici. L’algoritmo di backpropagation, che permette di addestrare reti a più strati, viene reso popolare da Rumelhart, Hinton e Williams nel 1986. Nel 1998 Yann LeCun pubblica LeNet-5, una rete convoluzionale che legge le cifre scritte a mano sugli assegni bancari americani. Gli ingredienti fondamentali dell’AI moderna, insomma, erano tutti sul tavolo prima del 2000.
Eppure per tutti gli anni Novanta e i primi Duemila le reti neurali restano una nicchia accademica, spesso guardata con sospetto. I metodi «classici» — SVM, alberi di decisione, modelli statistici — le battevano regolarmente sui benchmark. Il motivo era brutalmente pratico: una rete neurale diventa potente solo quando è grande e vede molti dati, ma addestrare una rete grande su molti dati, con le CPU dell’epoca, richiedeva settimane o mesi. Nessuno può fare ricerca seria quando ogni esperimento dura un trimestre.
Il collo di bottiglia è la moltiplicazione
Per capire perché serviva un hardware diverso bisogna guardare cosa fa davvero una rete neurale durante l’addestramento: moltiplica matrici. Quasi tutto il tempo di calcolo, sia in avanti (predizione) sia all’indietro (aggiornamento dei pesi), è speso in prodotti tra matrici enormi.
Una CPU è progettata per fare bene tutt’altro: eseguire velocemente una sequenza di operazioni diverse, con salti, condizioni, imprevisti. È un artigiano bravissimo, che completa un pezzo alla volta. Ma la moltiplicazione tra matrici non ha bisogno di un artigiano: è composta da milioni di piccole operazioni identiche e indipendenti tra loro, che si possono fare tutte insieme. Serve una catena di montaggio con migliaia di postazioni parallele, dove ogni postazione fa lo stesso gesto elementare.
Quella catena di montaggio esisteva già, ed era stata costruita per un motivo che con la scienza non c’entrava nulla: i videogiochi. Disegnare una scena 3D significa calcolare colore e posizione di milioni di pixel, tutti con la stessa formula, tutti indipendenti l’uno dall’altro. Le GPU erano nate esattamente per questo. Che il rendering grafico e l’addestramento di una rete neurale fossero, dal punto di vista del silicio, quasi lo stesso problema è una delle coincidenze più fortunate della storia dell’informatica.
2007: le GPU si aprono al calcolo generico
Il punto di svolta infrastrutturale arriva nel 2007, quando NVIDIA rilascia CUDA, una piattaforma che permette di programmare le GPU per calcoli generici, non solo per la grafica. Prima di CUDA, usare una scheda video per fare scienza era un esercizio di contorsionismo: bisognava travestire i propri dati da triangoli e texture. Dopo, diventa questione di scrivere codice quasi normale.
Tra il 2009 e il 2011 alcuni gruppi di ricerca iniziano a pubblicare risultati di reti neurali addestrate su GPU, con accelerazioni di uno o due ordini di grandezza rispetto alle CPU. Un esperimento che richiedeva settimane ora richiede ore. E qui scatta qualcosa di più sottile della semplice velocità: cambia il ritmo della ricerca. Un ricercatore che può provare dieci idee al giorno invece di una al mese non è dieci volte più produttivo — è un ricercatore che fa un mestiere diverso, in cui l’intuizione si può verificare subito e l’errore costa poco.
Il deep learning non ha vinto quando qualcuno ha avuto l’idea giusta. Ha vinto quando provare le idee è diventato abbastanza economico da poter sbagliare spesso.
2012: la dimostrazione che nessuno può ignorare
AlexNet mette insieme tutti i pezzi: una rete convoluzionale profonda (concetto degli anni Novanta), un dataset enorme come ImageNet (oltre un milione di immagini etichettate) e due GPU consumer su cui l’addestramento, pur durando giorni, resta alla portata di un laboratorio universitario. Il risultato — un tasso di errore top-5 intorno al 15%, contro il 26% circa del secondo classificato — chiude la discussione. Nel giro di due anni praticamente tutti i partecipanti a ImageNet usano reti profonde, e praticamente tutti le addestrano su GPU.
Da lì la dinamica si autoalimenta. I produttori di hardware, visto il mercato, iniziano a progettare chip pensati per le reti neurali: unità dedicate alla moltiplicazione di matrici, precisione numerica ridotta (16 bit invece di 32) per raddoppiare la velocità, memoria ad altissima banda. I ricercatori, visto l’hardware, progettano modelli sempre più grandi. Il Transformer del 2017 — l’architettura dietro gli attuali modelli linguistici — è quasi una dichiarazione d’amore alla GPU: rinuncia alla ricorrenza sequenziale delle architetture precedenti proprio per rendere il calcolo massicciamente parallelizzabile.
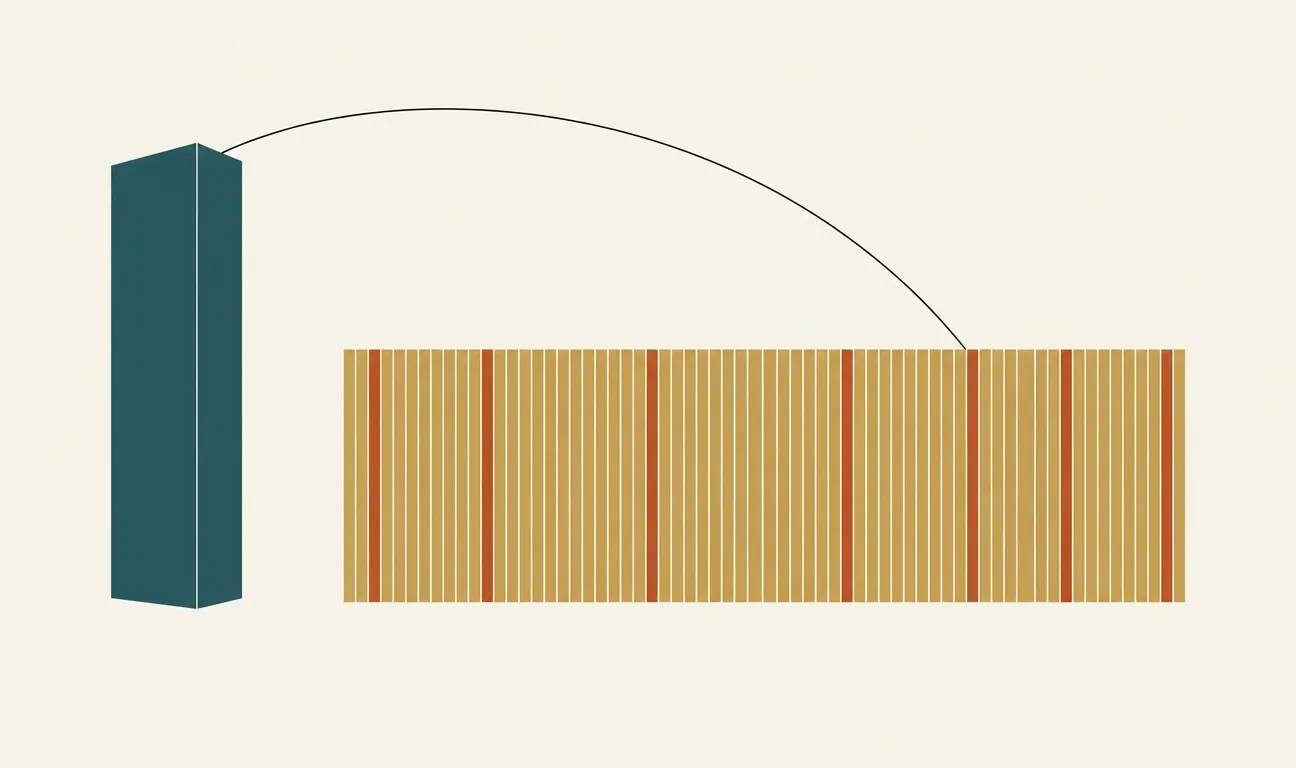
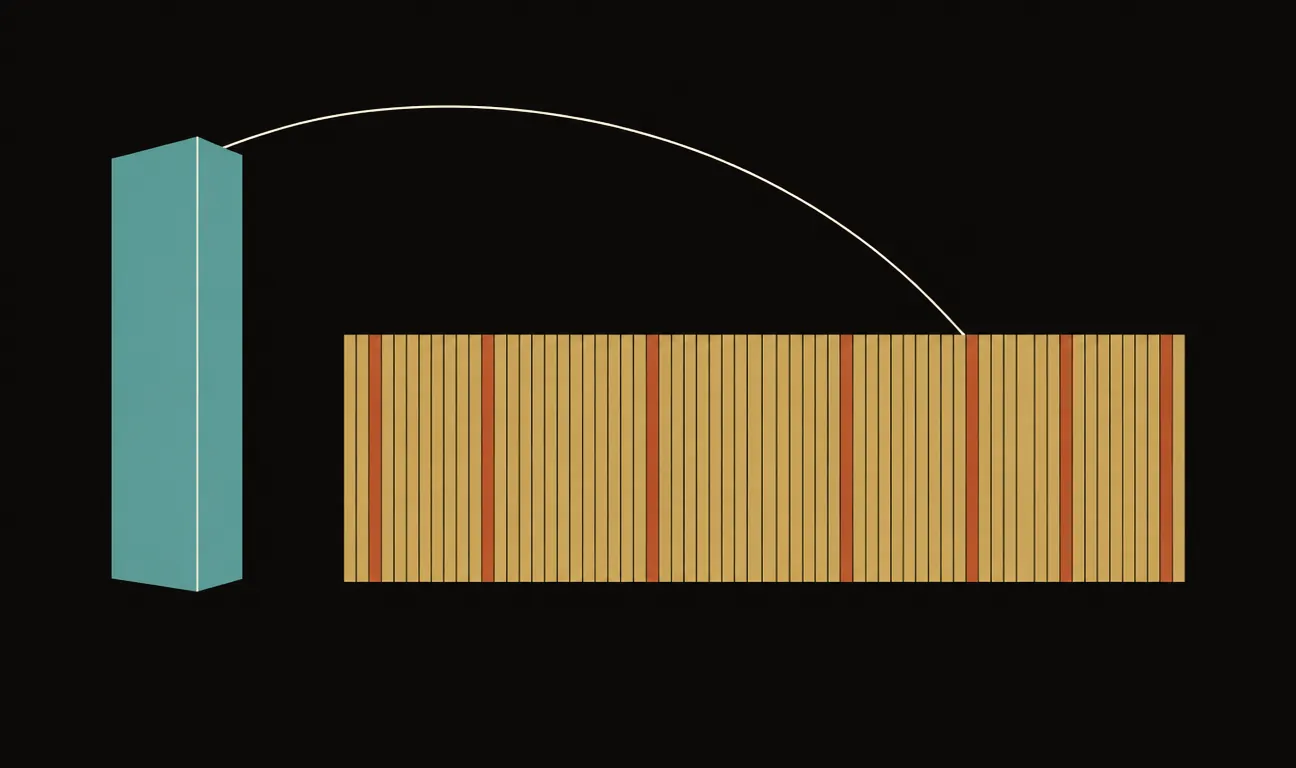
Le idee fondamentali delle reti neurali (in basso, terracotta) precedono di decenni l’hardware capace di eseguirle a scala (in alto, teal). L’incrocio avviene tra il 2007 e il 2012.
La lezione: il software insegue l’hardware
C’è una morale metodologica in questa storia, e vale oltre l’AI. Tendiamo a valutare le idee scientifiche in astratto — giuste o sbagliate, eleganti o goffe. Ma un’idea computazionale ha anche un costo di esecuzione, e quel costo decide se l’idea è verificabile. Le reti neurali negli anni Novanta non erano sbagliate: erano premature. La comunità le abbandonò per ragioni che sembravano empiriche («non funzionano meglio delle SVM») ma erano in realtà economiche («non possiamo permetterci di addestrarle abbastanza a lungo da scoprire se funzionano»).
È lo stesso schema che oggi vediamo ripetersi altrove: architetture alternative al Transformer, tecniche di addestramento più raffinate, modelli che ragionano più a lungo in fase di inferenza. Alcune di queste idee, oggi giudicate deludenti, potrebbero semplicemente aspettare il loro hardware — come le reti convoluzionali aspettavano CUDA.
Perché ti riguarda
Se lavori con l’AI, o stai decidendo se impararla, questa storia ti dice tre cose concrete. Primo: quando leggi che un modello «non funziona», chiediti sempre se il verdetto è concettuale o economico — la differenza tra un’idea morta e un’idea in anticipo è spesso solo il prezzo del calcolo, che scende ogni anno. Secondo: le competenze che invecchiano meno sono quelle vicine al collo di bottiglia fisico; capire come i dati si muovono tra memoria e processore vale più di conoscere l’ennesimo framework. Terzo: l’attuale corsa ai chip — GPU introvabili, data center giganteschi, investimenti pubblici sui semiconduttori — non è una bolla laterale della storia dell’AI. È la storia dell’AI, che come sempre passa prima dal silicio e poi dalle idee.
I commenti sono riservati agli iscritti.
Accedi per commentare