
Aprite un notebook qualunque che addestra una rete neurale nel 2026 e, arrivati alla riga in cui si sceglie l’ottimizzatore, quasi sicuramente troverete scritta una parola sola: Adam. Non è pigrizia del programmatore: è il sedimento di dieci anni in cui questo metodo si è rivelato, sperimentalmente, quello che «funziona quasi sempre» senza troppa messa a punto. Il paper che lo introduce, firmato da Diederik P. Kingma e Jimmy Ba e messo su arXiv nel dicembre 2014, ha un titolo sobrio — Adam: A Method for Stochastic Optimization — e un’ambizione precisa: rendere l’addestramento delle reti profonde meno dipendente dalla fortuna e dalla pazienza artigianale di chi sceglie gli iperparametri.
Segnale che svanisce o esplode, inizializzazione, batch normalization, dropout e gli ottimizzatori: il capitolo è nel libro.
Un solo passo per milioni di parametri
Per capire cosa risolve Adam bisogna guardare cosa faceva la discesa del gradiente stocastica «nuda». A ogni passo si calcola il gradiente della loss — la direzione in cui i pesi andrebbero cambiati per sbagliare di meno — e si sposta ogni peso di un pezzetto in quella direzione. La lunghezza del pezzetto è il learning rate: un unico numero, valido per tutti i parametri della rete, che possono essere decine di milioni.
Qui nasce la tensione. In una rete diversa i parametri vivono situazioni diverse: alcuni ricevono gradienti grandi e rumorosi che oscillano di segno a ogni batch, altri gradienti minuscoli e rari. Un passo unico è per forza un compromesso: se lo tieni grande, i primi divergono; se lo tieni piccolo, i secondi non si muovono quasi mai. Trovare quel compromesso era, prima di Adam, mezza arte e mezza superstizione. Adam prova a cancellare il compromesso dando a ogni parametro il suo passo, e lo fa combinando due idee che circolavano già separate: la memoria della direzione e la taratura per parametro.
Il primo momento: la memoria della direzione
La prima idea è il momento (in inglese momentum). Invece di usare il gradiente grezzo dell’ultimo batch — che è rumoroso, e cambia molto da un mini-batch all’altro — Adam ne tiene una media mobile. Chiama questa media il «primo momento», indicato con m: a ogni passo la aggiorna mescolando il 90% del valore vecchio con il 10% del gradiente nuovo (il coefficiente β₁ = 0,9 nei valori di default).
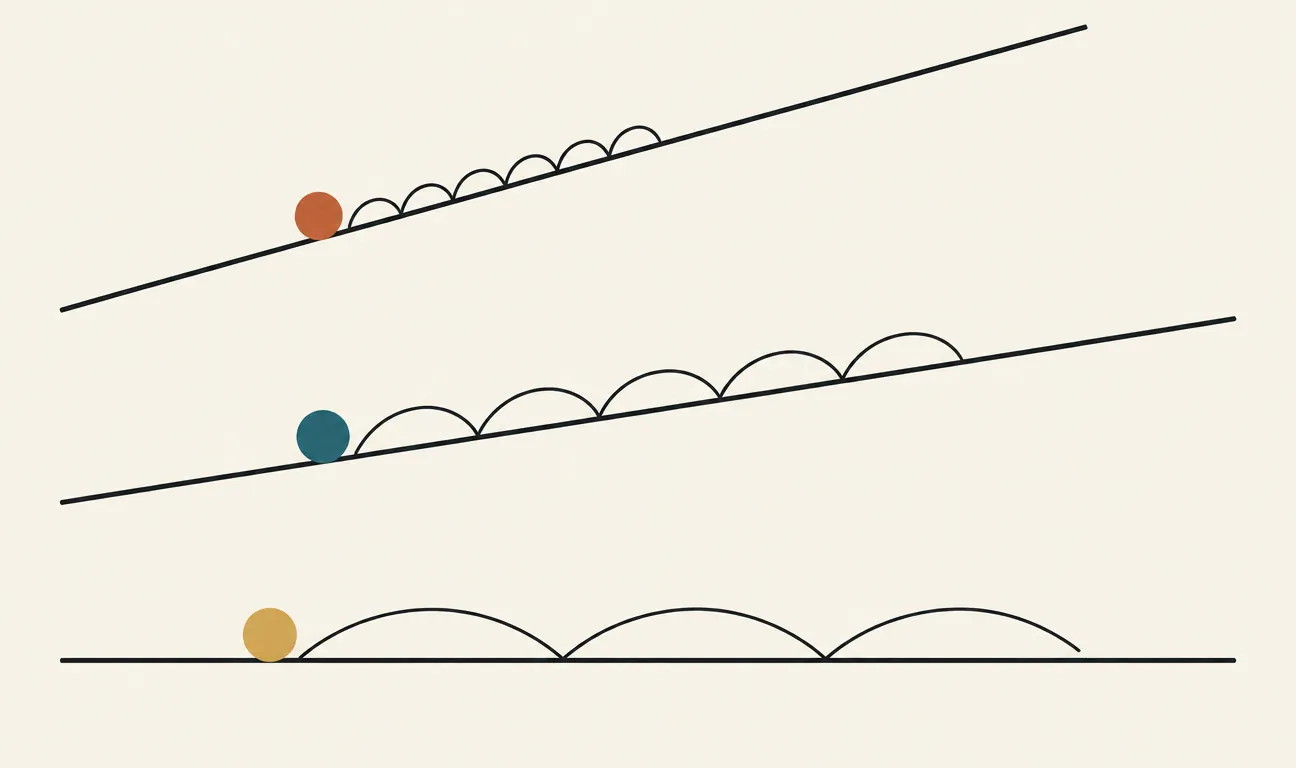
L’analogia è quella di una biglia che rotola in una valle. Una biglia non riparte da zero a ogni sassolino: accumula inerzia e prosegue nella direzione media della discesa, ignorando gli scossoni locali. Allo stesso modo m attenua il rumore e conserva la direzione dominante: se dieci batch di fila spingono più o meno da quella parte, la media si convince e avanza decisa, senza lo zigzag isterico del gradiente istantaneo.
Il secondo momento: un passo su misura
La seconda idea è la taratura per parametro, ereditata da metodi come AdaGrad e RMSProp. Adam tiene una seconda media mobile, il «secondo momento» v, ma questa volta dei gradienti al quadrato (coefficiente di default β₂ = 0,999, quindi una memoria molto più lunga). Il quadrato cancella il segno e misura una cosa sola: quanto è stato grande, in media, il gradiente di quel parametro, a prescindere dalla direzione.
A questo punto arriva la mossa chiave: il passo di ogni parametro viene diviso per la radice di v. Un parametro bombardato da gradienti grandi e ballerini ha v alto, quindi viene frenato e avanza con cautela; un parametro con gradienti piccoli e rari ha v basso, e riceve un passo relativamente più lungo. È il motivo del nome: Adam sta per adaptive moment estimation, stima adattiva dei momenti. Come una guida di montagna che non tiene un passo fisso — falcate lunghe sul pianoro, passetti prudenti sulla ghiaia — solo che qui la scelta è indipendente per ognuno dei milioni di «piedi» che camminano insieme.
A sinistra il primo momento: molti gradienti istantanei rumorosi (in grigio) vengono mediati in un unico vettore stabile m (in terracotta), l’inerzia della discesa. A destra il secondo momento: tre parametri con v diverso (barre teal) ricevono passi di lunghezza inversa — chi ha gradienti grandi viene frenato, chi li ha piccoli avanza di più.
La correzione del bias e i default che tutti usano
C’è un dettaglio tecnico che il paper cura con eleganza. All’inizio dell’addestramento m e v partono da zero, e per le prime iterazioni le loro medie mobili sono schiacciate verso il basso: sottostimano i valori veri. Kingma e Ba introducono una correzione del bias, dividendo m e v per un fattore che vale molto nei primi passi e svanisce col tempo. È una piccola contabilità che evita passi iniziali distorti e rende il metodo affidabile fin dalla prima iterazione.
Il resto sono i valori di default che il paper propone e che, in modo quasi sorprendente, sono rimasti quelli di libreria per un decennio: learning rate di base α = 0,001, β₁ = 0,9, β₂ = 0,999, e un piccolo ε (intorno a 10⁻⁸) messo al denominatore solo per non dividere mai per zero. La promessa implicita del paper — che con questi numeri Adam funzioni ragionevolmente bene «fuori dalla scatola» su una gran varietà di problemi — è la ragione principale della sua diffusione.
La forza di Adam non è aver inventato un’idea nuova, ma aver combinato due idee vecchie in una ricetta che, con i suoi default, quasi non si deve tarare.
Da Adam ad AdamW, e le crepe oneste
La storia non finisce nel 2014, e raccontarla per intero è un esercizio di onestà. Adam si è imposto, ma con delle crepe. Nel 2018 un lavoro di Reddi, Kale e Kumar (On the Convergence of Adam and Beyond, ICLR 2018) mostrò che la dimostrazione di convergenza del paper originale conteneva un difetto, e propose una variante (AMSGrad) per correggerlo. Si è anche visto che, su alcuni problemi di visione, la vecchia discesa del gradiente con momento generalizza meglio di Adam: converge più lentamente ma finisce in minimi che funzionano leggermente meglio sui dati nuovi.
Ma la modifica più importante è un’altra. Nel 2017 Ilya Loshchilov e Frank Hutter mostrarono che il modo in cui Adam gestiva il weight decay — una tecnica di regolarizzazione — era sottilmente sbagliato, e proposero AdamW, che lo «disaccoppia» dal resto dell’aggiornamento. AdamW è oggi l’ottimizzatore con cui si addestrano di fatto tutti i grandi modelli linguistici. Quando leggete che un LLM è stato addestrato «con AdamW», state leggendo la discendenza diretta di quel paper del 2014.
Perché riguarda anche chi non scriverà mai un ottimizzatore
Si può usare un modello per anni senza toccare l’ottimizzatore: è già scelto, già tarato. Ma se c’è un iperparametro che prima o poi finirete per regolare a mano quando addestrate o fate fine-tuning di qualcosa, è proprio il learning rate di Adam — l’unico numero che i default non riescono a indovinare per voi, perché dipende dal vostro problema. Capire che sotto c’è una biglia con inerzia e un passo su misura per parametro trasforma quel numero da manopola misteriosa a scelta ragionata. E rende leggibile una frase che compare in quasi ogni scheda tecnica di ogni modello moderno, dai classificatori di immagini agli LLM: «ottimizzato con Adam». Sapere cosa significa è il minimo per non prendere quella riga come magia.
Il paper
Diederik P. Kingma, Jimmy Ba, Adam: A Method for Stochastic Optimization, presentato a ICLR 2015. Disponibile su arXiv: arxiv.org/abs/1412.6980. La variante oggi standard per i grandi modelli è AdamW, descritto in Ilya Loshchilov, Frank Hutter, Decoupled Weight Decay Regularization, ICLR 2019: arxiv.org/abs/1711.05101. La revisione critica sulla convergenza è Sashank J. Reddi, Satyen Kale, Sanjiv Kumar, On the Convergence of Adam and Beyond, ICLR 2018.
I commenti sono riservati agli iscritti.
Accedi per commentare