
C’è una scena che si ripete in ogni team di data science alle prime armi. Arriva un problema — prevedere quali clienti abbandoneranno il servizio, a partire da una tabella di età, contratti, consumi, reclami — e qualcuno propone subito una rete neurale profonda, perché è quella di cui parlano tutti. Dopo due settimane di tuning, la rete arriva faticosamente a pareggiare un modello di gradient boosting che un collega scettico aveva addestrato in dieci minuti con i parametri di default. Non è un aneddoto isolato: è quello che continua a succedere, con regolarità, ogni volta che i dati hanno la forma di un foglio di calcolo.
Che cosa vuol dire «imparare» per una macchina, i tre modi di farlo e il flusso dall’idea al modello: nel libro.
Il deep learning ha ridefinito cosa è possibile con immagini, audio e linguaggio. Ma dedurne che sia lo strumento migliore per qualsiasi problema è un errore di categoria diffuso. Su un’ampia fascia di casi reali — probabilmente la maggioranza di quelli che un’azienda incontra — i metodi che chiamiamo «classici», nati tra gli anni Novanta e i primi Duemila, restano la scelta più sensata. Vale la pena capire perché, senza nostalgia e senza tifo.
Il regno dei dati tabellari
La distinzione che conta non è la data di nascita dell’algoritmo, ma la forma dei dati. I dati tabellari — righe che sono esempi, colonne che sono attributi eterogenei — hanno una natura ostile alle reti neurali, e amichevole verso gli alberi di decisione. In una tabella, la colonna «codice postale», quella «reddito annuo» e quella «ha un contratto attivo (sì/no)» non hanno nulla in comune: unità diverse, scale diverse, significati diversi. Non c’è vicinanza spaziale come tra due pixel adiacenti, né ordine sequenziale come tra due parole in una frase. Sono variabili senza geografia.
Uno studio presentato a NeurIPS 2022 da Léo Grinsztajn e colleghi ha messo alla prova questa impressione su decine di dataset tabellari, con una domanda diretta nel titolo: perché i modelli ad alberi battono ancora il deep learning? Le ragioni che isolano sono istruttive. Le reti neurali tendono a preferire funzioni lisce, e faticano quando la relazione vera è fatta di salti bruschi — esattamente ciò che un albero, con le sue soglie nette del tipo «se reddito > 30.000», cattura senza sforzo. Sono inoltre più fragili di fronte a colonne inutili, che nei dati reali abbondano, mentre gli alberi le ignorano semplicemente non scegliendole. E la loro simmetria interna, che le rende agnostiche a come sono orientati i dati, è un dono nelle immagini e un difetto nelle tabelle, dove ogni colonna ha un’identità precisa che non va mescolata con le altre.
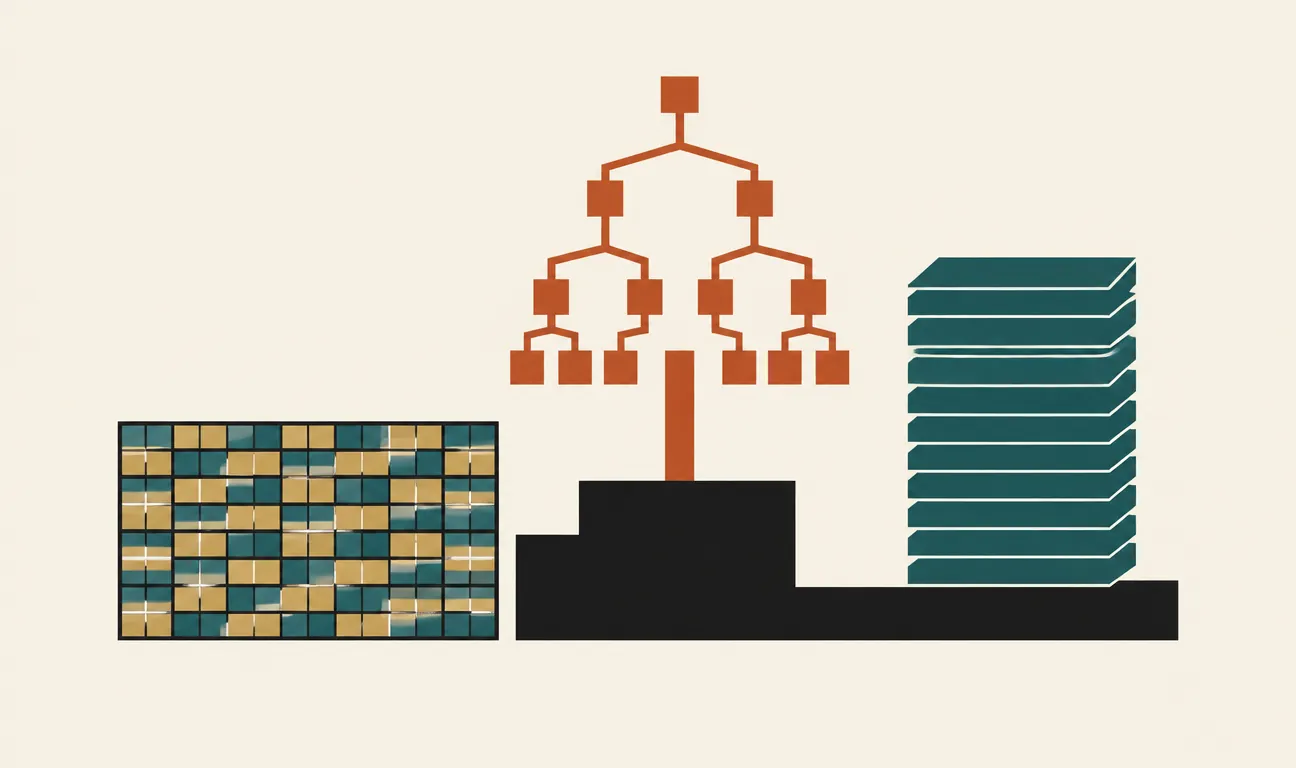
A sinistra una tabella: colonne eterogenee, senza vicinanza né ordine, dove gli alberi con le loro soglie nette prosperano. A destra pixel, onde sonore e sequenze di parole: strutture percettive che il deep learning è costruito per sfruttare. La forma dei dati decide lo strumento.
Pochi dati, molte spiegazioni da dare
C’è un secondo fronte su cui il ML classico resta avanti: la scarsità. Le reti profonde hanno fame, e danno il meglio quando i dati si contano a milioni. Ma buona parte dei problemi reali vive nel regime opposto: qualche migliaio di righe, a volte qualche centinaio. Un ospedale che vuole prevedere le riammissioni non ha milioni di pazienti; ha quelli che ha. In questo territorio, un modello con pochi parametri e assunzioni chiare — una regressione logistica, una random forest — generalizza meglio e non richiede l’artiglieria di regolarizzazioni e trucchi necessaria a impedire a una rete di imparare a memoria.
A questo si aggiunge una richiesta che in molti contesti non è negoziabile: la spiegabilità. Una banca che nega un prestito, in Europa, deve poter dire perché; un medico vuole sapere quali fattori pesano su una previsione, non riceverla come un verdetto. Una regressione lineare espone i suoi coefficienti; un albero si legge come un diagramma di flusso; una random forest offre almeno una classifica di importanza delle variabili. Una rete profonda, no: la trasparenza va estratta a posteriori, con strumenti approssimati e fragili. Quando la decisione deve reggere in tribunale o al letto del paziente, un modello un po’ meno accurato ma leggibile è spesso preferibile a uno più bravo e muto.
La domanda giusta non è quale modello sia più potente in assoluto, ma quale sia adeguato alla forma dei dati, alla loro quantità e al conto che dovremo rendere di ogni decisione.
Dove il deep learning vince davvero
Nessuna difesa del ML classico regge se non riconosce dove finisce il suo dominio. Appena i dati smettono di essere una tabella e diventano percettivi — pixel di un’immagine, campioni di un suono, parole in sequenza — la situazione si ribalta completamente. Qui la struttura è tutto: due pixel vicini sono probabilmente correlati, una parola dipende da quelle che la precedono, e questa geometria nascosta è ricchissima di informazione. Le reti profonde sono costruite apposta per scoprirla e sfruttarla, strato dopo strato, imparando da sole le caratteristiche rilevanti invece di riceverle preconfezionate.
Su questi dati il ML classico non ha storia, e per una ragione precisa: richiederebbe che un umano descrivesse a mano le feature — i contorni di un volto, le formanti di una vocale — un lavoro che le reti fanno automaticamente e infinitamente meglio. Riconoscimento di immagini, traduzione, sintesi vocale, i modelli linguistici: sono tutti territori dove chiedere a una random forest di competere non ha senso. La lezione non è che un paradigma abbia sconfitto l’altro, ma che i due abitano continenti diversi.
Perché ti riguarda
La conseguenza pratica è liberatoria, soprattutto se stai imparando. Non devi inseguire l’architettura più recente per affrontare un problema serio: devi prima guardare la forma dei tuoi dati. Se hai una tabella — e la maggior parte dei problemi aziendali produce tabelle — parti da un modello ad alberi e da una baseline onesta, prima di giustificare qualcosa di più pesante. Risparmierai settimane di tuning, otterrai un modello che sai spiegare, e consumerai una frazione dell’energia elettrica. Il deep learning resta uno strumento straordinario, ma è uno strumento, non un obbligo. La competenza vera, in questo campo, non è saper usare il modello più grande: è scegliere quello giusto, e avere la disciplina di preferire il semplice quando il semplice basta.
I commenti sono riservati agli iscritti.
Accedi per commentare