
Nel settembre 2009 Netflix consegnò un assegno da un milione di dollari a una squadra che non aveva costruito un algoritmo, ma un’orchestra. La soluzione vincente del Netflix Prize — la gara che chiedeva di migliorare del 10% il sistema di raccomandazione dei film — non era un modello brillante e solitario. Era la miscela pesata di oltre cento modelli diversi, ognuno bravo a cogliere un frammento del problema, nessuno abbastanza forte da vincere da solo. Messi insieme, hanno battuto tutti. È la lezione più controintuitiva del machine learning applicato: spesso conviene rinunciare a cercare il modello perfetto e imparare, invece, a far votare tanti modelli imperfetti.
L’albero decisionale, perché da solo è ballerino, e come Random Forest e boosting lo correggono: nel libro.
La giuria del marchese
L’intuizione ha più di due secoli. Nel 1785 il marchese di Condorcet, matematico e rivoluzionario francese, si chiese quando conviene affidare una decisione a una giuria anziché a un giudice unico. La sua risposta, oggi nota come teorema della giuria, è sorprendentemente netta: se ogni giurato decide in modo indipendente dagli altri ed è nel giusto con probabilità anche solo di poco superiore a una moneta lanciata — diciamo il 55% — allora la probabilità che la maggioranza abbia ragione cresce verso la certezza man mano che si aggiungono giurati. Un singolo votante al 55% è poco più di un caso fortunato; mille votanti al 55% che decidono a maggioranza sbagliano quasi mai.
Sostituisci «giurato» con «modello» e hai la teoria dell’ensemble in una frase. Un weak learner, un modello debole, è esattamente il giurato di Condorcet: qualcosa che fa appena meglio del caso. Preso da solo non serve a niente. Ma se ne addestri molti e li fai votare, gli errori individuali — che vanno un po’ di qua e un po’ di là — tendono a cancellarsi, mentre il segnale vero, quello su cui i modelli concordano, sopravvive all’aggregazione.
Due malattie, due cure diverse
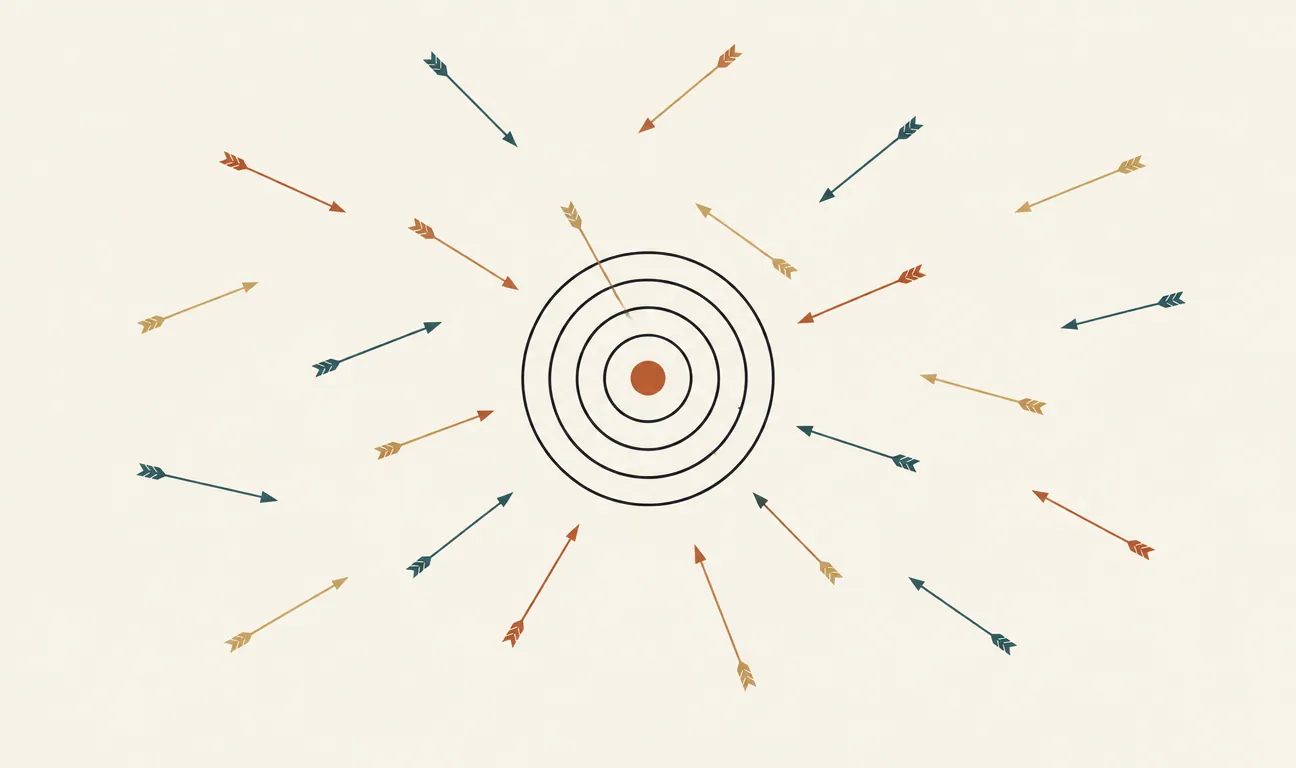
Perché un modello sbaglia? Per due ragioni distinte, che conviene tenere separate come un arciere che manca il bersaglio. Può mancarlo perché mira sistematicamente storto — tutte le frecce finiscono in alto a sinistra: è il bias, un errore di modello troppo rigido. Oppure può mirare al centro ma con mano tremante — le frecce si sparpagliano tutto intorno al bersaglio: è la varianza, la sensibilità eccessiva al campione specifico di addestramento.
Gli ensemble curano queste due malattie con strategie opposte, e capire quale si sta usando è metà del mestiere. Fare la media di tante frecce sparpagliate le riporta verso il centro: ecco perché mediare modelli ad alta varianza li stabilizza. Ma se tutte le frecce puntano storte nello stesso modo, mediarle non serve: restano storte. Per correggere il bias serve un’altra idea, quella di far imparare ogni modello dagli errori del precedente.
Tre modi di fare squadra
Da queste due cure discendono le tre grandi famiglie di ensemble che si incontrano nella pratica.
- Bagging (dal quale nasce la random forest): si addestrano molti modelli in parallelo, ognuno su una versione leggermente diversa dei dati, e si media. È la cura per la varianza: prende modelli instabili — tipicamente alberi profondi — e li placa facendoli votare. I componenti sono intercambiabili, come testimoni indipendenti dello stesso incidente.
- Boosting (AdaBoost, gradient boosting, XGBoost): i modelli si addestrano in sequenza, e ognuno si concentra sugli esempi che i precedenti hanno sbagliato, dando loro più peso. È la cura per il bias: parte da modelli deliberatamente semplici — spesso alberi di una sola domanda — e li accumula finché l’errore residuo si assottiglia. Non sono testimoni indipendenti, ma una staffetta in cui ciascuno raccoglie dove l’altro ha lasciato.
- Stacking: si addestrano modelli anche molto diversi tra loro — un albero, una regressione, una rete neurale — e poi si aggiunge un ulteriore modello, il meta-learner, il cui unico compito è imparare come pesare le loro risposte. È la strategia del Netflix Prize: non un voto democratico, ma un direttore d’orchestra che sa quando fidarsi di quale strumento.
Cinque modelli deboli, ciascuno appena sopra il lancio di moneta, votano su uno stesso input. Presi da soli valgono poco; aggregati, l’accuratezza collettiva sale ben oltre quella di ognuno. La condizione è che sbaglino in modo indipendente.
La condizione che tutti dimenticano
C’è una parola nascosta nel teorema di Condorcet che rovina tutto se la si ignora: indipendenti. La magia dell’aggregazione funziona solo se gli errori dei modelli sono scorrelati. Se tutti i giurati hanno letto lo stesso giornale e ripetono la stessa opinione, aggiungerne mille non aumenta la saggezza della giuria: è come chiedere la stessa cosa alla stessa persona mille volte. Cento modelli identici valgono, ai fini della decisione, quanto un modello solo.
Un ensemble non guadagna forza dal numero dei suoi modelli, ma dalla varietà dei loro errori. Cento copie della stessa opinione restano un’opinione sola; la diversità è l’unico ingrediente che non si può falsificare.
Ecco perché ogni buon metodo di ensemble spende energia non tanto a rendere i modelli bravi, quanto a renderli diversi. Il bagging li nutre con campioni di dati diversi; la random forest gli nasconde a caso alcune feature a ogni scelta, sabotandoli di proposito perché esplorino strade diverse; lo stacking mescola algoritmi di natura diversa. È un’inversione controintuitiva rispetto al buon senso: per costruire un predittore forte si parte dal peggiorare, deliberatamente, i suoi componenti. Il singolo modello ne esce più debole; la squadra, più varia e quindi più robusta.
Quando l’orchestra stona
Gli ensemble non sono una cura universale, e l’onestà impone di elencarne i costi. Il primo è l’interpretabilità: un albero di decisione si legge come un diagramma di flusso, cinquecento alberi no. Quando conta spiegare perché una decisione è stata presa — un prestito negato, una diagnosi — l’orchestra diventa una scatola opaca, e servono strumenti post-hoc per aprirla.
Il secondo è il rendimento decrescente: raddoppiare i modelli non raddoppia l’accuratezza. Oltre una certa soglia si aggiunge solo tempo di calcolo e latenza di predizione, perché ogni risposta deve attraversare tutti i componenti. Il terzo, più insidioso, è che l’aggregazione non crea informazione dal nulla: se tutti i modelli condividono lo stesso bias sistematico — perché ereditano lo stesso pregiudizio dai dati — il voto non lo corregge, lo conferma con convinzione. La folla è saggia solo se i suoi errori sono davvero scorrelati; quando tutti sbagliano nella stessa direzione, la media sbaglia con più sicurezza di ciascuno.
Perché ti riguarda
Il principio dell’ensemble è uno dei più fecondi e riutilizzabili del machine learning, e vale la pena interiorizzarlo anche se non addestrerai mai una random forest. Nella pratica quotidiana, se hai un problema su dati tabellari, la risposta quasi sempre giusta non è «quale modello geniale mi serve» ma «come faccio votare qualche modello onesto e diverso tra loro»: è il motivo per cui il gradient boosting domina le competizioni e le previsioni aziendali. Ma l’idea travalica il codice. Ogni volta che chiedi un secondo parere medico, che leggi tre recensioni prima di un acquisto, che una redazione fa rileggere un pezzo a più occhi, stai applicando Condorcet: fidarsi della convergenza di giudizi indipendenti più che del singolo oracolo. Il machine learning non ha inventato questa saggezza. L’ha solo resa un algoritmo.
I commenti sono riservati agli iscritti.
Accedi per commentare