
Un modello antifrode viene messo in produzione con un’accuratezza del 99% misurata sui test. Il team festeggia. Tre mesi dopo si scopre che il modello non ha mai segnalato una sola frode: si limita a rispondere «transazione legittima» a qualsiasi cosa gli venga sottoposta. E i conti tornano lo stesso, perché le frodi sono circa l’1% delle transazioni: chi dice sempre «no» indovina il 99% delle volte. Lo scenario è inventato ma il meccanismo è realissimo, ed è probabilmente l’errore più frequente di chi inizia a fare machine learning su problemi veri: le frodi, le diagnosi rare, i guasti industriali, lo spam sofisticato. Si chiama problema delle classi sbilanciate, e la sua prima vittima è la metrica più intuitiva che esista.
Matrice di confusione, precision e recall, curva ROC e AUC, e cosa fare con le classi sbilanciate: la trattazione è nel libro.
Il trucco contabile dell’accuratezza
L’accuratezza risponde a una domanda semplice: su cento predizioni, quante sono giuste? Il problema è che tratta tutti gli errori allo stesso modo e tutti gli esempi allo stesso modo. Quando una classe è il 99% del dataset, il modo più economico di massimizzare l’accuratezza è ignorare completamente l’altra classe. L’ottimizzazione lo scopre da sola: non serve malizia, basta la matematica.
L’analogia è quella di una guardia notturna valutata sul numero di notti «gestite correttamente». Se i furti avvengono una notte su cento, la guardia che dorme sempre ha una valutazione del 99% — identica sulla carta a quella di un collega scrupoloso, e assolutamente inutile nell’unica notte che conta. Il valore della guardia sta tutto nel caso raro; la metrica lo pesa come un centesimo del totale.
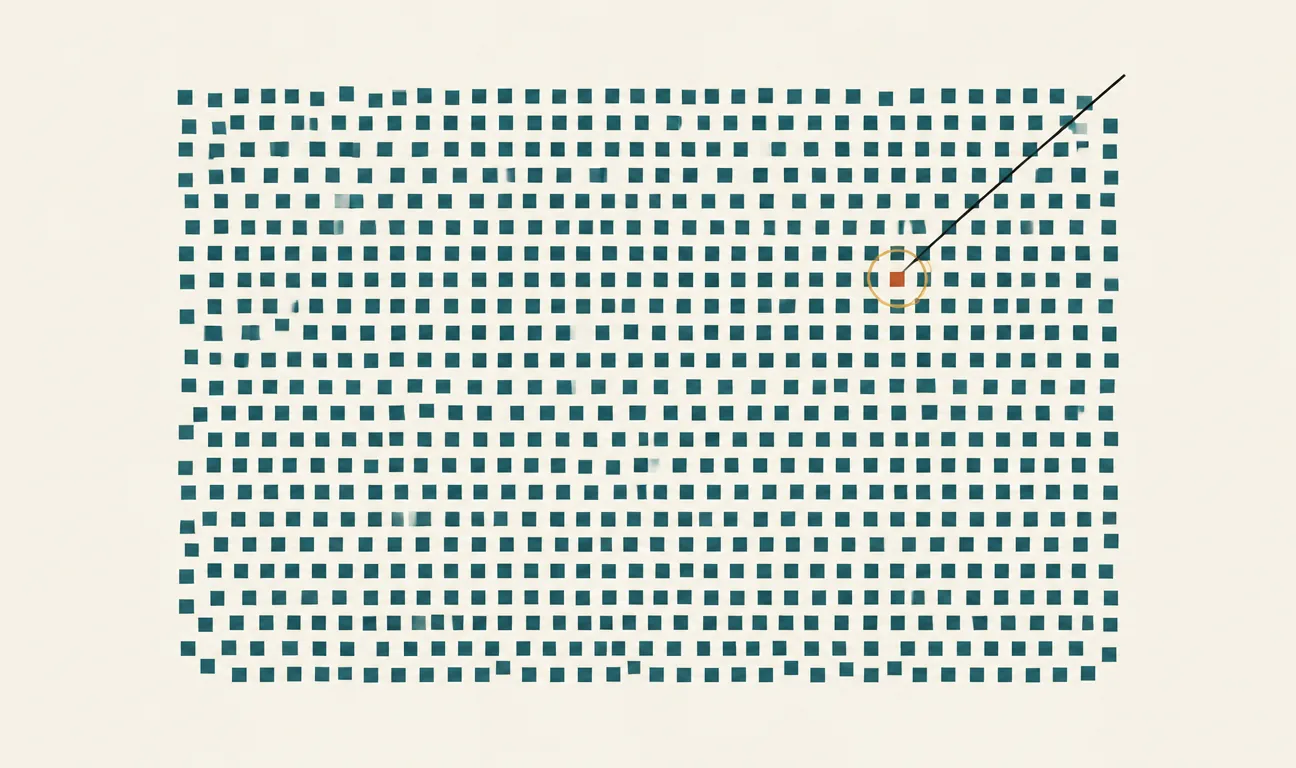
Cento esempi, un solo positivo. Il modello che risponde sempre «negativo» sbaglia una volta sola: 99% di accuracy, zero utilità.
Le metriche che non si fanno ingannare
La via d’uscita comincia dal guardare gli errori separatamente, con la matrice di confusione: quanti positivi veri il modello ha trovato, quanti ne ha mancati, quanti falsi allarmi ha generato. Da lì nascono le due metriche chiave. La recall risponde a «dei casi rari esistenti, quanti ne ho trovati?» — la guardia che dorme ha recall zero, ed è lì che il trucco si smaschera. La precision risponde a «delle volte che ho dato l’allarme, quante avevo ragione?».
Le due metriche tirano in direzioni opposte: un modello paranoico che segnala tutto ha recall perfetta e precision pessima; uno prudentissimo, il contrario. La F1, media armonica delle due, le costringe a un compromesso ed è il punto di partenza standard per problemi sbilanciati. Per una fotografia indipendente dalla soglia, la curva precision-recall è più informativa della celebre ROC, che con sbilanciamenti estremi tende a dipingere quadri troppo ottimisti.
Il valore di un modello su un problema sbilanciato sta tutto in come tratta la classe rara: è l’unica domanda che l’accuratezza non fa.
Rimettere in equilibrio i dati (con cautela)
Diagnosticato il problema, si può intervenire sui dati. L’oversampling duplica o sintetizza esempi della classe rara — la tecnica più nota, SMOTE, genera punti sintetici interpolando tra positivi vicini. L’undersampling scarta esempi della classe maggioritaria, con il costo di buttare informazione. Entrambi funzionano, ma con un’avvertenza non negoziabile: si applicano solo al training set, mai ai dati di validazione o test. Valutare un modello su un dataset artificialmente bilanciato è come provare l’abito su un manichino con le proprie misure ideali: in negozio calza benissimo, per strada no. Il test deve riflettere le proporzioni del mondo reale, perché è lì che il modello vivrà.
Rimettere in equilibrio il modello
L’alternativa, spesso più pulita, è lasciare i dati come sono e cambiare gli incentivi del modello. Quasi tutte le librerie permettono di assegnare pesi di classe: sbagliare un positivo raro costa, ad esempio, 99 volte più che sbagliare un negativo. In scikit-learn è il parametro class_weight="balanced"; nelle reti neurali si passa un peso alla loss. L’effetto è lo stesso dell’oversampling ma senza duplicare dati.
C’è poi la leva più semplice e più trascurata: la soglia di decisione. Un classificatore produce una probabilità, e il taglio a 0,5 è solo una convenzione. Su un problema sbilanciato conviene quasi sempre spostarlo — magari a 0,1 — scegliendo il punto sulla curva precision-recall che riflette i costi reali del dominio: in una diagnosi medica un caso mancato pesa molto più di un falso allarme, in un filtro antispam vale l’opposto.
Quando lo sbilanciamento è il problema sbagliato
Un’ultima onestà intellettuale: a volte il problema non è lo sbilanciamento in sé, ma la scarsità assoluta. Se i positivi sono 30 in tutto, nessuna tecnica di riequilibrio inventerà l’informazione che manca: servono più dati, oppure un riformulare il problema (anomaly detection invece di classificazione, per esempio). E se le classi rare sono anche diverse tra loro — le frodi cambiano strategia ogni mese — il modello addestrato sulle frodi di ieri sarà cieco a quelle di domani, per quanto bilanciato. Le tecniche di questo articolo curano la metrica e gli incentivi; non sostituiscono la domanda preliminare: ho abbastanza esempi del fenomeno raro, e somigliano a quelli futuri?
Perché vi riguarda
Quasi tutti i problemi di machine learning che valgono soldi o salute sono sbilanciati: la frode, il churn, il guasto, la malattia, il difetto di produzione. Il caso interessante è quasi sempre quello raro. Se costruite modelli, la checklist è breve: guardare la distribuzione delle classi prima di ogni altra cosa, bandire l’accuratezza come metrica unica, scegliere la soglia in base ai costi reali. Se invece i modelli li commissionate o li valutate, questa storia vi dà la domanda giusta da fare al prossimo fornitore che vi annuncia «99% di accuratezza»: sì, ma la recall sulla classe rara? Se la risposta tarda ad arrivare, avete appena risparmiato tre mesi di produzione.
I commenti sono riservati agli iscritti.
Accedi per commentare